プログラミングを学んでいると、リストや配列のデータを処理する際に「繰り返し処理」という言葉を頻繁に耳にします。
その中で、特にPythonやJavaScriptなどのモダンなプログラミング言語で重要視される概念が「イテラブル(Iterable)」です。
初心者の方にとって、イテラブルという言葉は少し難解に感じるかもしれませんが、その仕組みを理解することでプログラムの書き方やデータの扱い方が劇的に効率化されます。
本記事では、イテラブルの基本的な意味から、混同されやすい「イテレータ」との違い、そして具体的な活用方法までを丁寧に解説していきます。
イテラブル(Iterable)とは何か?
イテラブルとは、一言で言えば「要素を一つずつ順番に取り出すことができるオブジェクト」のことを指します。
英語の「iterable」は「繰り返すことができる」という意味を持っており、プログラミングの世界でもその通りの役割を担っています。
例えば、複数の数値が格納されたリストや、一文字ずつ分解できる文字列などは、すべてイテラブルなオブジェクトです。
私たちは日常生活の中で、本を1ページずつめくったり、名簿の名前を上から順番に確認したりすることがありますが、これらの「順番に辿れる対象」がまさにイテラブルのイメージに近いと言えるでしょう。
「反復可能」という言葉の定義
IT用語辞典などでは、イテラブルのことを「反復可能」と訳すことが一般的です。
これは、for文などのループ処理(繰り返し処理)において、その対象として指定できることを意味します。
逆に、一つの数値(整数)や単一の真偽値などは、その中身を細かく分解して順番に取り出すことができないため、イテラブルではありません。
なぜイテラブルという概念が必要なのか
プログラミングにおいて、データが「どのような形式であるか」よりも「どのように振る舞うか」が重要になる場面が多くあります。
例えば、リストであっても、集合(セット)であっても、あるいはファイルの中身であっても、「一つずつデータを取り出せる」という共通の性質があれば、同じfor文を使って処理を書くことができます。
このように、データの種類に依存せず共通の手順でループ処理を行えるようにするために、イテラブルという統一されたルール(プロトコル)が定められています。
イテラブルとイテレータの違いを理解する
イテラブルを学ぶ上で、最も多くの人がつまずくのが「イテレータ(Iterator)」との違いです。
名前が非常に似ているため混同されがちですが、これらは明確に異なる役割を持っています。
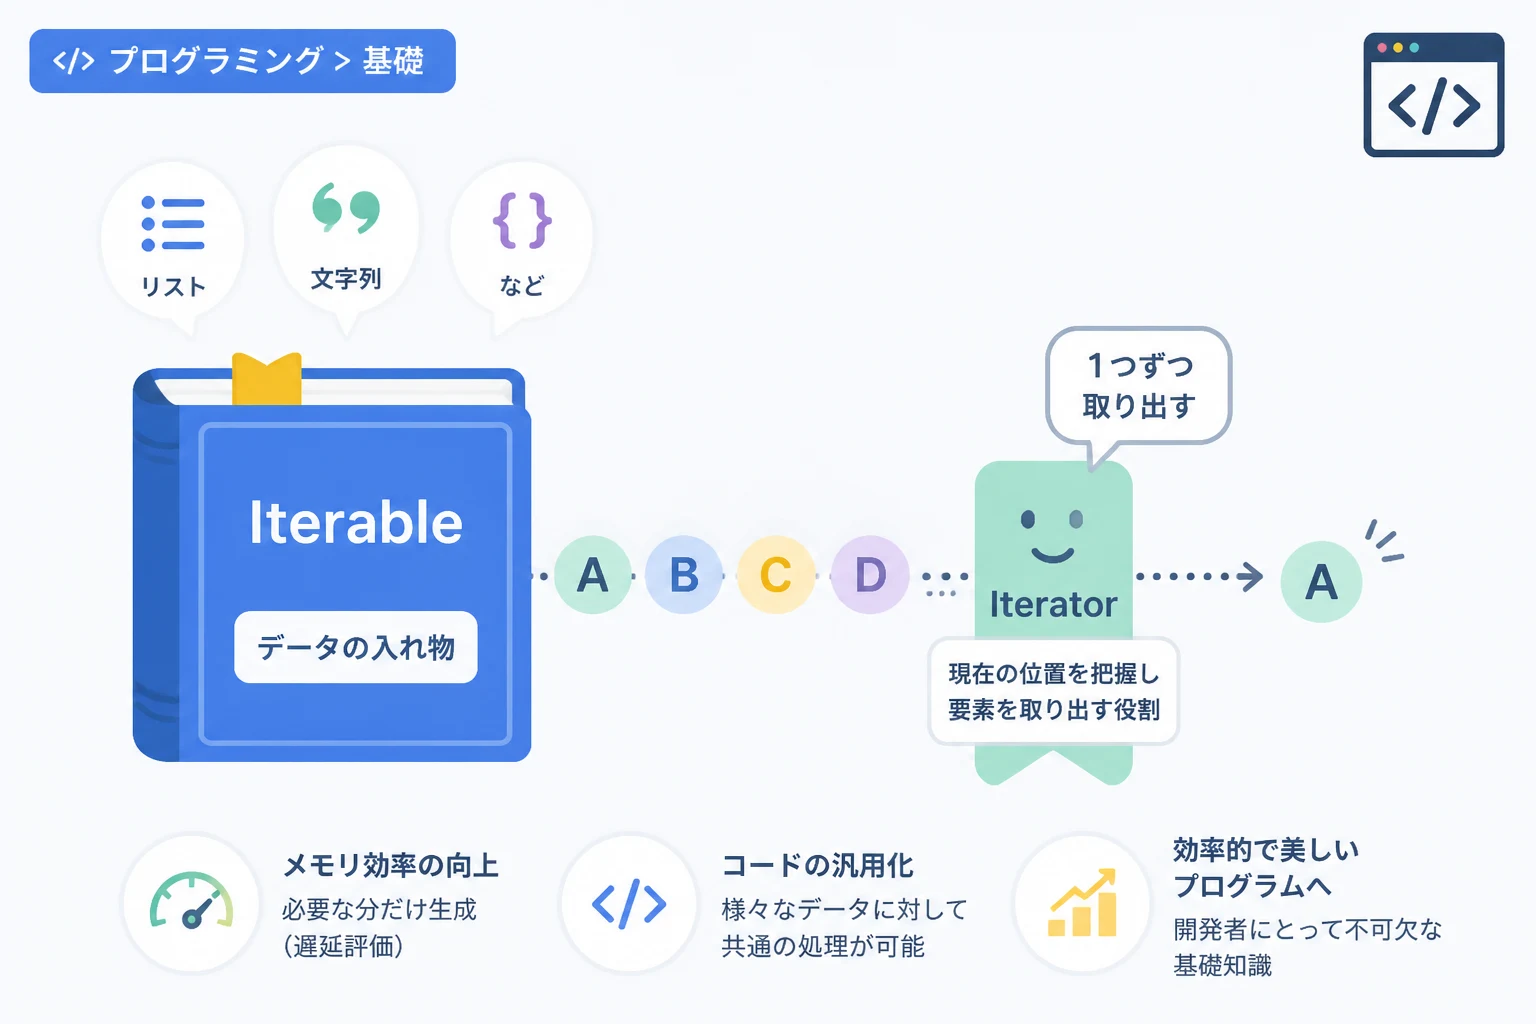
イテラブルは「データの入れ物」、イテレータは「取り出し役」
最もわかりやすい比喩表現として、「本」と「しおり(あるいは指)」の関係が挙げられます。
イテラブルは「本」そのものであり、中にはたくさんのページ(データ)が含まれていますが、自分自身で「今どこを読んでいるか」という状態を細かく管理しているわけではありません。
一方で、イテレータは「しおり」や「ページをめくる指」の役割を果たします。
イテレータは、イテラブル(本)から生成され、「次にどの要素を取り出すべきか」を常に把握している実務担当者なのです。
技術的な視点での違い
技術的な定義としては、以下のようになります。
| 用語 | 定義 | 主な特徴 |
|---|---|---|
| イテラブル | イテレータを返すことができるオブジェクト | リスト、タプル、文字列など。データの集合体。 |
| イテレータ | 次の要素を返す next() メソッドを持つオブジェクト | 現在位置を保持し、一度使い切ると基本的には終了する。 |
イテラブルからイテレータが作られる流れ
プログラムが実行される際、for文にイテラブル(例えばリスト)を渡すと、内部では自動的にそのイテラブルからイテレータが作成されます。
そのイテレータが「次の要素はあるか?」「あればそれを渡す」という作業を繰り返し、すべての要素を出し切ったところでループが終了する仕組みになっています。
つまり、イテラブルはイテレータを生み出すための源泉であると言えます。
プログラミング言語ごとのイテラブルの具体例
次に、主要なプログラミング言語においてどのようなものがイテラブルとして扱われるかを見ていきましょう。
Pythonにおけるイテラブル
Pythonはイテラブルの概念が非常に強力に組み込まれている言語です。
以下のオブジェクトはすべてイテラブルです。
- リスト (list):
[1, 2, 3] - タプル (tuple):
(1, 2, 3) - 辞書 (dict):
{"key": "value"} - 集合 (set):
{1, 2, 3} - 文字列 (str):
"Hello" - rangeオブジェクト:
range(10)
Pythonでは、iter() 関数にオブジェクトを渡してエラーにならなければ、それはイテラブルであると判断できます。
JavaScriptにおけるイテラブル
JavaScript(ES6以降)でもイテラブルの概念は非常に重要です。
for...of 文で使用できるオブジェクトがイテラブルに該当します。
- 配列 (Array)
- 文字列 (String)
- Map / Set
- 引数オブジェクト (arguments)
JavaScriptでは、内部的に Symbol.iterator という特別なメソッドを持っているオブジェクトがイテラブルとして認識されます。
イテラブルを活用するメリット
なぜ単なる「配列」ではなく「イテラブル」という概念を理解する必要があるのでしょうか。
それには、プログラムのパフォーマンスや再利用性を高めるための大きなメリットがあるからです。
メモリ効率の向上(遅延評価)
イテラブルの大きな利点の一つは、「必要な時に必要な分だけデータを生成できる」という点にあります。
例えば、100万個の要素を持つリストを作成する場合、メモリ上に100万個分のスペースを確保しなければなりません。
しかし、イテラブルな「ジェネレータ」などを使用すれば、ループが回るたびに次の1個を計算して生成するため、メモリ消費を劇的に抑えることができます。
これを「遅延評価(Lazy Evaluation)」と呼び、大規模なデータ処理には欠かせない技術です。
コードの抽象化と再利用性
関数が引数として「リスト」を受け取るのではなく「イテラブルなオブジェクト」を受け取るように設計されていれば、その関数の柔軟性は高まります。
リストを渡しても、ファイルから一行ずつ読み込むオブジェクトを渡しても、同じように動作する汎用的なプログラムを書くことができるようになります。
「中身が何であるか」ではなく「順番に処理できるか」という性質に注目することで、シンプルで美しいコードが実現します。
【実践】コードで見るイテラブルの挙動
ここでは、実際にコードを動かしてイテラブルの性質を確認してみましょう。
Pythonでの基本的なループ処理
まずは、最も一般的なリスト(イテラブル)を使ったループです。
# リスト(イテラブル)の定義
fruits = ["apple", "banana", "cherry"]

# for文で一つずつ取り出す
for fruit in fruits:
print(fruit)apple
banana
cherryこの背後では、Pythonが fruits からイテレータを作成し、要素を一つずつ print に渡しています。
文字列もイテラブルであることの確認
文字列も一文字ずつ分解できるため、イテラブルとして扱われます。
# 文字列(イテラブル)
message = "IT"

for char in message:
print(char)I
Tこのように、データ型が異なっても「イテラブルであれば同じ方法で扱える」という点が非常に強力です。
イテラブルに関するよくある質問
初心者の方が抱きやすい疑問についてまとめました。
Q. すべてのコレクション(データの集まり)はイテラブルですか?
A. ほとんどのプログラミング言語において、主要なコレクションはイテラブルです。
ただし、独自のクラス(型)を作った場合、そのままではイテラブルにはなりません。
そのクラスをイテラブルにするためには、特定のルール(Pythonなら __iter__ メソッドの実装など)に従って定義を行う必要があります。
Q. イテラブルと配列は何が違うのですか?
A. 配列はイテラブルの一種です。
イテラブルはより広い概念であり、「配列ではないけれど、一つずつデータを取り出せるもの」(例えば計算によって値を次々と生み出す装置など)も含みます。
「配列 ⊂ イテラブル」という関係性と考えるとわかりやすいでしょう。
Q. イテレータを二回以上ループさせることはできますか?
A. ここがイテラブルとイテレータの大きな違いです。
リストなどのイテラブルは何度でも for 文にかけることができますが、そこから生成されたイテレータ自体は一度最後まで読み取ると「空」の状態になり、再利用はできません。
再度ループしたい場合は、再びイテラブルから新しいイテレータを作成する必要があります。
まとめ
イテラブル(Iterable)は、モダンなプログラミングにおいてデータの集合を扱うための「共通のルール」です。
「順番に一つずつ取り出せる」というシンプルな性質を指す言葉ですが、この概念を理解することで、メモリ効率の良いコードや拡張性の高いプログラムを書くための土台が築かれます。
まずは、普段使っているリストや配列が「イテラブルな存在である」という意識を持つことから始めてみてください。
そして、イテレータとの役割の違いや、遅延評価によるメリットなどを意識できるようになれば、初心者から中級者への大きな一歩を踏み出したと言えるでしょう。
プログラムの裏側で動くこの「反復の仕組み」を味方につけて、よりスマートな開発を目指していきましょう。