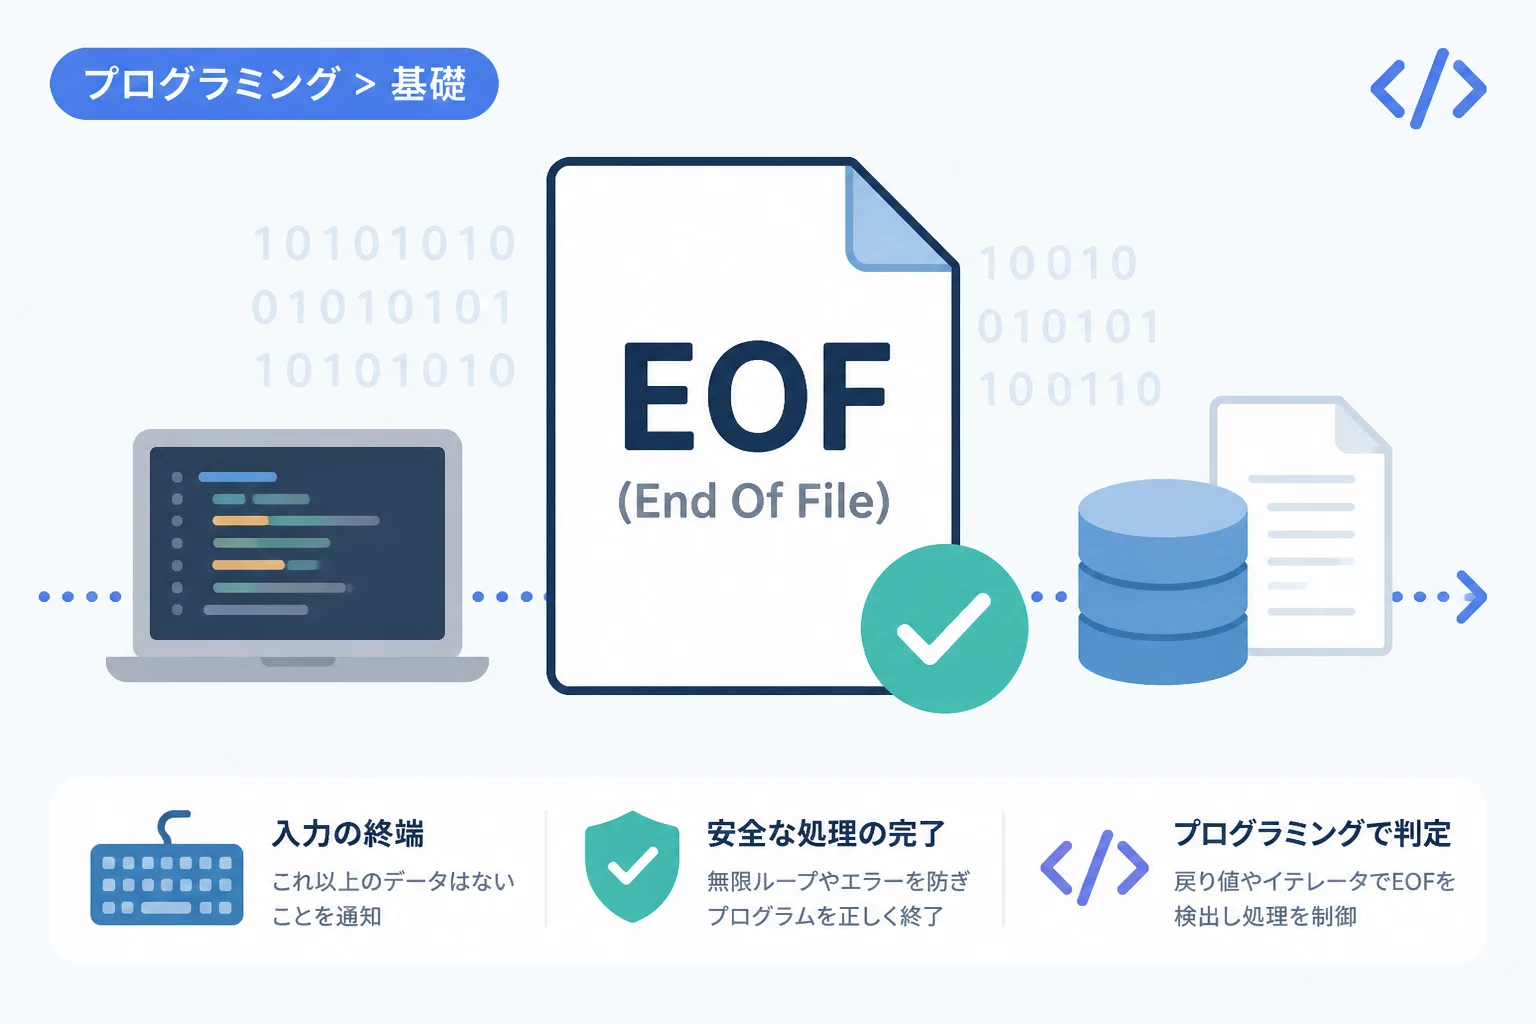
ITの世界において、プログラムがファイルやデータストリームの末尾に到達したことを判断するために欠かせない概念が「EOF」です。
EOFは「End Of File」の略称であり、日本語では「ファイルの終端」と訳されます。
テキストファイルやバイナリファイルを読み込む際、どこでデータが終わるのかを知ることは、無限ループを防ぎ、正しく処理を完了させるために極めて重要です。
本記事では、EOFの基本的な意味から、各オペレーティングシステムによる動作の違い、そして主要なプログラミング言語における具体的な判定方法までを詳しく解説します。
EOF(End Of File)とは何か
EOFは、プログラムが読み込んでいるデータストリームにおいて、これ以上読み込むべきデータが存在しない状態を指します。
初心者の方が誤解しやすい点として、EOFは「ファイルの中に書き込まれている特定の文字」であるとは限らないという点が挙げられます。
現代の多くのオペレーティングシステムでは、ファイルサイズに基づいて終端を管理しており、特定の文字をEOFとして扱うのではなく、システムが「これ以上のデータはない」というステータスをプログラムに返すことで実現されています。
つまり、EOFは実体のあるデータというよりも、システムが発行する「通知」や「状態」であると理解するのが正確です。
EOFが必要な理由
プログラムがファイルを読み込むとき、通常は先頭から1文字ずつ、あるいは一定のバッファごとにデータを取得していきます。
もしEOFという概念がなければ、プログラムはデータの終わりを判断できず、永遠に存在しないデータを読み込もうとし続けてしまいます。
この結果、プログラムがフリーズしたり、メモリにゴミデータが蓄積されたりする致命的なエラーを引き起こす可能性があります。
そのため、ファイル操作を伴うあらゆる処理において、EOFを正確に検知することは、堅牢なソフトウェアを開発するための大前提となります。
OSによるEOFの扱いの違い
EOFの扱いは、歴史的な経緯やOSの設計思想によっていくつかの違いがあります。
特に、キーボード入力(標準入力)をEOFとして扱う場合、OSごとに特定のキー入力が割り当てられています。
WindowsにおけるEOF
Windows環境のコマンドプロンプトやPowerShellでは、ユーザーが手動でEOFを送信する場合、Ctrlキーを押しながらZキーを押します。
これは、かつてのOSであるCP/MやMS-DOSの名残であり、当時はファイル末尾に特定の文字(ASCIIコードの26番)を書き込んで終端を示していたためです。
UNIX系OS(Linux/macOS)におけるEOF
一方、LinuxやmacOSなどのUNIX系システムでは、Ctrlキーを押しながらDキーを押すことでEOFを送信します。
UNIX系では、EOFを特定の文字として扱うのではなく、端末のドライバが「入力の終了」をシステムコールとしてプロセスに伝える仕組みをとっています。
OS別のEOF入力方法まとめ
それぞれのOSにおけるEOFの入力コマンドと動作を以下の表にまとめました。
| OSの種類 | 入力キー | 主な特徴 |
|---|---|---|
| Windows | Ctrl + Z | 歴史的にASCIIコード26(0x1A)を使用することがある。 |
| Linux / macOS | Ctrl + D | 入力ストリームの終了をシステムレベルで通知する。 |
プログラミングにおけるEOFの判定方法
プログラムの中でEOFをどのように判定するかは、使用する言語やライブラリによって異なります。
ここでは、代表的な言語であるC言語とPythonを例に、具体的な判定コードを確認してみましょう。
C言語でのEOF判定
C言語では、標準ライブラリのstdio.hにおいて、EOFというマクロが定義されています。
一般的に、このEOFの値は-1として定義されていることが多いです。
getchar()やfgetc()などの関数は、ファイルの終端に達するとこの値を返します。
#include <stdio.h>

int main() {
    int c;

    printf("文字を入力してください(Ctrl+DまたはCtrl+Zで終了):\n");

    // getchar()がEOFを返すまでループを繰り返す
    while ((c = getchar()) != EOF) {
        putchar(c);
    }

    printf("EOFを検知しました。終了します。\n");
    return 0;
}文字を入力してください(Ctrl+DまたはCtrl+Zで終了):
Hello World
Hello World
(ここでCtrl+Dを入力)
EOFを検知しました。終了します。ここで重要なのは、変数の型としてcharではなくint型を使用している点です。
char型では、有効なデータ値とEOFの値を区別できない場合があるため、より広い範囲を表現できるint型で戻り値を受け取る必要があります。
PythonでのEOF判定
モダンな言語であるPythonでは、C言語のように明示的なEOF定数を比較することは稀です。
ファイルを読み込む場合、read()メソッドはファイルの終端に達すると空の文字列(”)を返します。
また、イテレータを使用することで、EOFを意識せずに全行を処理することも可能です。
# ファイルを読み込む例
try:
    with open('example.txt', 'r', encoding='utf-8') as f:
        while True:
            line = f.readline()
            # 空文字列が返されたらEOF
            if not line:
                break
            print(line.strip())
except FileNotFoundError:
print("ファイルが見つかりません。")Pythonでは、for line in file_object:という記述を使うのが一般的であり、この場合はEOFに達した時点でループが自動的に終了します。
低レイヤーの動作を意識せずに済むよう、言語側で適切に抽象化されている良い例と言えるでしょう。
EOFに関するよくあるミスと注意点
EOFの扱いで最も多い間違いは、「データの有無を確認する前にデータを読み込もうとする」ことです。
特にC言語のfeof()関数を使用する場合、この関数は「最後に試みた読み込みが失敗したかどうか」を判定するものです。
そのため、ファイルの末尾に到達した直後の判定では真を返さず、さらにもう一度読み込みを試みて失敗した後に初めて真となります。
この仕様を理解していないと、最後の行を2回処理してしまうといったバグが発生しやすくなります。
解決策としては、読み込み関数の戻り値を直接ループの判定条件に使用するか、読み込み直後にEOFチェックを行う構造にすることです。
バイナリファイルとEOF
テキストファイルではなくバイナリファイルを扱う場合、データの中に偶然-1(0xFF)と同じ値が現れることがあります。
そのため、バイナリ処理では「特定の値」をEOFとみなす手法は使えません。
バイナリ操作の際は、あらかじめ取得しておいたファイルサイズと比較するか、システムが提供するファイルポインタの現在地を確認する方法が取られます。
高級言語のライブラリを使っている場合は、内部的にこれらが処理されているため、開発者が過度に心配する必要はありません。
ネットワーク通信におけるEOF
EOFの概念は、ローカルのファイルだけでなく、ネットワーク通信(ソケット通信)でも利用されます。
クライアントが接続をクローズすると、サーバー側の読み込み処理に対してEOFが送出されます。
これにより、サーバーは「相手からのデータ送信が完了した」ことを検知し、安全にセッションを終了することができます。
もしネットワークの切断時にEOFを正しくハンドリングできないと、サーバーのプロセスがハングアップしたり、ゾンビ接続が残ったりする原因となります。
まとめ
EOF(End Of File)は、データの終わりを示す、プログラム制御において不可欠な概念です。
OSによってその表現や入力方法は異なりますが、本質的には「入力ストリームの終了通知」という共通の役割を持っています。
C言語のような低レイヤーに近い言語では、戻り値の型や判定のタイミングに注意を払う必要があります。
一方で、Pythonなどの高級言語では、言語の仕様としてEOFが自然に扱えるよう設計されています。
どのような環境で開発を行うにせよ、EOFの仕組みを正しく理解しておくことは、予期せぬエラーを防ぎ、信頼性の高いコードを書くための第一歩となるでしょう。