ITシステムにおいてデータの完全性を維持することは、企業の信頼性を守る上で最も重要な要素の一つと言えます。
大量のデータを扱う現代のストレージ環境では、コピーや転送の過程で予期せぬエラーが発生するリスクが常に存在します。
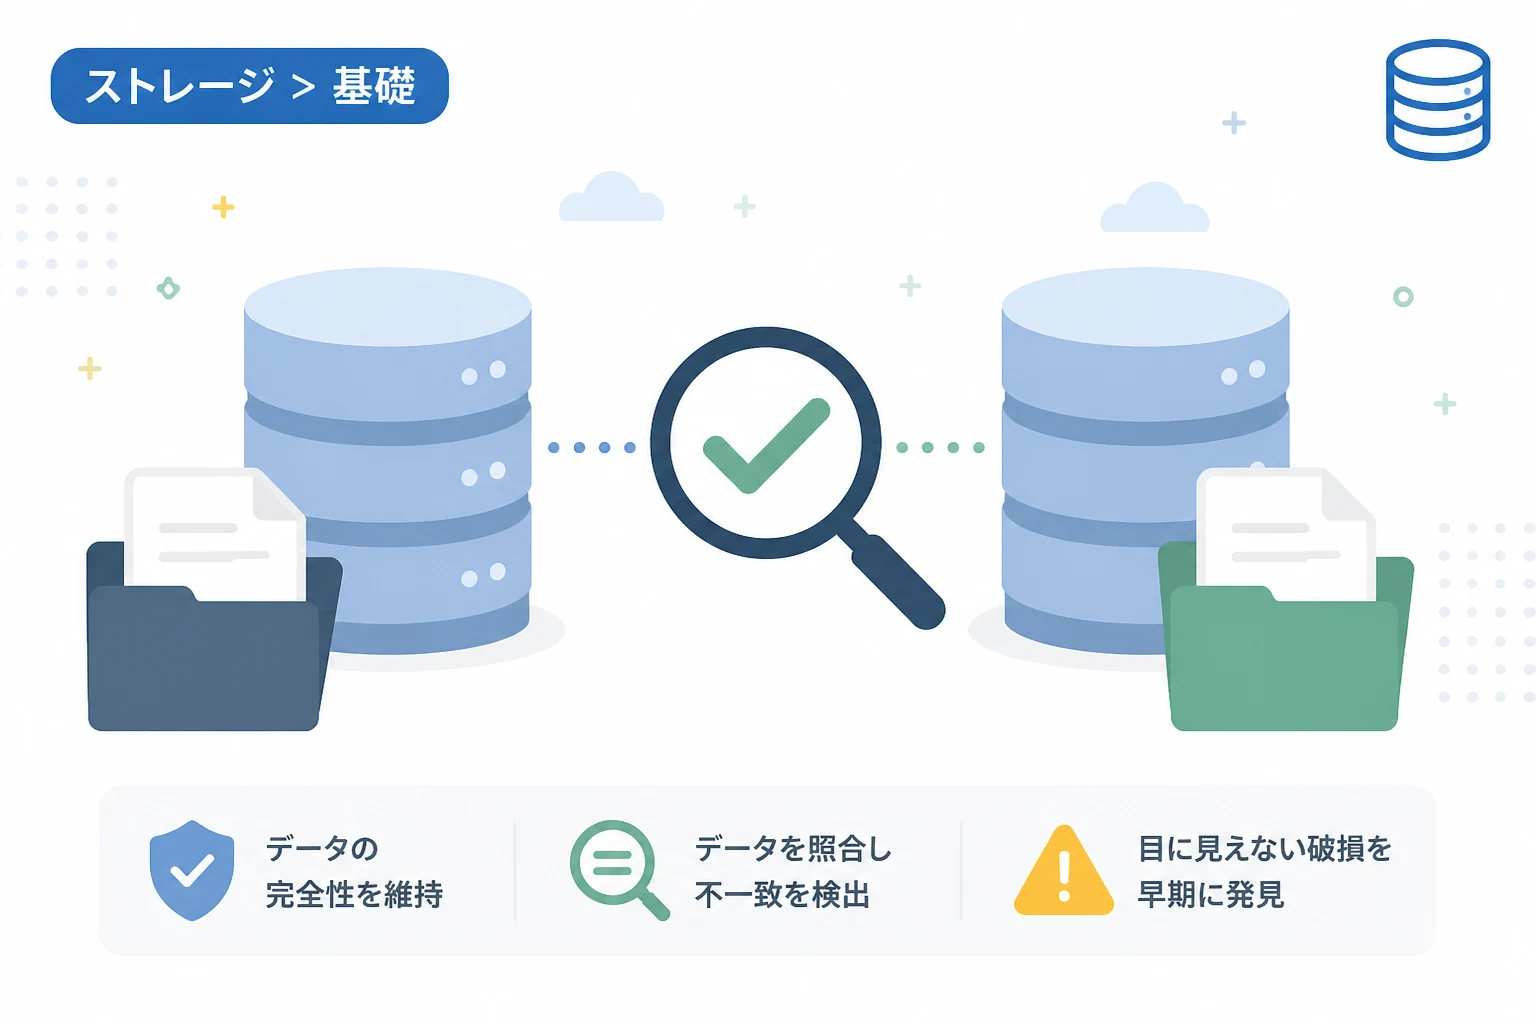
こうしたリスクを回避し、コピー元とコピー先のデータが寸分違わず一致しているかを確認する工程が「コンペア」です。
本記事では、コンペアの基本的な定義から、ストレージ運用における具体的な役割、そして検証精度の向上に欠かせない技術的な仕組みまでを詳しく解説します。
コンペア(Compare)の基礎知識と定義
コンペアとは、英語の「Compare(比較する)」に由来するIT用語で、2つ以上のデータセットを照合して差異がないかを確認する作業を指します。
ストレージの世界では、データのバックアップ、複製、あるいは移行が完了した直後に、正しく書き込みが行われたかを検証するプロセスとして定着しています。
データ検証における重要性
デジタルデータは、ハードウェアの故障やネットワークの瞬断、あるいはソフトウェアのバグによって、ごく稀に一部のビットが反転してしまうことがあります。
このような目に見えないデータの破損を早期に発見するためには、単純な「コピー完了」のメッセージを信じるだけでなく、コンペアによる厳密な検証が不可欠です。
特にミッションクリティカルなシステムでは、コンペアを実行しないままデータを運用することは、「データの整合性が保証されていない状態」を放置することと同義です。
コンペアが行われる主なシーン
コンペアは、主にデータの「移動」や「保存」が発生するタイミングで実行されます。
例えば、オンプレミスのサーバーからクラウドストレージへ大容量のデータを移行した際、転送中のパケットロスやエラーがないかを最終確認するために用いられます。
また、DVDやLTO(テープドライブ)などの物理メディアにバックアップを保存する際にも、書き込まれたデータが読み取り可能かつ正確であるかを確かめるためにコンペア設定が利用されます。
主なコンペアの手法と仕組み
コンペアには、検証の厳密さと処理スピードのバランスに応じた複数の手法が存在します。
システムに求められる信頼性レベルに応じて、最適な手法を選択することが運用の鍵となります。
1. フルデータ比較(バイナリ比較)
最も確実な手法は、2つのデータをビット単位ですべて照合するフルデータコンペア(バイナリ比較)です。
コピー元のデータとコピー先のデータを先頭から順に読み出し、1ビットの差異も許さず突き合わせます。
この方法は極めて高い精度を誇りますが、すべてのデータを読み出す必要があるため、大容量ストレージでは処理時間が長くなるというデメリットがあります。
2. チェックサム・ハッシュ値比較
効率的な検証方法として広く普及しているのが、ハッシュアルゴリズムを利用した比較です。
データ全体を特定の計算式に通すことで、短い「ハッシュ値」と呼ばれる固有の文字列を生成します。
コピー元で算出したハッシュ値と、コピー先で算出したハッシュ値を比較し、一致すればデータは同一であると判断します。
以下は、Linux環境などで利用される sha256sum コマンドを用いたコンペアのイメージです。
# 元ファイルのハッシュ値を確認
sha256sum original_data.bin
# コピー先ファイルのハッシュ値を確認
sha256sum copied_data.bin5e884898da28047151d0e56f8dc6292773603d0d6aabbdd62a11ef721d1542d8 original_data.bin
5e884898da28047151d0e56f8dc6292773603d0d6aabbdd62a11ef721d1542d8 copied_data.binこのように、出力されたハッシュ値が一致していれば、データが正確に転送されたことが証明されます。
3. ライト・アフター・リード(Read-after-Write)
ストレージデバイス自体が備えている機能として、データを書き込んだ直後にそのデータを読み込み、メモリ上の内容と一致するかを確認する仕組みがあります。
これは「ベリファイ」と呼ばれることも多く、ディスク側の物理的な書き込み不良を即座に検知するために有効です。
コンペア手法の比較表
それぞれの検証手法の特徴をまとめると以下のようになります。
| 手法 | 信頼性 | 処理速度 | 主な用途 |
|---|---|---|---|
| フルデータ比較 | 最高 | 遅い | 厳密な整合性が求められるアーカイブ |
| ハッシュ比較 | 高い | 高速 | ネットワーク経由のファイル転送、クラウド移行 |
| サイズ・タイムスタンプ比較 | 低い | 非常に高速 | 簡易的な同期、差分確認 |
ストレージ運用におけるコンペアの役割
ストレージ管理においてコンペアを適切に組み込むことは、トラブルの未然防止に直結します。
サイレントデータ破損(ビットロット)の検知
長期間アクセスされていないデータが、静電気や磁気の影響でいつの間にか変質してしまう現象を「サイレントデータ破損」と呼びます。
これはファイルシステムのエラーログに残らないことも多いため、定期的なコンペア実行によって正常なバックアップと比較しなければ発見できません。
最近のエンタープライズ向けストレージやファイルシステム(ZFSやBtrfsなど)では、バックグラウンドで自動的にハッシュ値を照合する「スクラブ」機能がコンペアの役割を果たしています。
バックアップの有効性確認
「バックアップは成功していると思っていたが、いざリストアしようとしたらデータが壊れていた」という事態は、システム管理者にとって最大の悪夢です。
バックアップジョブの設定にコンペアオプションを追加することで、バックアップソフトが書き込み後にデータの正当性を自動検証します。
この工程を省略すると、バックアップ完了通知が届いていても、実際には「リストア不可能なゴミ」を保存しているだけになるリスクがあります。
2026年におけるコンペア技術の動向
ストレージ容量がペタバイト(PB)単位に到達する2026年現在、コンペアの技術も進化を遂げています。
AIを活用した異常検知
従来のルールベースの比較に加え、AIがメタデータやアクセスパターンを分析し、不自然なデータの改ざんや破損の兆候を検知するシステムが登場しています。
これにより、すべてのデータを全件コンペアするコストを抑えつつ、リスクの高い領域を優先的に検証することが可能になりました。
エッジコンピューティングと分散コンペア
IoTデバイスなどのエッジ側で生成された膨大なデータをクラウドに集約する際、エッジ側で事前にハッシュ値を生成し、クラウド側でのコンペア負荷を分散する技術が普及しています。
ネットワーク帯域を節約しながらデータの完全性を担保するために、分散型の検証プロトコルが重要な役割を担っています。
コンペアを導入する際の注意点
コンペアは非常に有益なプロセスですが、導入にあたってはいくつかの留意点があります。
処理時間のオーバーヘッド
コンペアを実行するということは、実質的に「コピー」と同じ、あるいはそれ以上の負荷がストレージとネットワークにかかることを意味します。
バックアップウィンドウ(バックアップに許容される時間)が限られている場合、全てのデータに対してフルコンペアを行うのは現実的ではないかもしれません。
そのため、重要なシステムファイルのみをフルコンペアし、一般のログファイルはサンプリング調査に留めるといった「検証レベルの使い分け」が推奨されます。
リソースの消費
ハッシュ計算にはCPUリソースを、データの読み出しにはI/Oリソースを消費します。
業務時間中に大規模なコンペアを実行すると、ユーザーのアクセスレスポンスが低下する恐れがあります。
タスクのスケジューリングを最適化し、システムの低負荷時に実行するように設計することが重要です。
まとめ
コンペアは、データの正確性を検証し、ITシステムの信頼性を支える縁の下の力持ちのような存在です。
単にデータを「コピーする」ことと、「正しくコピーされたことを保証する」ことの間には、コンペアという極めて重要なステップが存在します。
バイナリ比較やハッシュアルゴリズムといった手法を理解し、ストレージ運用の要件に合わせて適切に選択することが求められます。
データの巨大化が進むこれからの時代、サイレントデータ破損や転送エラーから貴重な資産を守るために、コンペアの重要性はこれまで以上に高まっていくでしょう。
日々の運用フローに確実なデータ検証を取り入れ、万全のデータ保護体制を築いてください。