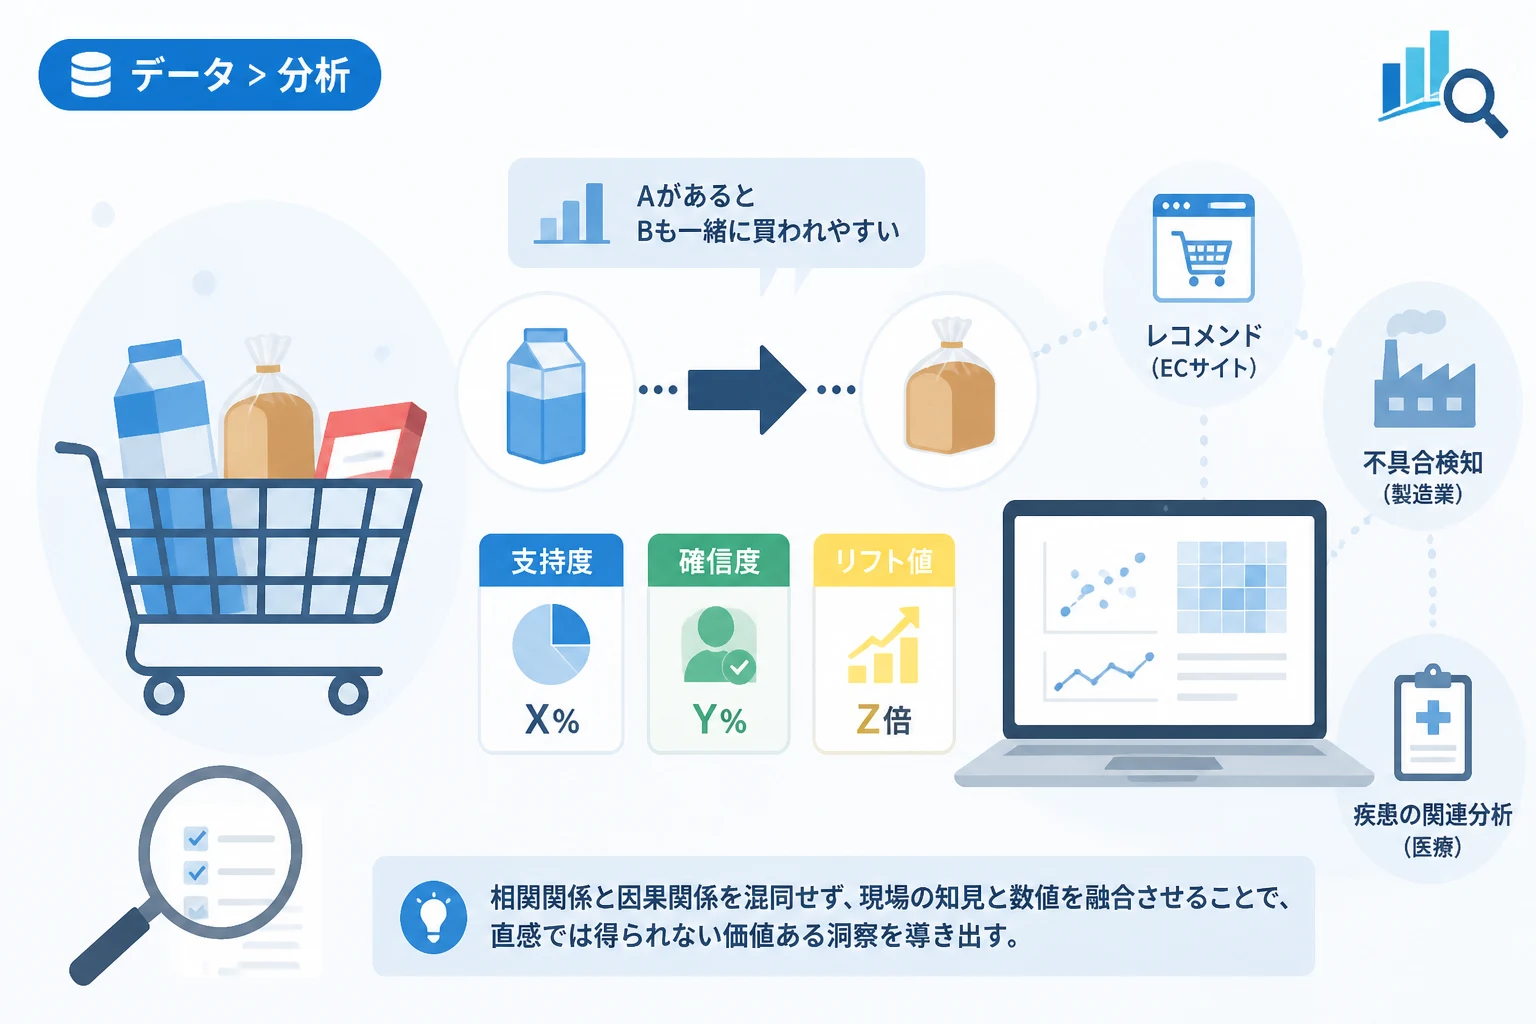
アソシエーション分析は、膨大なデータの中に隠れている「もしAならばBである」という関連性を見つけ出すためのデータマイニング手法です。
ビッグデータ時代の到来により、企業が蓄積する膨大な購買データや行動ログから価値ある示唆を得るための手段として、その重要性はますます高まっています。
一見すると無関係に思える事象同士の結びつきを数値化することで、直感や経験だけでは辿り着けないビジネスのヒントを発見できるのが最大の特徴です。
本記事では、アソシエーション分析の基礎知識から、分析に不可欠な指標、そして具体的な活用シーンまでを網羅して詳しく解説します。
アソシエーション分析とは
アソシエーション分析とは、データ群の中から意味のある「関連性(アソシエーションルール)」を抽出する統計的な手法のことです。
主に「商品Aを購入した人は、商品Bも購入する傾向がある」といった顧客行動のパターンを把握するために用いられます。
この手法は、1990年代に提唱された「マーケットバスケット分析」の基盤となったことで広く知られるようになりました。
現代では小売業のレジデータ(POSデータ)だけでなく、Webサイトの閲覧履歴や製造現場の不具合検知など、幅広い分野で応用されています。
アソシエーション分析の目的は、単なるデータの集計ではなく、事象間の相関関係を客観的な数値で裏付けることにあります。
マーケットバスケット分析との違い
アソシエーション分析と混同されやすい言葉に「マーケットバスケット分析」があります。
マーケットバスケット分析は、買い物客の「バスケット(買い物かご)」の中身を分析し、併売されやすい商品の組み合わせを探る手法を指します。
アソシエーション分析は、このマーケットバスケット分析を包含する、より広義なデータ解析手法であると定義できます。
つまり、マーケットバスケット分析は「小売業におけるアソシエーション分析の一形態」と捉えるのが一般的です。
アソシエーション分析自体は、購入履歴以外の時系列データや、Web上の遷移データなどにも適用できる汎用性の高い技術です。
アソシエーション分析の基本指標
アソシエーション分析では、抽出されたルールがどれほど強力で信頼できるものであるかを判断するために、3つの主要な指標を用います。
これらの指標を正しく理解し、適切に組み合わせることで、ノイズに惑わされない真の洞察を得ることが可能になります。
1. 支持度(Support)
支持度は、「全データの中で、特定の組み合わせ(AとBの両方)が含まれる割合」を示す指標です。
この数値が高いほど、その組み合わせが全体の中で頻繁に発生していることを意味します。
支持度が極端に低いルールは、たとえ関連性が強くても、発生回数が少なすぎてビジネス上のインパクトが小さいと判断される場合があります。
計算式は以下の通りです。
| 指標 | 計算方法 |
|---|---|
| 支持度 (Support) | (商品Aと商品Bを同時に含む取引数) ÷ (全取引数) |
2. 確信度(Confidence)
確信度は、「事象Aが発生したとき、どのくらいの確率で事象Bが発生するか」を示す指標です。
「条件付き確率」とも呼ばれ、ルールの信頼性を表す非常に重要な数値となります。
例えば、パンを買った人の80%が牛乳も買っている場合、確信度は0.8(80%)となります。
ただし、確信度が高いだけでは不十分であり、もともと牛乳が誰にでも買われる商品である可能性も考慮しなければなりません。
| 指標 | 計算方法 |
|---|---|
| 確信度 (Confidence) | (商品Aと商品Bを同時に含む取引数) ÷ (商品Aを含む取引数) |
3. リフト値(Lift)
リフト値は、「ルールの有効性」を客観的に評価するための指標です。
「商品Aを買ったことで、商品Bを買う確率がどれだけ上がったか」を算出します。
リフト値が1であれば、AとBの購入は独立しており、関連性がないことを示します。
リフト値が1を超えると、Aの購入がBの購入を促進している(正の相関がある)と判断できます。
逆に1を下回る場合は、Aを買う人はBを買いにくい(負の相関がある)ことを意味します。
| 指標 | 計算方法 |
|---|---|
| リフト値 (Lift) | 確信度 ÷ (商品Bを含む取引数 ÷ 全取引数) |
アソシエーション分析の具体的なプロセス
アソシエーション分析を成功させるためには、単にツールを動かすだけでなく、適切な手順を踏む必要があります。
ここでは、一般的な分析の流れを4つのステップに分けて解説します。
ステップ1:データの収集とクレンジング
まずは、分析の対象となるトランザクションデータを収集します。
POSデータ、ECサイトの注文履歴、アプリの操作ログなどがこれに当たります。
収集したデータには、キャンセルされた注文や重複データが含まれていることが多いため、除外するクレンジング作業が必要です。
また、分析の目的に合わせて、データの粒度(商品ID単位か、カテゴリ単位かなど)を決定します。
ステップ2:アソシエーションルールの抽出
次に、アルゴリズムを用いて関連性のある組み合わせを抽出します。
代表的なアルゴリズムとしては、計算負荷を抑えつつ効率的に頻出パターンを見つけるApriori(アプリアイオリ)アルゴリズムが有名です。
この段階では、あらかじめ「支持度0.01以上」「確信度0.5以上」といった閾値を設定し、無数の組み合わせを絞り込みます。
ステップ3:ルールの評価と選別
抽出された膨大なルールの中から、ビジネスに役立つものを評価します。
数値が高いルールが必ずしも有益とは限りません。
例えば「ハンバーガーとポテト」のように、当たり前すぎる組み合わせは、新たな施策に繋がりにくいからです。
リフト値が高く、かつ人間が予想していなかった意外な組み合わせに注目することが、成功の鍵となります。
ステップ4:施策の実行と効果検証
発見したルールに基づき、実際のビジネスアクションを起こします。
商品の陳列変更や、ECサイトでのレコメンド表示、セット販売の企画などが具体的な施策となります。
施策実施後は、再度データを収集してリフト値や売上にどのような変化があったかを検証します。
アソシエーション分析の活用事例
アソシエーション分析は、その汎用性の高さから多くの業界で導入されています。
代表的な活用シーンをいくつか紹介します。
小売業・ECサイトにおけるレコメンド
最も典型的な事例は、ECサイトでの「この商品を買った人は、こんな商品も買っています」というレコメンドエンジンです。
ユーザーがカートに入れた商品に関連するアイテムをリアルタイムで提案することで、クロスセル(併売)を促進します。
実店舗においては、ビールの隣におつまみを置く、あるいは少し離れた場所に戦略的に配置して店内回遊率を高めるといった陳列戦略に活かされています。
Webサイトの導線設計
Webサイトの閲覧履歴ログを分析することで、ユーザーがどのような順番でページを回っているかを把握できます。
「ページAを見た後にページCへ行く確率が高いが、実はページBを経由してほしい」といった課題が見つかることもあります。
特定のページ群を閲覧しているユーザーが成約(コンバージョン)に至りやすいルールを見つければ、バナー配置の最適化が可能です。
製造現場の品質管理・不具合分析
製造工程におけるセンサーデータや検査結果にアソシエーション分析を適用するケースも増えています。
「特定の温度条件と、特定の原材料の組み合わせが発生したときに、不良品率が上がる」といったパターンを特定します。
これにより、熟練工の勘に頼ることなく、データに基づいた品質管理体制を構築できます。
医療・ヘルスケア分野
患者の症状や処方薬、検査結果の相関関係を分析するために用いられます。
特定の副作用が発生しやすい患者の属性や、併用による影響を事前に予測する研究が進められています。
過去の膨大な症例データから、特定の病気が発症する前に現れやすい予兆(症状の組み合わせ)を発見することにも期待されています。
プログラミングによるアソシエーション分析の実装例
データサイエンスの現場では、Pythonなどのプログラミング言語を用いて分析を行うのが一般的です。
ここでは、Pythonのライブラリであるmlxtendを使用した簡単な実装イメージを紹介します。
import pandas as pd
from mlxtend.frequent_patterns import apriori
from mlxtend.frequent_patterns import association_rules

# サンプルデータの作成(各リストが1つの買い物かごを表す)
dataset = [
    ['Milk', 'Bread', 'Butter'],
    ['Bread', 'Butter'],
    ['Milk', 'Bread'],
    ['Milk', 'Cookies'],
    ['Bread', 'Butter', 'Cookies']
]

# データをバイナリ形式のデータフレームに変換
from mlxtend.preprocessing import TransactionEncoder
te = TransactionEncoder()
te_ary = te.fit(dataset).transform(dataset)
df = pd.DataFrame(te_ary, columns=te.columns_)

# 支持度が0.4以上の頻出パターンを抽出
frequent_itemsets = apriori(df, min_support=0.4, use_colnames=True)

# 確信度が0.7以上のルールを生成
rules = association_rules(frequent_itemsets, metric="confidence", min_threshold=0.7)

# 結果の表示
print(rules[['antecedents', 'consequents', 'support', 'confidence', 'lift']])
実行結果の例を以下に示します。
    antecedents consequents  support  confidence  lift
0      (Butter)     (Bread)      0.6         1.0  1.25
1       (Milk)     (Bread)      0.4         0.6  0.75
2     (Cookies)     (Bread)      0.4         1.0  1.25
この結果から、「バター(Butter)を買った人は100%の確率でパン(Bread)も買っている」という非常に強いルールが読み取れます。
実務では、これに加えてリフト値を参照し、偶然の一致ではないかを慎重に判断します。
アソシエーション分析を運用する際の注意点
アソシエーション分析は強力なツールですが、盲信すると誤った判断を下すリスクがあります。
分析を行う際には、以下のポイントに留意してください。
因果関係と相関関係を混同しない
アソシエーション分析が示すのは、あくまで「同時に発生しやすい」という相関関係です。
「Aを買ったからBを買った」という直接的な因果関係を証明するものではありません。
例えば、「ライターを買う人はタバコを買う」というルールが見つかっても、ライターの販売を強化すればタバコの売上が上がるわけではありません。
ビジネスに適用する際は、そのデータの背景にある顧客心理や物理的な要因を考察することが重要です。
データの期間と季節性を考慮する
分析対象とするデータの期間によって、得られる結果は大きく変わります。
夏季限定のルールを、冬季の戦略に適用しても効果は期待できません。
バレンタインデー前やクリスマス時期などの特異的な期間のデータは、平時とは切り離して分析する必要があります。
常に「今」の市場状況に即したデータを用いているかを確認してください。
計算コストと次元の呪い
扱う商品数が数万点に及ぶ場合、全ての組み合わせを計算しようとすると膨大な時間がかかります。
これを「次元の呪い」と呼び、計算リソースを圧迫する要因となります。
適切なアルゴリズムの選択や、分析対象を特定のカテゴリに絞り込むといった工夫が求められます。
まとめ
アソシエーション分析は、データの中に眠る未知の関連性を明らかにし、ビジネスの意思決定を強力にサポートする手法です。
支持度、確信度、リフト値という3つの指標を正しく使い分けることで、精度の高いルールを導き出すことができます。
小売業のバスケット分析から製造業の工程改善まで、その応用範囲は多岐にわたります。
しかし、分析結果はあくまで「相関」であり、その裏にある真のニーズや因果関係を読み解くのは人間の役割です。
最新のツールやプログラミング技術を活用しながら、現場の知見とデータを融合させることで、アソシエーション分析は真の価値を発揮します。
まずは身近なデータを使って、意外な「もしAならばB」を探すことから始めてみてはいかがでしょうか。