プログラミングやアルゴリズムの学習を始めると、必ずと言っていいほど「オーダー」や「計算量」という言葉に出会います。
IT分野におけるオーダーとは、あるプログラムが処理を実行する際に、入力データの量に応じてどれくらいの時間や記憶容量が必要になるかを示す指標のことです。
コンピュータの性能が向上した現代においても、膨大なデータを扱うシステムでは、効率の悪いアルゴリズムを選んでしまうと処理が終わりません。
この記事では、アルゴリズムの効率性を評価するために不可欠な「オーダー(計算量)」の概念と、その表記法である「ビッグオー記法」について詳しく解説します。
オーダー(計算量)の基礎知識
アルゴリズムの性能を評価する際、単に「実行にかかった秒数」を測るだけでは不十分です。
なぜなら、実行速度は使用するコンピュータのCPU性能やメモリの容量、プログラミング言語の実行環境によって大きく左右されてしまうからです。
そこで、ハードウェアの性能に依存せず、純粋にアルゴリズムそのものの効率性を表す尺度として「オーダー」が用いられます。
オーダーを理解することで、データ量が増えたときにシステムがどの程度重くなるかを事前に予測できるようになります。
時間計算量と空間計算量
計算量には、大きく分けて「時間計算量」と「空間計算量」の2種類が存在します。
時間計算量は、アルゴリズムが完了するまでに必要な「ステップ数(計算回数)」が、入力データ量に対してどのように増加するかを示します。
空間計算量は、アルゴリズムを実行するために必要な「メモリ領域」が、データ量に応じてどの程度必要になるかを示す指標です。
現代のシステム開発では、メモリ容量が比較的豊富であるため、一般的に「計算量」と言えば「時間計算量」を指すことが多いです。
ビッグオー記法(O記法)とは
オーダーを表現するために一般的に使われるのが、「ビッグオー記法(O記法)」です。
これは、入力データの個数を n としたとき、計算量が最大でどの程度のオーダー(桁合い)になるかを O(n) や O(n^2) のように記述する方法です。
ビッグオー記法では、最も影響力の大きい項に注目し、細かい定数や係数は無視するというルールがあります。
たとえば、計算回数が 3n + 5 回だったとしても、n が無限に大きくなれば 3 や 5 の影響は微々たるものになるため、オーダーは O(n) と表現します。
つまり、ビッグオー記法は「データの増加に対して、処理時間がどのような傾向で増えるか」という大まかな傾向を把握するためのものです。
代表的なオーダーの種類と実行速度の違い
アルゴリズムによって、データの増加に伴う処理時間の増え方は劇的に異なります。
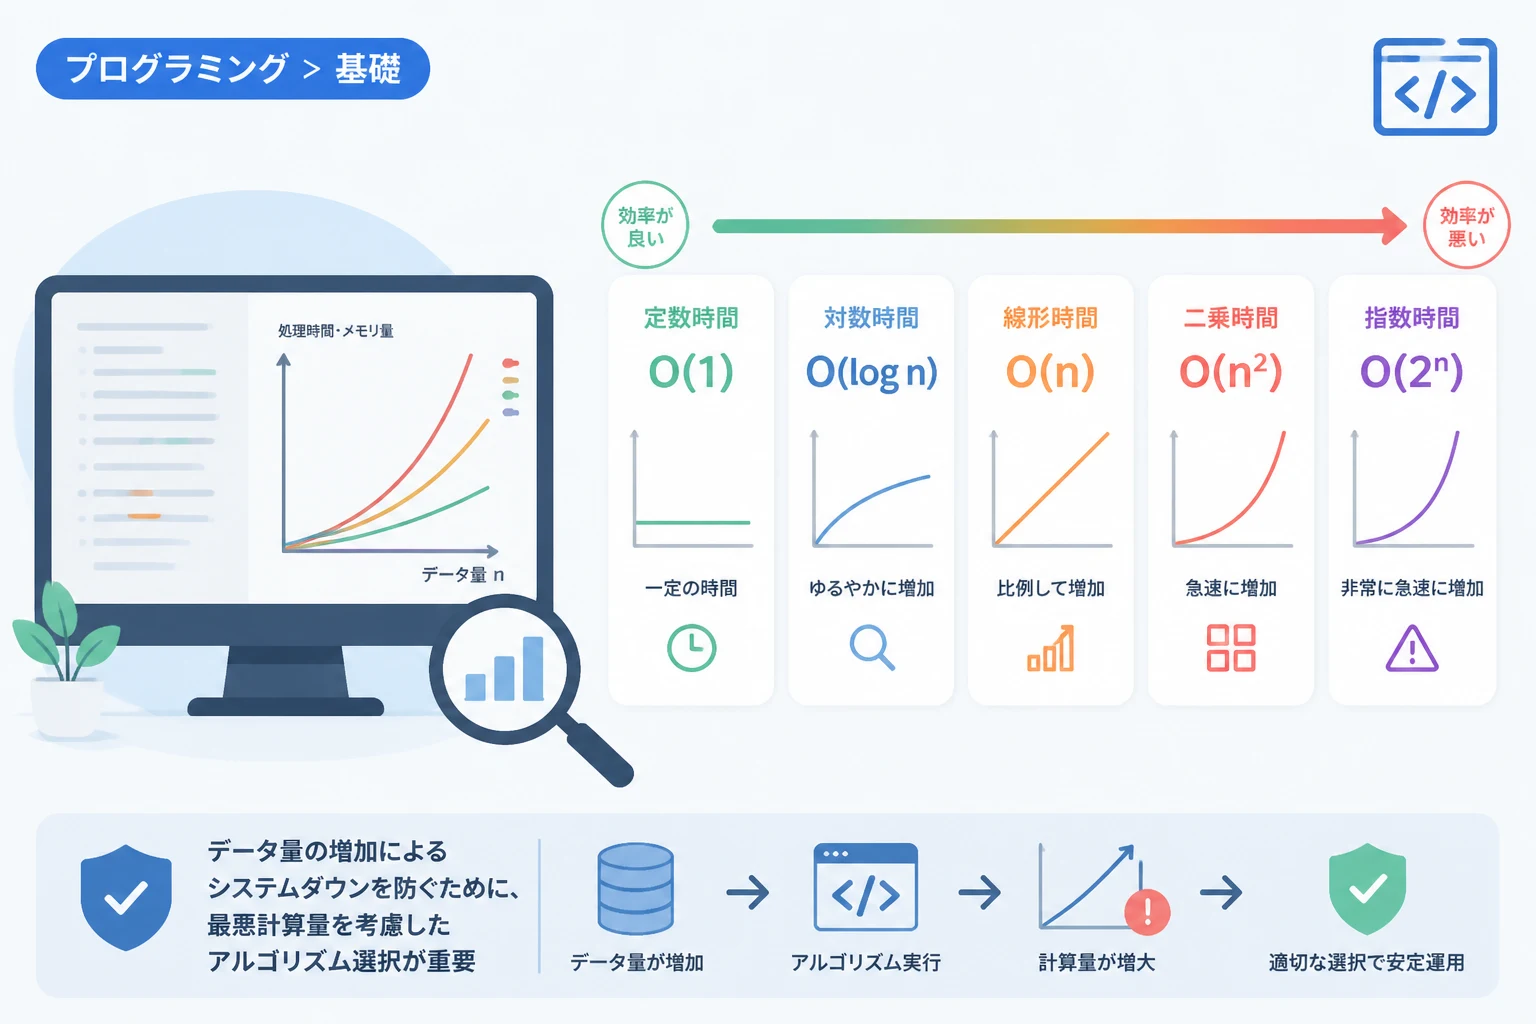
ここでは、頻繁に登場する主要なオーダーを、効率が良い順(処理が速い順)に紹介します。
O(1) – 定数時間
O(1) は、入力データの量に関わらず、常に一定の時間で処理が完了する最も理想的な状態です。
たとえば、配列の特定のインデックスにある要素を直接参照する操作などがこれに該当します。
データが1件であっても1億件であっても、計算の手間が変わらないのが特徴です。
O(log n) – 対数時間
O(log n) は、データ量が増えても計算時間の増加が非常に緩やかな、効率の良いアルゴリズムです。
代表的な例としては、ソート済みのデータから目的の値を高速に見つけ出す「二分探索(バイナリサーチ)」があります。
データ量が2倍になっても計算回数は1回増えるだけで済むため、大規模データ処理において非常に強力です。
O(n) – 線形時間
O(n) は、データ量に比例して計算時間が増えていく、非常に直感的で標準的なオーダーです。
配列の先頭から末尾まで順番にデータを探していく「線形探索」などがこの典型例です。
データ量が10倍になれば処理時間も10倍になりますが、予測が立てやすく扱いやすい計算量と言えます。
O(n log n) – 対数線形時間
O(n log n) は、効率的なソートアルゴリズム(クイックソートやマージソートなど)でよく見られる計算量です。
O(n) よりは少し遅いですが、次に説明する O(n^2) に比べると圧倒的に高速です。
実用的なアルゴリズムの設計において、このオーダーに収めることが一つの目標になることも多いです。
O(n^2) – 二乗時間
O(n^2) は、データ量の二乗に比例して計算時間が増大する、注意が必要なオーダーです。
二重のループ処理(ネスト)を行うアルゴリズムなどがこれに該当します。
データ量が10倍になると処理時間は100倍、データ量が1,000倍になると処理時間は1,000,000倍(100万倍)に膨れ上がるため、大量のデータを扱う際には破綻するリスクがあります。
O(2^n) – 指数時間
O(2^n) は、データが1つ増えるごとに処理時間が倍増していく、極めて効率の悪いオーダーです。
再帰呼び出しを単純に重ねたフィボナッチ数列の計算などが例として挙げられます。
わずかなデータ量の増加でスパコンでも数万年かかるような計算量になるため、実用的なシステムでは極力避けるべき指標です。
計算量の比較表
各オーダーにおいて、データ量 n が増えたときに計算回数がどのように変化するかを以下の表にまとめました。
| オーダー記法 | 名称 | n=10 の時 | n=1,000 の時 | 評価 |
|---|---|---|---|---|
| O(1) | 定数時間 | 1 | 1 | 非常に速い |
| O(log n) | 対数時間 | 約3 | 約10 | 速い |
| O(n) | 線形時間 | 10 | 1,000 | 普通 |
| O(n log n) | 対数線形時間 | 約33 | 約10,000 | やや遅い |
| O(n^2) | 二乗時間 | 100 | 1,000,000 | 遅い |
| O(2^n) | 指数時間 | 1,024 | 天文学的数字 | 実用不可 |
実際のコードで見るオーダーの違い
プログラムの構造がオーダーにどのような影響を与えるか、簡単なコード例で確認してみましょう。
以下の例は、配列内の要素を処理する際の O(n) と O(n^2) の違いを示しています。
# O(n) の例:リストの全要素を表示する
def print_all_elements(data):
    for item in data:
        print(item)  # データ数 n に比例して繰り返す

# O(n^2) の例:リストの全要素の組み合わせを表示する
def print_all_pairs(data):
    for first in data:
        for second in data:
            print(f"{first}, {second}")  # データ数 n の二乗回繰り返す
上記の print_all_elements 関数は、リストの要素数が増えればその分だけ処理時間が増えます。
一方で print_all_pairs 関数は、リストの要素が 100 個あれば 10,000 回、1,000 個あれば 1,000,000 回の処理が行われます。
このように、ループが重なる(ネストする)構造は、計算量を飛躍的に増大させる原因となります。
オーダーを意識した開発の重要性
なぜエンジニアはオーダーを常に意識しなければならないのでしょうか。
それは、「小規模なテストデータでは動いても、本番環境の大量データでは動かなくなる」という致命的なトラブルを防ぐためです。
例えば、ユーザー数が100人のシステムで O(n^2) の処理を書いても、計算回数は 10,000 回なので瞬時に終わります。
しかし、ユーザーが 10 万人に増えた場合、計算回数は 100 億回に達し、サーバーがフリーズするか応答不能に陥ります。
アルゴリズムのオーダーを理解していれば、開発の初期段階で将来的なボトルネックを予測し、より効率的な手法(例えば O(n log n) への改善など)を選択することができます。
計算量を左右する要因と改善のコツ
計算量を減らすためには、いくつか定石となる考え方があります。
一つ目は、不必要なループを避けることです。
同じデータを何度も走査(スキャン)していないか確認し、一度のループで必要な情報をすべて取得するように改善します。
二つ目は、適切な「データ構造」を選択することです。
例えば、大量のデータから特定の値を検索する場合、リスト(配列)を使うと O(n) かかりますが、ハッシュセットや辞書(連想配列)を使えば平均して O(1) で検索が可能になります。
三つ目は、ソート済みのデータを活用することです。
データが整列されていれば、先述の二分探索を利用することで、検索効率を O(n) から O(log n) へ劇的に向上させられます。
最悪・平均・最良計算量の違い
計算量を評価する際には、「どのような状況での計算量か」を区別する必要があります。
一般的に最も重要視されるのは「最悪計算量」です。
これは、アルゴリズムにとって最も都合の悪いデータが入力された場合に、最大でどれくらいの時間がかかるかを示すものです。
「平均計算量」は、あらゆるパターンの入力が期待される場合の平均的な性能を示します。
「最良計算量」は、運良くすぐに処理が終わる場合の性能ですが、システムの安定性を保証する上ではあまり参考にされません。
実務においては、最悪のケースでもシステムが制限時間内に応答できるかを判断基準にするのが一般的です。
まとめ
オーダー(計算量)は、アルゴリズムの効率性を客観的に評価し、将来的なパフォーマンスを予測するための共通言語です。
ビッグオー記法を理解し、O(n) や O(n^2) といった指標を意識することで、よりスケーラブルで高品質なプログラムを書くことが可能になります。
特に大量のデータを扱う現代のアプリケーション開発において、オーダーの知識は単なる理論ではなく、実務に直結する必須スキルと言えます。
日々のコーディングの中で、「この処理のオーダーはいくつか?」と自問自答する習慣をつけることが、優れたエンジニアへの第一歩となるでしょう。