AI(人工知能)や機械学習が社会のあらゆる場面で活用されるようになり、私たちの生活はかつてないほど便利になりました。
検索エンジンの推奨結果から、金融機関の与信審査、企業の採用活動に至るまで、アルゴリズムによる意思決定は多岐にわたります。
しかし、その意思決定のプロセスにおいて「アルゴリズムバイアス」と呼ばれる深刻な問題が浮き彫りになっています。
公平であるはずのAIが、特定の人種や性別、社会的背景に対して不当な偏りを生んでしまうこの現象は、現代社会における大きな課題です。
本記事では、アルゴリズムバイアスの定義から、なぜ発生するのかという原因、そして私たちが取るべき対策について詳しく解説します。
アルゴリズムバイアスとは何か
アルゴリズムバイアスとは、コンピューターの計算手順であるアルゴリズムによって、特定のグループに対して不公平な結果が体系的に出力される現象を指します。
AIは客観的なデータに基づいて判断を下すため、人間のような主観や感情に左右されず、常に公平であると考えられがちです。
しかし、実際にはAIの学習元となるデータやアルゴリズムの設計自体に偏りが含まれている場合、AIはその偏りを学習し、増幅させてしまいます。
その結果、特定の属性を持つ人々が不利益を被ったり、既存の社会的な差別が再生産されたりするリスクが生じます。
例えば、過去の採用データに男性の採用者が多かった場合、AIは「男性であること」を採用の有利な条件として学習してしまう可能性があります。
このように、アルゴリズムが意図せずとも生み出してしまう偏りを正しく理解することが、AIを適切に運用するための第一歩となります。
アルゴリズムバイアスが発生する主な原因
アルゴリズムバイアスが発生する原因は一つではなく、AI開発のさまざまなプロセスに潜んでいます。
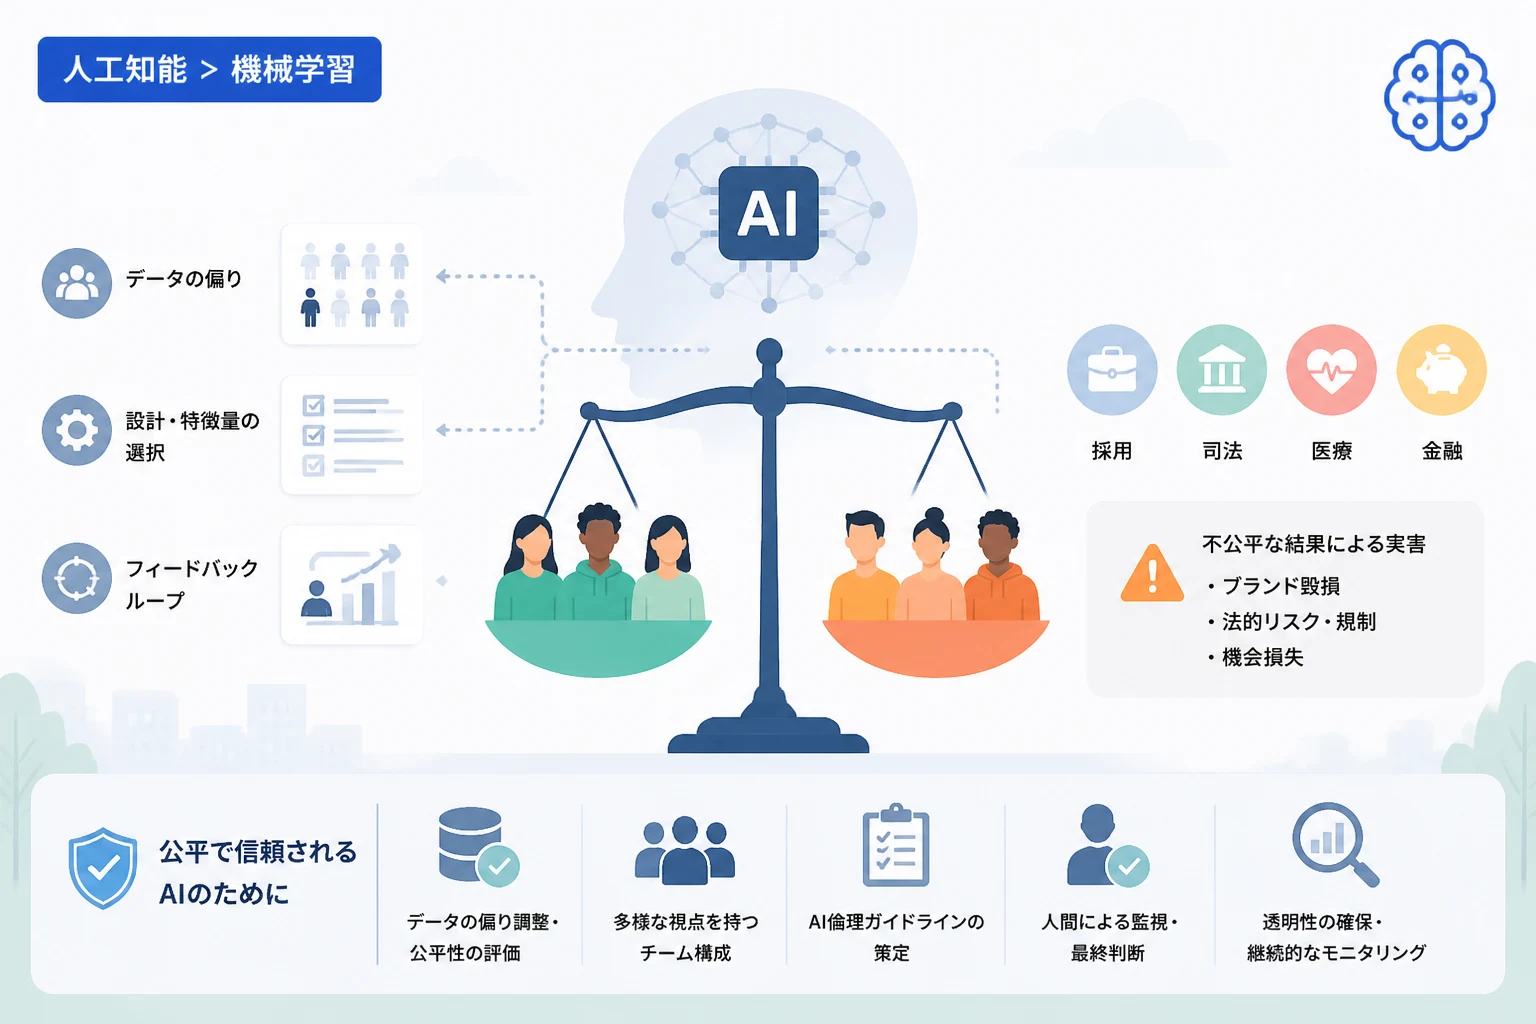
主な原因を「学習データの偏り」「アルゴリズムの設計」「フィードバックループ」の3つの観点から整理してみましょう。
学習データに含まれるバイアス
AIの精度は、学習に使用するデータの質と量に大きく依存します。
もし学習データそのものが、過去の人間社会における差別や偏見を反映している場合、AIはその傾向を「正解」として学習します。
例えば、過去のローン審査データにおいて特定の地域の住民が不当に拒否されていた実績が多いと、AIもその地域の人々を「リスクが高い」と判断するようになります。
これを「ヒストリカル・バイアス(歴史的バイアス)」と呼び、データの収集範囲が狭い場合に発生する「サンプリング・バイアス」も同様の問題を引き起こします。
アルゴリズムの設計と特徴量の選択
AIモデルを開発する際、どのデータを重要視するかという「特徴量(フィーチャー)」の選択は人間が行います。
一見すると中立的な項目であっても、それが特定の属性と強く相関している場合、間接的なバイアス(プロキシバイアス)を生むことがあります。
例えば、人種情報を直接入力していなくても、「居住地の郵便番号」が人種構成と密接に関係している場合、郵便番号を重視することが結果的に人種差別に繋がることがあります。
また、アルゴリズムが最適化を目指す指標(目的関数)の設定ミスにより、公平性よりも効率性が優先され、バイアスが助長されるケースも少なくありません。
フィードバックループによる増幅
アルゴリズムバイアスの恐ろしい点は、運用を続ける中で偏りがさらに強化される「自己強化型フィードバックループ」にあります。
AIが予測を行い、その予測に基づいて人間が行動し、その結果が新たな学習データとして蓄積されることで、バイアスが固定化されます。
予測ポリシング(犯罪予測)において、過去の検挙数が多い地域に警察官を重点配備すると、結果としてその地域での検挙数がさらに増え、AIは「その地域は危険である」という判断を強めてしまいます。
このような循環が繰り返されることで、一度発生した小さな偏りが社会的な格差を決定的なものにするリスクがあるのです。
アルゴリズムバイアスの代表的な事例
実際に世界中で報告されているアルゴリズムバイアスの事例を確認することで、その影響の大きさを理解しましょう。
| 分野 | 具体的な事例の内容 | 発生したバイアスの影響 |
|---|---|---|
| 採用活動 | 大手テック企業が開発したAI採用ツールが、女性の履歴書を低く評価した。 | 過去の男性中心の採用実績を学習した結果、性差別的なフィルタリングが発生した。 |
| 刑事司法 | 再犯予測アルゴリズムが、黒人被告に対して白人被告よりも高い再犯リスクスコアを算出した。 | 人種による不当な不利益が生じ、保釈や判決に不公平な影響を与えた。 |
| 顔認識技術 | 一部の顔認識システムにおいて、肌の色が濃い女性の誤認率が白人男性に比べて極めて高かった。 | 認証の失敗や誤認逮捕のリスクなど、基本的人権に関わる問題に発展した。 |
| 医療診断 | 患者の医療費負担額を健康状態の指標としたAIが、黒人患者の優先順位を不当に下げた。 | 経済格差が医療格差へと直結し、適切な治療機会が失われる結果を招いた。 |
これらの事例は、AIが決して「中立な神」ではないことを示唆しており、開発者や運用者の責任が厳しく問われるようになっています。
アルゴリズムバイアスが企業に与えるリスク
アルゴリズムバイアスは倫理的な問題にとどまらず、企業経営においても致命的なビジネスリスクとなり得ます。
まず挙げられるのが、ブランドイメージの失墜と社会的信用の低下です。
差別的なAIを運用していることが発覚すれば、SNSでの炎上や不買運動に発展し、長年築き上げた企業の信頼が瞬時に崩壊する可能性があります。
次に、法的なリスクと制裁金の可能性です。
欧州の「EU AI法(EU AI Act)」をはじめ、世界各国でAIの公平性を規制する法整備が急速に進んでいます。
バイアスを放置したままAIを利用し続けることは、莫大な罰金や事業停止命令を受ける原因になりかねません。
さらに、ビジネス上の機会損失も無視できません。
不正確なバイアスに基づく判断は、本来獲得できたはずの優秀な人材や優良な顧客を排除してしまうことになり、市場競争力の低下を招きます。
アルゴリズムバイアスを解消するための対策
バイアスを完全にゼロにすることは非常に困難ですが、適切なプロセスを導入することで最小限に抑えることは可能です。
技術的なアプローチと組織的なアプローチの両面から対策を講じることが重要です。
技術的な対策アプローチ
AI開発のサイクルにおいて、各フェーズで公平性を担保するための手法が研究されています。
前処理(Pre-processing)では、学習データからバイアスの原因となる情報を削除したり、データのバランスを調整したりします。
インプロセス(In-processing)では、学習アルゴリズム自体に公平性の制約条件を組み込み、バイアスを抑制しながら学習させます。
後処理(Post-processing)では、出力された予測結果に対して、特定のグループ間の差を補正する調整を行います。
例えば、Pythonのオープンソースライブラリである「AIF360 (AI Fairness 360)」などを用いることで、バイアスの検知や修正を行うことが可能です。
# AIF360を用いたバイアス検知のイメージ(概念的なコード)
from aif360.datasets import BinaryLabelDataset
from aif360.metrics import ClassificationMetric

# データセットと予測結果を定義し、メトリクスを算出する
metric = ClassificationMetric(dataset_true, dataset_pred,
                              unprivileged_groups=unprivileged_groups,
                              privileged_groups=privileged_groups)

# 公平性指標(Disparate Impactなど)を確認
print(f"Disparate Impact: {metric.disparate_impact()}")Disparate Impact: 0.75 # 1.0より低い場合、不公平な偏りがある可能性がある組織的・プロセス面での対策
技術的なツールを導入するだけでは不十分であり、開発文化そのものを見直す必要があります。
多様な視点を持つチーム構成を意識し、開発メンバーのジェンダーや人種が偏らないようにすることが、潜在的なバイアスに気づくきっかけとなります。
また、「AI倫理ガイドライン」を策定し、AIシステムのリリース前に第三者機関によるオーディット(監査)を受ける仕組みを構築することも有効です。
さらに、AIの判断根拠を人間に説明できる「説明可能なAI(XAI)」の技術を活用し、ブラックボックス化を防ぐ努力が求められます。
最終的な判断をAIに丸投げするのではなく、人間が最終確認を行う「Human-in-the-loop」の体制を維持することも、リスク回避の重要な手段です。
AIの公平性とこれからの展望
2020年代半ばを過ぎ、AI規制の議論は「努力義務」から「法的な遵守事項」へとシフトしています。
もはやアルゴリズムバイアスへの対策は、一部の先進的なIT企業だけが取り組むべき課題ではなく、AIを利用するすべての組織にとっての義務となりました。
今後、AIの透明性と説明責任を果たすことが、企業のデジタルトランスフォーメーション(DX)を成功させる鍵となるでしょう。
私たちが目指すべきは、AIを排除することではなく、AIの特性を正しく理解し、コントロールすることによって、真に公平な社会を実現することです。
アルゴリズムバイアスという鏡を通して、私たち自身の社会に潜む偏見を見つめ直し、それを是正していくプロセスこそが、AI時代の真の進歩と言えるかもしれません。
まとめ
アルゴリズムバイアスは、AIが学習するデータや設計プロセスに由来する深刻な不公平性の問題です。
意図的でないにせよ、AIが既存の差別を強化し、個人の人生を左右する決定に偏りをもたらすリスクは常に存在します。
企業がこの問題に立ち向かうためには、学習データの精査、公平性評価ライブラリの活用、そして倫理的なガバナンス体制の構築が不可欠です。
AIの恩恵を最大化しつつ、誰もが公平に扱われるデジタル社会を築くために、アルゴリズムバイアスへの理解と対策を継続的に深めていきましょう。