現代のデジタル社会において、プログラムは私たちの生活のあらゆる場面で重要な役割を担っています。
スマートフォンでニュースを読んだり、SNSで友人と繋がったり、オンラインショッピングを楽しんだりする背後には、常にコンピュータによる計算処理が存在します。
その計算の中核を成しており、プログラムの「知能」とも呼べる存在がアルゴリズムです。
エンジニアにとって、最適なアルゴリズムを選択し実装するスキルは、ソフトウェアの品質や性能を左右する極めて重要な要素となります。
本記事では、IT用語としてのアルゴリズムの定義から、主要な種類、そして実務における効率的な選び方まで、詳しく解説していきます。
アルゴリズムとは何か:プログラムの「手順書」
アルゴリズムとは、簡単に言えば「ある特定の問題を解決するための手順や計算手法」のことです。
コンピュータは非常に高速な計算能力を持っていますが、具体的な指示を与えられなければ、自ら考えて行動することはできません。
そこで人間が、「このデータを使って、このように処理し、最終的にこの結果を出してほしい」という一連の流れを論理的に組み立てたものがアルゴリズムです。
アルゴリズムはプログラミング言語に依存するものではなく、どのような言語で実装する場合でも共通する論理的な設計図と言い換えることができます。
よく使われる例えとして「料理のレシピ」があります。
カレーを作るという目的(問題解決)に対し、材料を切り、炒め、煮込むという順序だった手順(アルゴリズム)が示されているのと同様です。
ただし、コンピュータの世界では、手順の正確さと効率性が厳密に求められます。
正しい結果を導き出すことは当然ですが、いかに少ない資源で、いかに早く処理を終えるかが、アルゴリズムの良し悪しを決定する基準となります。
アルゴリズムの5つの基本要素
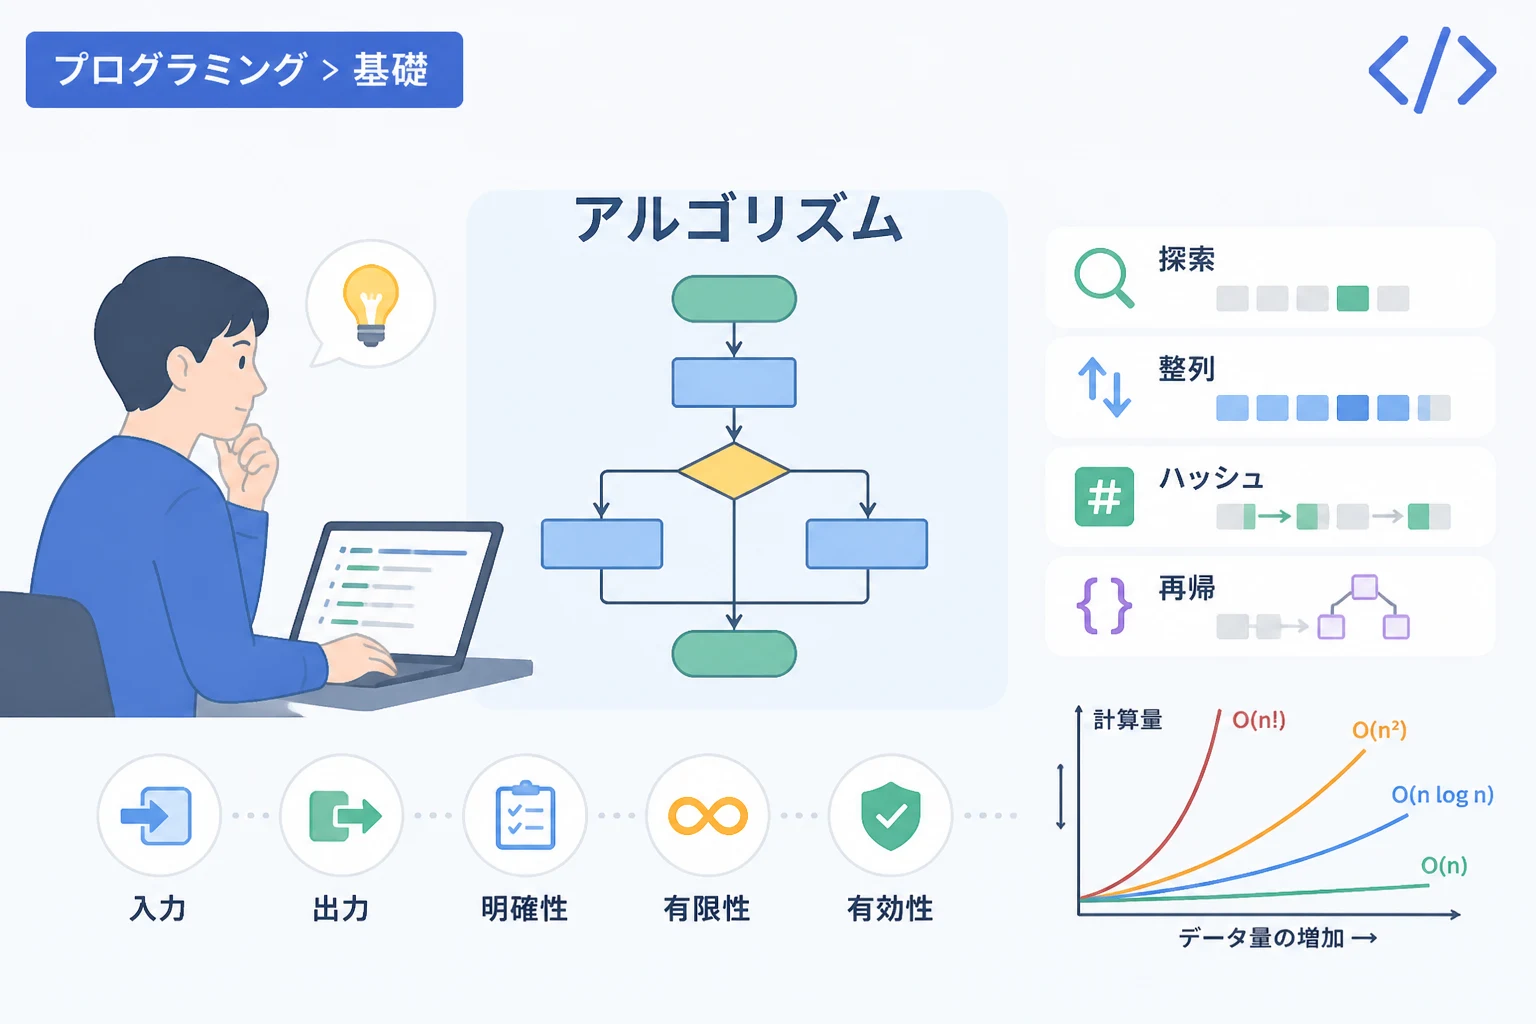
一般的に、優れたアルゴリズムには備わっていなければならない5つの性質があると言われています。
1つ目は「入力(Input)」であり、処理を開始するために外部から与えられるデータが必要です。
2つ目は「出力(Output)」であり、処理の結果として得られる明確な成果物が必要となります。
3つ目は「明確性(Definiteness)」であり、各手順は曖昧さがなく、誰が実行しても同じ解釈になる必要があります。
4つ目は「有限性(Finiteness)」であり、処理は必ず一定の手順数で終了し、無限ループに陥ってはなりません。
5つ目は「有効性(Effectiveness)」であり、すべての手順が実際に実行可能で、問題解決に寄与するものである必要があります。
これらの要素を満たすことで、はじめて実用的なアルゴリズムとして機能します。
なぜプログラミングにおいてアルゴリズムが重要なのか
プログラミングを始めたばかりの頃は、まず文法を覚えることに必死になりがちですが、中級者以上を目指すにはアルゴリズムの理解が不可欠です。
なぜなら、同じ結果を得るためのプログラムであっても、採用するアルゴリズムによって実行速度やメモリ消費量に劇的な差が生まれるからです。
例えば、100万件のデータから特定の情報を探す場合を考えてみましょう。
先頭から順番に確認する単純な方法(線形探索)では、最悪の場合100万回の確認が必要です。
しかし、効率的なアルゴリズム(二分探索)を使えば、わずか20回程度の確認で済んでしまいます。
この差は、ユーザーがアプリケーションを操作した際の「サクサク感」や、サーバーの運用コストに直結します。
また、大規模なシステム開発においては、データの増加に伴って処理時間が爆発的に増えないような工夫が求められます。
アルゴリズムの知識があれば、将来的なデータ増加を見越した拡張性の高い設計が可能になります。
アルゴリズムの性能を評価する「計算量」の考え方
アルゴリズムの良し悪しを客観的に判断するための指標として「計算量」という概念があります。
計算量には、主に「時間計算量」と「空間計算量」の2種類が存在します。
時間計算量は、入力データの量に対して、処理を完了するまでにどれくらいのステップ(時間)が必要かを表します。
空間計算量は、処理を実行するためにどれくらいのメモリ領域を必要とするかを表します。
現代のコンピューティング環境ではメモリが比較的潤沢であるため、多くの場合、時間計算量が最も重視されます。
オーダー記法(Big O記法)
計算量を表すときには「O(オー)記法」という表記が用いられます。
これは、データの個数を n としたとき、計算の回数が n の増加に伴ってどのように変化するかを大まかに示すものです。
代表的な計算量の種類を以下にまとめます。
| 記法 | 名称 | 特徴 |
|---|---|---|
| O(1) | 定数時間 | データ量に関わらず常に一定の速さで終わる、最も理想的な状態です。 |
| O(log n) | 対数時間 | データ量が増えても計算回数がほとんど増えない、非常に効率的な状態です。 |
| O(n) | 線形時間 | データ量に比例して計算時間が増える、標準的な状態です。 |
| O(n log n) | 線形対数時間 | 効率の良いソートアルゴリズムなどで見られる計算量です。 |
| O(n^2) | 二乗時間 | データが2倍になると計算時間が4倍になる、大量データには不向きな状態です。 |
アルゴリズムを選ぶ際には、このオーダーが小さいものを選ぶことがパフォーマンス改善の基本となります。
プログラミングで頻用される主要なアルゴリズム
アルゴリズムには数え切れないほどの種類がありますが、プログラミングの実務や学習において特によく登場するものがいくつか存在します。
これらをパターンとして理解しておくことで、複雑なロジックを自力でゼロから考える手間を省くことができます。
1. 探索アルゴリズム(サーチ)
探索アルゴリズムは、大量のデータの中から目的のデータを見つけ出すための手法です。
最も基本的なのは「線形探索(リニアサーチ)」で、データの端から順番に一つずつ確認していきます。
線形探索はデータが並べ替えられていなくても使えますが、計算量は O(n) となります。
対して、非常に強力なのが「二分探索(バイナリサーチ)」です。
二分探索は、あらかじめ昇順または降順に並んでいるデータを対象に、中央の値を確認して探している範囲を半分ずつ絞り込んでいきます。
この手法の計算量は O(log n) であり、データ量が増えれば増えるほど線形探索との差が顕著になります。
2. 整列アルゴリズム(ソート)
ソートは、データを特定の順序(昇順や降順)に並べ替えるアルゴリズムです。
「バブルソート」や「選択ソート」はアルゴリズムの仕組みが理解しやすく、教育用によく用いられますが、計算量が O(n^2) であるため実用性は低めです。
実務で広く利用されているのは「クイックソート」や「マージソート」です。
クイックソートは、基準となる値(ピボット)を選び、それより大きいか小さいかでグループ分けを繰り返す手法で、平均的に非常に高速です。
マージソートは、データを最小単位まで分割してから、順番を整えつつ結合していく「分割統治法」に基づいた手法で、安定した性能を発揮します。
3. ハッシュアルゴリズム
ハッシュアルゴリズムは、入力されたデータを一定の長さの固定された文字列(ハッシュ値)に変換する手法です。
データの検索を O(1) という驚異的なスピードで行うための「ハッシュテーブル」というデータ構造を支えています。
また、ハッシュ値から元のデータを逆算することが極めて困難であるため、パスワードの保存やデータの改ざん検知といったセキュリティ分野でも不可欠な技術です。
4. 再帰アルゴリズム
再帰アルゴリズムとは、ある関数の中で自分自身を再び呼び出す手法のことです。
階乗の計算や、ディレクトリ構造の探索といった「大きな問題を同じ形の小さな問題に分解できる」場合に非常にシンプルかつ美しく記述できます。
ただし、終了条件を誤ると無限ループになり、メモリ不足(スタックオーバーフロー)を引き起こす危険があるため、慎重な設計が求められます。
アルゴリズムの実装例:二分探索(Python)
言葉での説明だけでなく、実際のコードを見ることでアルゴリズムの動作イメージを深めましょう。
ここでは、ソート済みのリストから特定の数値を高速に探し出す二分探索の基本的なコード例をPythonで示します。
def binary_search(target_list, item):
    # 探索範囲の初期値を設定(リストの端と端)
    low = 0
    high = len(target_list) - 1

    while low <= high:
        # 中央の位置を計算
        mid = (low + high) // 2
        guess = target_list[mid]

        # 目的の値を見つけた場合
        if guess == item:
            return mid

        # 目的の値より大きかったら、範囲を左側に絞る
        if guess > item:
            high = mid - 1
        # 目的の値より小さかったら、範囲を右側に絞る
        else:
            low = mid + 1

    # 見つからなかった場合
    return None

# テスト用のソート済みデータ
my_list = [1, 3, 5, 7, 9, 11, 13, 15]

# 「7」がどのインデックスにあるか探す
print(f"Index: {binary_search(my_list, 7)}")Index: 3このコードでは、リストのサイズがどれだけ大きくなっても、1ステップごとに候補が半分に削られるため、非常に効率的な探索が可能です。
効率的なアルゴリズムの選び方:4つの判断基準
実際の開発現場では、常に「最強のアルゴリズム」が決まっているわけではありません。
扱うデータの性質、利用可能なリソース、開発コストなど、複数の要因を天秤にかけて最適なものを選択する必要があります。
1. データの規模を把握する
扱うデータの数が数十個程度であれば、計算量 O(n^2) のアルゴリズムでも一瞬で処理が終わります。
そのような場合、あえて複雑な O(n log n) のアルゴリズムを苦労して実装するより、コードが単純で読みやすい方法を選んだ方が保守性は高まります。
しかし、データが数万、数百万を超える可能性があるなら、計算量のオーダーが小さいものを選ぶことが必須条件となります。
2. データの性質と制約を確認する
ソートを例に挙げると、元々のデータがある程度並んでいるのか、それともバラバラなのかによって最適な手法が異なります。
また、同じ値を持つデータの前後関係を維持する必要があるか(安定性)という点も重要です。
検索においては、データが頻繁に追加・削除されるのか、それとも一度構築したら変更されないのかによって、選ぶべきデータ構造とアルゴリズムが変わってきます。
3. メモリ使用量(空間計算量)を考慮する
最近のパソコンやサーバーではあまり問題になりませんが、組み込みシステムやIoTデバイスなど、メモリが極端に制限された環境では話が変わります。
どれだけ高速でも、メモリを大量に消費するアルゴリズムは採用できません。
処理速度とメモリ消費のトレードオフを理解し、環境に合ったバランスを見極めることがエンジニアの腕の見せ所です。
4. 標準ライブラリの活用を優先する
現代のプログラミング言語(Python, Java, C++, JavaScriptなど)には、高度に最適化されたアルゴリズムが標準ライブラリとして組み込まれています。
例えば Python の sort() 関数は、内部で Timsort という非常に洗練されたアルゴリズムを使用しています。
特別な理由がない限り、自分でアルゴリズムを自作するよりも、言語が提供する信頼性の高い既存機能を利用するのが最も効率的かつ安全です。
ただし、その内部でどのようなアルゴリズムが動いているかを知っておくことは、トラブルシューティングや限界性能を引き出す際に役立ちます。
アルゴリズム学習をステップアップさせるコツ
アルゴリズムは数学的な要素が含まれるため、苦手意識を持つ方も少なくありません。
しかし、一度にすべてを理解しようとせず、段階を追って学習を進めることで着実に身につけることができます。
図解をイメージしてトレースする
ソースコードを眺めるだけでなく、紙にペンを持ってデータの動きを自分で書き出してみることをお勧めします。
「この変数に何が入り、次にどう動くか」を手書きで追うことで、論理の壁を乗り越えやすくなります。
最近ではアルゴリズムの動作をアニメーションで視覚化してくれるWebサイトも多いため、そうしたツールを活用するのも効果的です。
競技プログラミングに挑戦してみる
「AtCoder」や「LeetCode」といった競技プログラミングサイトでは、パズル感覚でアルゴリズムの問題を解くことができます。
制限時間内に効率の良い解法を導き出す訓練は、実務でのコードの書き方を根本から変えてくれるはずです。
他の人が書いた解答コードを見ることで、自分では思いつかなかったような鮮やかな解法に出会えるのも大きな魅力です。
データ構造とのセットで学ぶ
アルゴリズムとデータ構造は、車の両輪のような関係にあります。
配列、リスト、スタック、キュー、ツリー(木構造)、グラフといったデータ構造を深く理解することで、それらを操作するアルゴリズムの仕組みがより腑に落ちるようになります。
「なぜこのデータ構造はこのアルゴリズムに適しているのか」をセットで考える習慣をつけましょう。
まとめ
アルゴリズムは、プログラミングにおける問題解決の「知恵」が凝縮されたものです。
単に「動けば良い」という段階から一歩進み、「より速く、より美しく、より効率的に」という視点を持つことで、エンジニアとしての価値は飛躍的に高まります。
本記事で紹介した計算量の考え方や代表的なアルゴリズムの種類は、あくまで入り口に過ぎません。
まずは身近な処理から「もっと効率的な手順はないか」と問い直すことから始めてみてください。
基礎をしっかりと固めることで、AIやデータサイエンスといった最先端の分野に挑戦する際にも、揺るぎない土台となってあなたを支えてくれるでしょう。
アルゴリズムへの理解を深め、より高度なプログラミングの世界を楽しんでください。