アベンド(ABEND)という言葉を耳にしたとき、多くの方はシステムが予期せず停止してしまった不測の事態を想像されるのではないでしょうか。
ITの現場においてアベンドは、プログラムやオペレーティングシステム(OS)が何らかの致命的な問題に直面し、処理を継続できなくなった際に発生する「異常終了」を意味する重要な用語です。
本記事では、アベンドの基本的な定義から、なぜこのような現象が発生するのかという仕組み、そして万が一発生してしまった際の具体的な対処法までを詳しく解説します。
システムの安定稼働を支えるエンジニアやIT担当者にとって、アベンドの正体を正しく理解することは、トラブルシューティングのスキルを向上させるための第一歩となるでしょう。
アベンド(ABEND)とは何か?基本的な定義と由来
アベンド(ABEND)とは、「Abnormal End(アブノーマル・エンド)」の略称であり、コンピュータのプログラムがエラーによって途中で強制終了することを指します。
日本語では一般的に「異常終了」と呼ばれており、ソフトウェアが設計者の意図しない挙動を示した結果として発生します。
この用語の歴史は古く、かつてIBMが開発した汎用コンピュータ(メインフレーム)のOSにおいて、タスクを強制終了させる命令として使われていたことに由来します。
現代のIT環境においても、この言葉はサーバー管理やソフトウェア開発の現場で、深刻なエラーを表現する際に頻繁に用いられています。
アベンドが発生すると、処理中だったデータが保存されなかったり、システム全体が停止してしまったりするなど、ビジネスに大きな影響を及ぼす可能性があります。
そのため、アベンドが発生した際には「なぜ止まったのか」という原因を迅速に特定し、復旧作業を行うことが極めて重要です。
なお、通常の終了手続きを経てプログラムが閉じることは「ノーマル・エンド(正常終了)」と呼ばれ、アベンドとは明確に区別されます。
アベンドと通常の終了の違い
システムが停止するという現象には、プログラムの設計に基づいた「正常終了」と、予期せぬエラーによる「異常終了(アベンド)」の2種類が存在します。
正常終了の場合、プログラムは必要な後処理をすべて完了させ、確保していたメモリ領域を解放してから静かに動作を終えます。
一方のアベンドは、OSや実行環境が継続不可能だと判断した時点で、処理を無理やり打ち切る動作を指します。
以下の表は、正常終了とアベンドの主な違いをまとめたものです。
| 比較項目 | 正常終了(Normal End) | アベンド(ABEND / 異常終了) |
|---|---|---|
| 発生のタイミング | すべての処理が完了したとき | エラーや不整合が発生した瞬間 |
| データの整合性 | 保たれる(保存処理が行われる) | 失われる可能性がある(不完全な状態) |
| システムへの通知 | 正常終了コードが返される | アベンドコードやダンプが出力される |
| 主な原因 | ユーザー操作、プログラムの完了 | バグ、リソース不足、ハードウェア故障 |
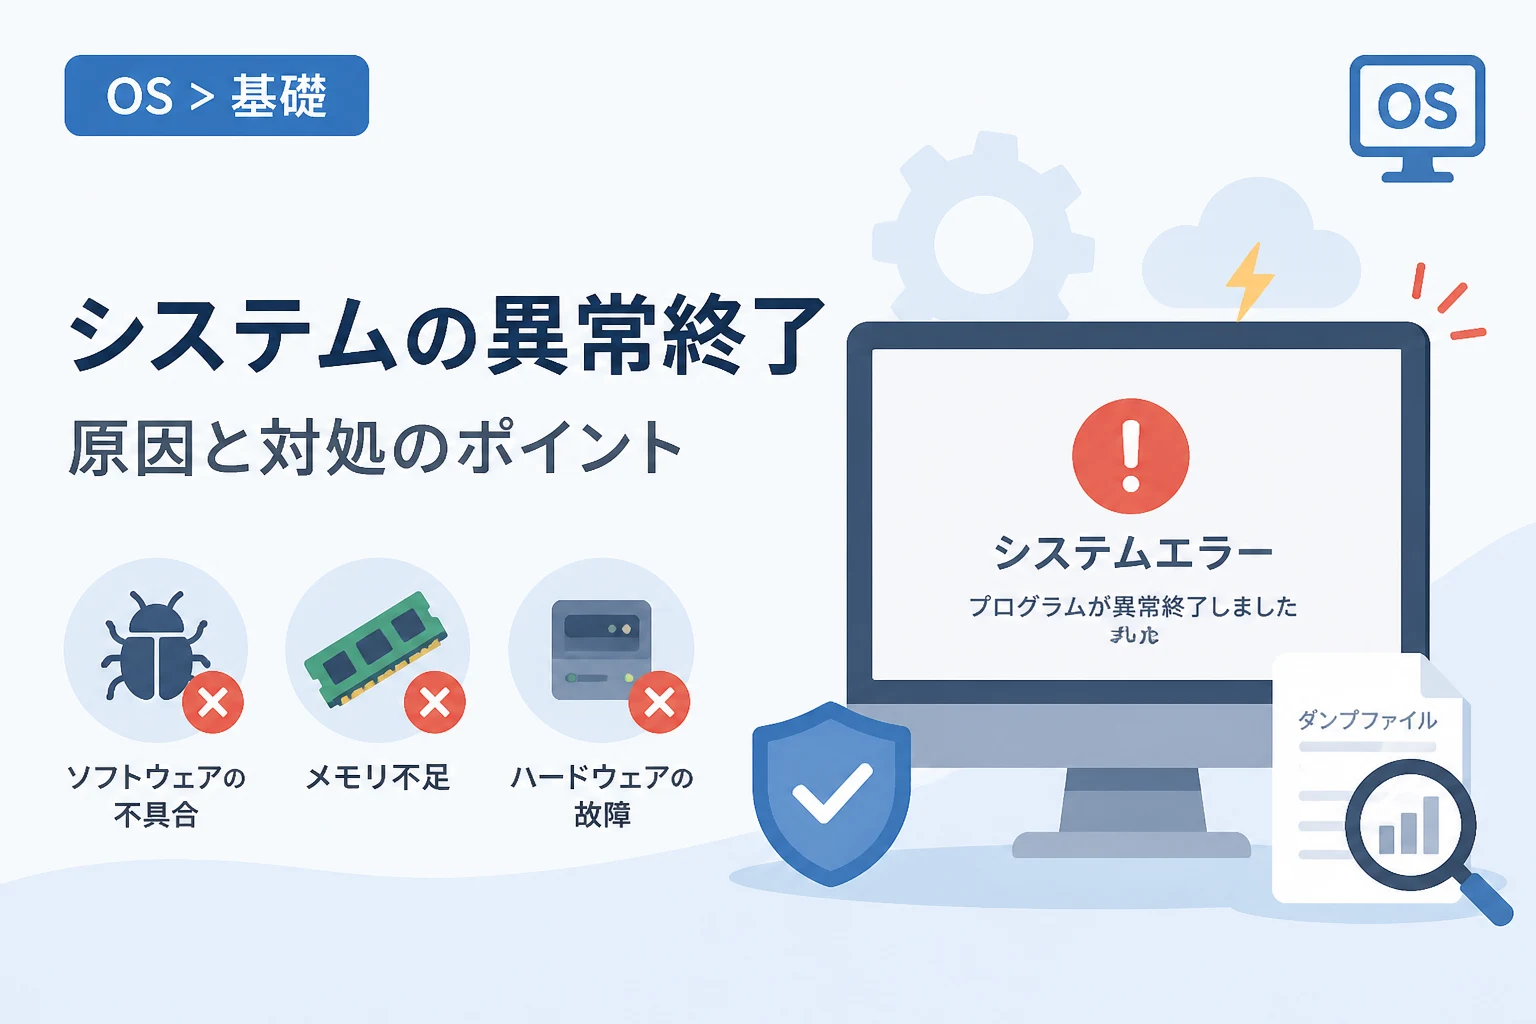
アベンドが発生したとき、OSは通常「ダンプファイル」と呼ばれるログを出力し、その時のメモリの状態を記録します。
この記録を解析することで、エンジニアはプログラムのどの箇所で致命的なエラーが起きたのかを探り当てることが可能になります。
OSがアベンドを引き起こす仕組み
OSがなぜプログラムをアベンドさせるのかというと、それはシステム全体の崩壊を防ぐための防御反応であると言えます。
もし異常な動作を続けるプログラムを放置してしまえば、他の正常なアプリケーションのメモリ領域を破壊したり、CPUを占有し続けたりする恐れがあります。
このような最悪のシナリオを避けるために、OSにはプログラムの動作を監視し、異常を検知した瞬間に強制停止させる仕組みが備わっています。
ハードウェア割り込みによる検知
CPUには「例外処理」という仕組みがあり、不正な計算や禁止されたメモリへのアクセスが発生した際に、実行中の処理を中断してOSのカーネルに制御を移します。
例えば、ゼロによる除算(0で割る計算)や、割り当てられていないメモリ番地への読み書きなどがこれに該当します。
OSはこの割り込み信号を受け取ると、該当するプログラムが回復不能なエラーを起こしたと判断し、プロセスを強制終了させます。
カーネルによるリソース監視
OSの核となるカーネルは、各プロセスが使用しているメモリ量や実行時間を常に管理しています。
特定のプロセスがシステムのリソースを過度に浪費し、OS自体の動作を脅かすような状況になった場合、カーネルはそのプロセスを「アベンド」させます。
Linuxなどで有名な「OOM Killer(Out of Memory Killer)」は、メモリ不足時に優先度の低いプロセスを強制終了させる仕組みの一種です。
アベンドが発生する主な原因
アベンドが起こる理由は多岐にわたりますが、大きく分けると「ソフトウェアの不具合」「リソースの枯渇」「ハードウェアのトラブル」の3つに分類できます。
1. ソフトウェアのバグ(論理エラー)
アベンドの最も一般的な原因は、プログラム内部の設計ミスや記述ミス、いわゆるバグです。
特定の条件下でのみ発生する「ヌルポインタ参照」などは、現代のプログラミングにおいてもアベンドの主要な引き金となります。
また、計算結果が変数の保持できる範囲を超えてしまう「オーバーフロー」も、システムの異常終了を招く要因です。
2. メモリ不足やディスクフル(リソース不足)
物理的なリソースが不足することも、アベンドの直接的な原因となります。
プログラムがメモリを確保しようとした際に、空き領域が一切残っていなければ、それ以上の動作を続けることができません。
同様に、ログ出力などでディスク容量を使い果たし、システムが一時ファイルを作成できなくなった場合も、異常終了が発生しやすくなります。
3. ハードウェアの故障
メモリチップの物理的な破損や、CPUの熱暴走、ハードディスクの読み取りエラーなどもアベンドを引き起こします。
ソフトウェア側でいくら対策を講じても、基盤となるハードウェアが誤ったデータを返してくる場合には、OSは処理を維持できなくなります。
サーバー室の温度管理不足や経年劣化によるパーツの不具合は、突発的なアベンドを招く典型的なパターンです。
代表的なアベンドコードの例
アベンドが発生した際、システムは原因を特定するための手がかりとして、固有の「アベンドコード」を出力することがあります。
特にメインフレームやエンタープライズ向けのシステムでは、これらのコードが原因究明の大きなヒントになります。
S0C1(オペレーション例外)
「S0C1」は、コンピュータが解釈できない命令を実行しようとした際に発生するコードです。
プログラムが壊れている場合や、メモリアドレスの計算を誤ってデータの領域を実行しようとした際に表示されます。
S0C4(保護例外)
「S0C4」は、許可されていないメモリ領域にアクセスしようとした場合に発生します。
いわゆる「セグメンテーション・フォールト」に相当し、ポインタ変数の扱いミスなどが主な原因です。
S0C7(データ例外)
「S0C7」は、計算に使用するデータの形式が不正である場合に発生するエラーです。
数値が入るべき場所に文字が入っていたり、数値のパッキングが崩れていたりする場合に、演算回路が異常を検知して停止します。
アベンドが発生した際の対処フロー
実際にアベンドが発生してしまった場合、慌てずに適切な手順で対応することが二次被害を防ぐポイントです。
プロの現場で行われる標準的なトラブルシューティングの流れを紹介します。
ステップ1:エラーメッセージとコードの記録
まずは画面に表示されたメッセージや、システムログに出力されたアベンドコードを正確に記録します。
これらの情報は、問題解決のための最も重要な「指紋」となります。
ステップ2:ログとダンプファイルの確認
OSやアプリケーションが出力したエラーログ、およびメモリの状態を記録したダンプファイルを収集します。
ダンプファイルには、アベンドが発生した瞬間のレジスタの値やスタックの情報が含まれており、詳細な解析が可能です。
ステップ3:直近の変更履歴の確認
アベンドが発生する直前に、システムの設定変更や新しいパッチの適用を行わなかったかを確認します。
多くのトラブルは、環境の変化がきっかけとなって顕在化するため、変更履歴の把握は原因特定の近道です。
ステップ4:暫定的な復旧と本質的な修正
業務への影響を最小限にするため、まずはサービスの再起動などの暫定処置を行い、その後にプログラムの修正やリソースの増設といった恒久的な対策を実施します。
再起動だけで問題が解決したように見えても、根本原因が残っていれば必ず再発することを忘れてはなりません。
アベンドを防ぐための予防策
アベンドを完全にゼロにすることは難しいものの、適切な設計と運用によってその発生頻度を劇的に下げることは可能です。
安定したシステムを構築するために取り組むべき主要なポイントを解説します。
堅牢なエラーハンドリングの実装
プログラム内部で予期せぬ入力があったとしても、すぐにアベンドするのではなく、適切にエラーをキャッチして処理を継続、あるいは安全に停止させる設計が必要です。
例外処理(try-catchなど)を適切に記述することで、異常を局所化し、システム全体への波及を防ぐことができます。
徹底したテストの実施
ユニットテストだけでなく、負荷テストや異常系テストを実施し、極限状態での挙動を事前に確認しておくことが重要です。
特に境界値テストを行うことで、オーバーフローや配列の範囲外参照といったアベンドの種を事前に取り除くことができます。
監視体制の強化
サーバーのリソース使用状況をリアルタイムで監視し、閾値を超えそうになった時点でアラートを出す仕組みを構築します。
メモリ使用率が80%を超えた段階で対応を開始すれば、メモリ不足によるアベンドを未然に防ぐことが可能です。
# メモリ使用率を監視するシンプルなスクリプト例
free -m | awk 'NR==2{printf "Memory Usage: %s/%sMB (%.2f%%)\n", $3, $2, $3*100/$2 }'Memory Usage: 4096/8192MB (50.00%)まとめ
アベンド(ABEND)は、システムが継続不能な致命的エラーに直面した際に、OSや環境によって実行される強制的な「異常終了」のことです。
その背景には、システム全体の安全を守るためのOSの保護機能があり、決して単なるエラーとして片付けられるものではありません。
アベンドが発生した際には、エラーコードやログ、ダンプファイルを丹念に分析することが、根本原因の特定に繋がります。
日頃から堅牢なエラーハンドリングを心がけ、適切なリソース管理を行うことで、アベンドに強い安定したシステムを維持していきましょう。
この記事を通じて、アベンドの仕組みと対処法への理解が深まり、皆様のIT運用の現場で役立つことを願っています。