プログラミングの世界には、膨大なデータを効率的かつ安全に処理するための仕組みが数多く存在します。
その中でも、データの集合体から要素を一つずつ取り出す仕組みである「イテレータ(反復子)」は、現代のプログラミングにおいて欠かせない概念です。
イテレータを理解することで、配列やリストといったデータ構造の違いを意識せずに、統一された手法で繰り返し処理を記述できるようになります。
本記事では、イテレータの基本的な定義から具体的な仕組み、そして主要なプログラミング言語での活用方法までを詳しく解き明かしていきます。
イテレータ(反復子)の定義と基本的な概念
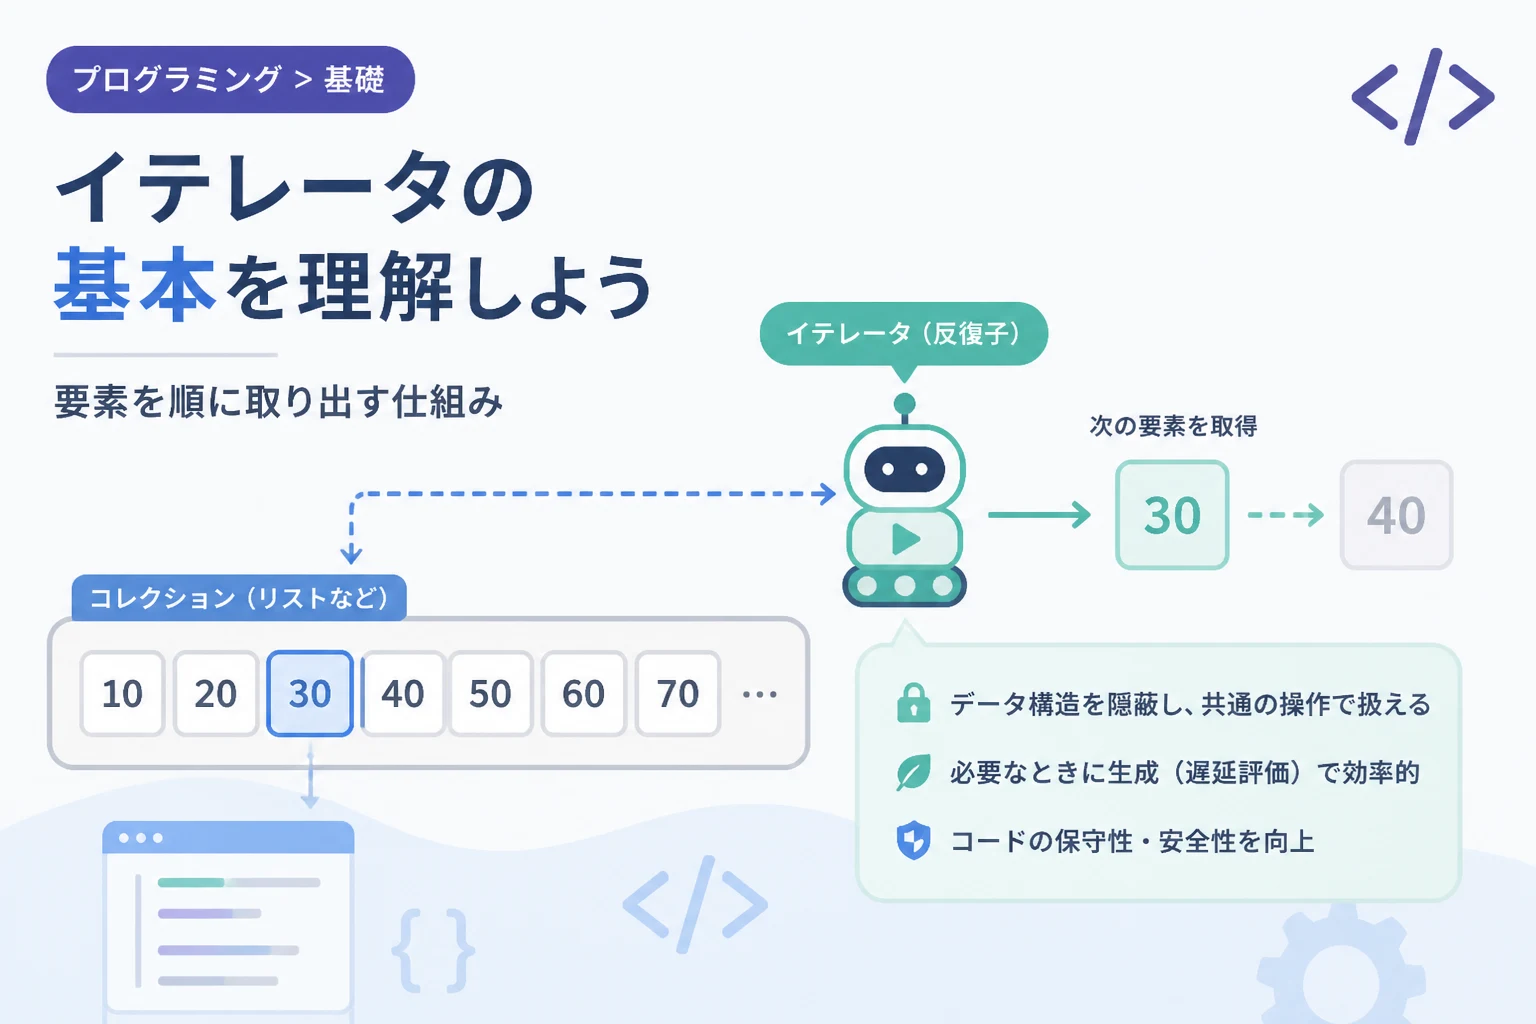
イテレータとは、英語の「iterate(反復する)」に由来する言葉で、配列やリストなどの集合体(コンテナ)の要素に順番にアクセスするためのオブジェクトを指します。
日本語では「反復子(はんぷくし)」とも呼ばれ、データ構造の内部設計を隠蔽したまま、要素を走査する手段を提供します。
通常、配列の要素にアクセスする場合はインデックス番号(添字)を使用しますが、イテレータはこの直接的なアクセスを抽象化します。
プログラマは、データがどのようにメモリ上に配置されているかを気にすることなく、「次の要素を取得する」という共通の操作だけで処理を進めることができます。
この抽象化こそが、大規模なシステム開発においてプログラムの柔軟性と保守性を高める重要な鍵となります。
イテレータが求められる背景と役割
なぜ、単なるループ処理ではなくイテレータという特別な仕組みが必要とされるのでしょうか。
その最大の理由は、データ構造とアルゴリズムの分離にあります。
例えば、データを管理する方法には配列、連結リスト、ツリー構造、ハッシュマップなど、さまざまな形式が存在します。
もしイテレータがなければ、それぞれのデータ構造ごとに異なるループの書き方をしなければなりません。
配列であれば for(int i=0; i<len; i++) と書き、連結リストであればポインタを辿る複雑な処理を記述する必要があります。
イテレータを導入することで、どのようなデータ構造であっても「イテレータから次の値をもらう」という単一のインターフェースで統一できます。
これにより、データ構造を後から変更しても、それを利用する側のコードを書き換える必要がなくなるというメリットが生まれます。
イテレータの内部的な仕組み
イテレータは、内部的に「現在の位置」を保持する状態を持っています。
一般的に、イテレータは以下の2つの主要な機能を備えています。
- 次に進める要素があるかどうかを確認する機能
- 現在の要素を返し、カーソルを次の要素へ進める機能
これらの機能により、データの末尾に到達するまで安全に繰り返し処理を継続することが可能になります。
多くのプログラミング言語では、next() や hasNext() といったメソッド名でこれらの機能が提供されています。
また、イテレータ自身がデータのコピーを持つわけではなく、あくまで元のデータ構造への参照を保持している点も特徴です。
そのため、大量のデータを扱う際にもメモリ消費を抑えながら、効率的に走査を行うことができます。
「Iterable(イテラブル)」と「Iterator(イテレータ)」の違い
イテレータを学ぶ際によく混同されるのが、「イテラブル」という概念です。
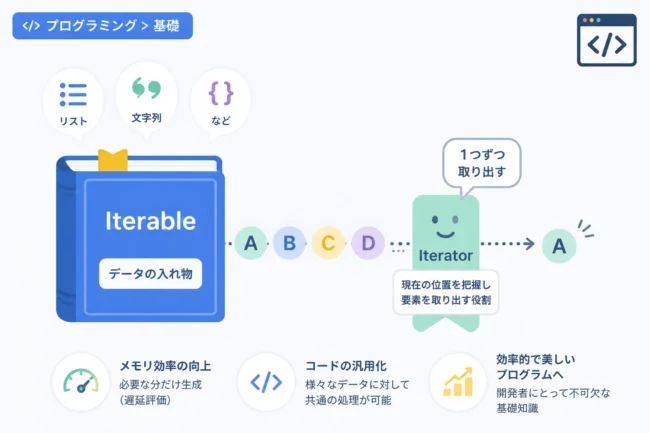
イテラブルとは、「イテレータを生成することができるオブジェクト」を指します。
例えば、PythonのリストやJavaScriptの配列はイテラブルであり、それ自体がイテレータではありません。
イテラブルなオブジェクトに対して特定の操作を行うことで、初めて状態を持ったイテレータが生成されます。
この関係性は、本(イテラブル)と、今どのページを読んでいるかを示すしおり(イテレータ)に例えると分かりやすいでしょう。
主要なプログラミング言語におけるイテレータの実装
現代の主要な言語では、言語仕様のレベルでイテレータが強力にサポートされています。
いくつかの代表的な言語における実装例を見ていきましょう。
Pythonにおけるイテレータ
Pythonでは、__iter__() メソッドと __next__() メソッドを持つオブジェクトがイテレータとして定義されます。
for 文を使用する際、Pythonは内部で自動的にイテレータを生成して処理を行っています。
# リスト(イテラブル)の定義
my_list = [10, 20, 30]

# イテレータの取得
my_iterator = iter(my_list)

# 要素の取り出し
print(next(my_iterator))
print(next(my_iterator))10
20Pythonでは、これ以上取り出す要素がない場合に StopIteration という例外を投げることでループの終了を通知します。
Javaにおけるイテレータ
Javaでは、java.util.Iterator インターフェースが用意されています。
ArrayList などのコレクションクラスからイテレータを取得して操作するのが一般的です。
import java.util.ArrayList;
import java.util.Iterator;

public class Main {
    public static void main(String[] args) {
        ArrayList<String> list = new ArrayList<>();
        list.add("Apple");
        list.add("Banana");

        Iterator<String> it = list.iterator();
        while (it.hasNext()) {
            System.out.println(it.next());
        }
    }
}Apple
BananaJavaの Iterator は、remove() メソッドを使用して走査中に安全に要素を削除できるという特徴もあります。
JavaScriptにおけるイテレータ
JavaScript(ES6以降)では、Symbol.iterator を用いてイテレータプロトコルが定義されました。
これにより、独自のオブジェクトに対しても for...of ループを適用できるようになります。
const array = ['a', 'b', 'c'];
const iterator = array[Symbol.iterator]();

console.log(iterator.next());
console.log(iterator.next());{ value: 'a', done: false }
{ value: 'b', done: false }JavaScriptの next() メソッドは、値と終了フラグを含むオブジェクトを返す形式をとっています。
イテレータを利用するメリット
イテレータを利用することには、単にコードを統一する以上の大きなメリットがあります。
1. メモリ効率の向上(遅延評価)
イテレータの大きな利点の一つは、必要なときに必要な分だけデータを生成できる点にあります。
これを「遅延評価」と呼びます。
例えば、100万個の要素を持つリストをすべてメモリに展開すると、膨大なリソースを消費します。
しかし、イテレータを使えば、一度に1つの要素しかメモリに載せないため、非常に軽量に動作します。
極端な例では、無限に続く数列であっても、イテレータなら扱うことが可能です。
2. カプセル化の促進
データ構造の内部がどのようになっているかを、外部のプログラムに知らせる必要がありません。
リスト構造が配列で実装されているのか、双方向連結リストなのかを意識せずに、同じ next() 操作でアクセスできます。
これにより、「実装の詳細」と「利用する方法」を切り離すことができ、堅牢な設計が可能になります。
3. 破壊的な操作の防止
通常の for ループでインデックスを操作している際、ループ内で要素を削除したり追加したりすると、意図しないバグ(インデックスのズレなど)が発生しやすくなります。
イテレータを介して操作することで、言語側が提供する安全な走査の仕組みを利用でき、プログラムの安全性が向上します。
デザインパターンとしてのイテレータ
イテレータは、GoF(Gang of Four)による「デザインパターン」の一つとしても定義されています。
このパターンでは、アグリゲート(集合体)とその要素を走査するイテレータを明確に分離します。
オブジェクト指向設計において、クラスの責務を最小限に抑える「単一責任の原則」を体現したパターンと言えます。
自分で複雑なデータ構造を持つクラスを設計する際、このイテレータパターンを適用することで、ユーザーにとって使いやすいインターフェースを提供できるようになります。
イテレータとジェネレータの関係
イテレータをより簡単に作成するための仕組みとして、「ジェネレータ」という機能を持つ言語が多いです。
イテレータをクラスとして一から実装する場合、現在の状態を保持する変数の管理など、記述が煩雑になりがちです。
ジェネレータを使用すると、yield キーワードなどを用いて、関数の実行を一時停止し、値を返した後に再開するという処理が簡単に書けます。
内部的には、このジェネレータが自動的にイテレータインターフェースを実装したオブジェクトを生成してくれます。
効率的なデータ処理を簡潔に記述したい場合は、ジェネレータの活用も併せて検討すると良いでしょう。
イテレータを使用する際の注意点
非常に便利なイテレータですが、使用する上で注意すべき点もいくつか存在します。
1. 一方向の走査
多くの基本的なイテレータは、一方向にしか進むことができません。
一度 next() で進んでしまうと、前の要素に戻るためには、新しいイテレータを再生成する必要があります。
双方向の移動が必要な場合は、ListIterator(Java)などの特別なインターフェースが提供されているか確認が必要です。
2. 並行操作によるエラー
イテレータで走査している最中に、別のスレッドや処理から元のコレクションを直接書き換えると、不整合が発生します。
Javaなどでは ConcurrentModificationException が発生し、プログラムが停止する原因となります。
走査中のデータ操作には、イテレータ自身のメソッドを使用するか、コレクションのコピーに対して操作を行うなどの対策が必要です。
3. 使い捨ての性質
イテレータは一度最後まで走査し終えると、その役割を終えます。
同じデータをもう一度ループさせたい場合は、再度イテラブルオブジェクトからイテレータを取得し直さなければならない点を忘れないようにしましょう。
まとめ
イテレータ(反復子)は、データの集合体を抽象化し、統一された手法で要素へアクセスするための強力な仕組みです。
「データ構造の詳細を隠蔽する」「メモリ効率を最適化する」「コードの再利用性を高める」という、プログラミングにおける重要な課題を解決してくれます。
普段何気なく使用している for-each 文やリスト操作の裏側では、このイテレータが重要な役割を果たしています。
各種プログラミング言語での具体的な実装方法を理解し、適切に使い分けることで、より洗練された美しいコードを書くことができるようになるでしょう。
特に大規模なデータ処理やストリーミング処理を扱う際には、イテレータの概念を正しく適用することが、システムのパフォーマンスに直結します。
本記事を通じて、イテレータという概念が持つ奥深さとその実用性を再確認していただければ幸いです。