チェスや将棋、囲碁といったボードゲームにおいて、コンピュータが次の一手を決定する際に不可欠な技術が「探索アルゴリズム」です。
膨大な選択肢の中から最適な答えを導き出すためには、すべての可能性を計算するのではなく、無駄な計算を省く知的な戦略が求められます。
その中核を担う手法の一つが、今回解説する「αβ法(アルファベータ法)」です。
αβ法は、基本的な探索アルゴリズムであるミニマックス法を劇的に効率化し、限られた時間内でより深く、より正確な読みを実現するために考案されました。
この記事では、プログラミングやAI開発の基礎知識として欠かせないαβ法の仕組みから、実装時に役立つテクニックまでを詳しく解き明かしていきます。
αβ法(アルファベータ法)とは何か
αβ法は、二人零和有限確定完全情報ゲームにおける最善手探索アルゴリズムの一種です。
二人零和有限確定完全情報ゲームとは、運の要素がなく、互いの情報がすべて公開されており、一方が得をすれば他方が損をするという性質を持つゲームを指します。
この手法は、基礎となる「ミニマックス法」の改良版として広く知られています。
ミニマックス法は「自分が利益を最大化し、相手がこちらの利益を最小化する」という前提で思考するアルゴリズムです。
しかし、ミニマックス法をそのまま適用すると、ゲームの進行とともに探索すべきノード数が指数関数的に増大してしまいます。
そこで、「結果に影響を与えないことが明らかな枝」を途中で切り捨てることで、探索効率を飛躍的に高めたのがαβ法です。
この「不要な枝を切り捨てる」プロセスは一般に「枝刈り(Pruning)」と呼ばれます。
αβ法を正しく理解することは、ゲームAIの開発だけでなく、効率的な探索アルゴリズムの設計思想を学ぶ上でも非常に重要です。
基礎となるミニマックス法の概念
αβ法を深く理解するためには、まずその土台となるミニマックス法の仕組みを整理しておく必要があります。
ミニマックス法では、自分の手番を「MAXノード(スコアを最大化したい)」、相手の手番を「MINノード(スコアを最小化したい)」として定義します。
探索はゲームのツリー構造を深さ優先で行われ、末端の「葉ノード」に到達した時点で評価関数によって局面の価値が数値化されます。
評価値が正であれば自分に有利、負であれば相手に有利であると判断されます。
MINノードは、自分の子ノードの中から最も小さい値を選んで親ノードに伝えます。
一方で、MAXノードは、自分の子ノードの中から最も大きい値を選んで親ノードに伝えます。
このプロセスを交互に繰り返すことで、最終的に現在の局面から得られる「最善の期待値」が算出されます。
しかし、この手法の弱点は、最終的な判断に関係のない枝まですべて探索してしまうという点にあります。
そこで登場するのが、探索の限界を打破するためのαβ法です。
αβ法のアルゴリズムの仕組みと「枝刈り」
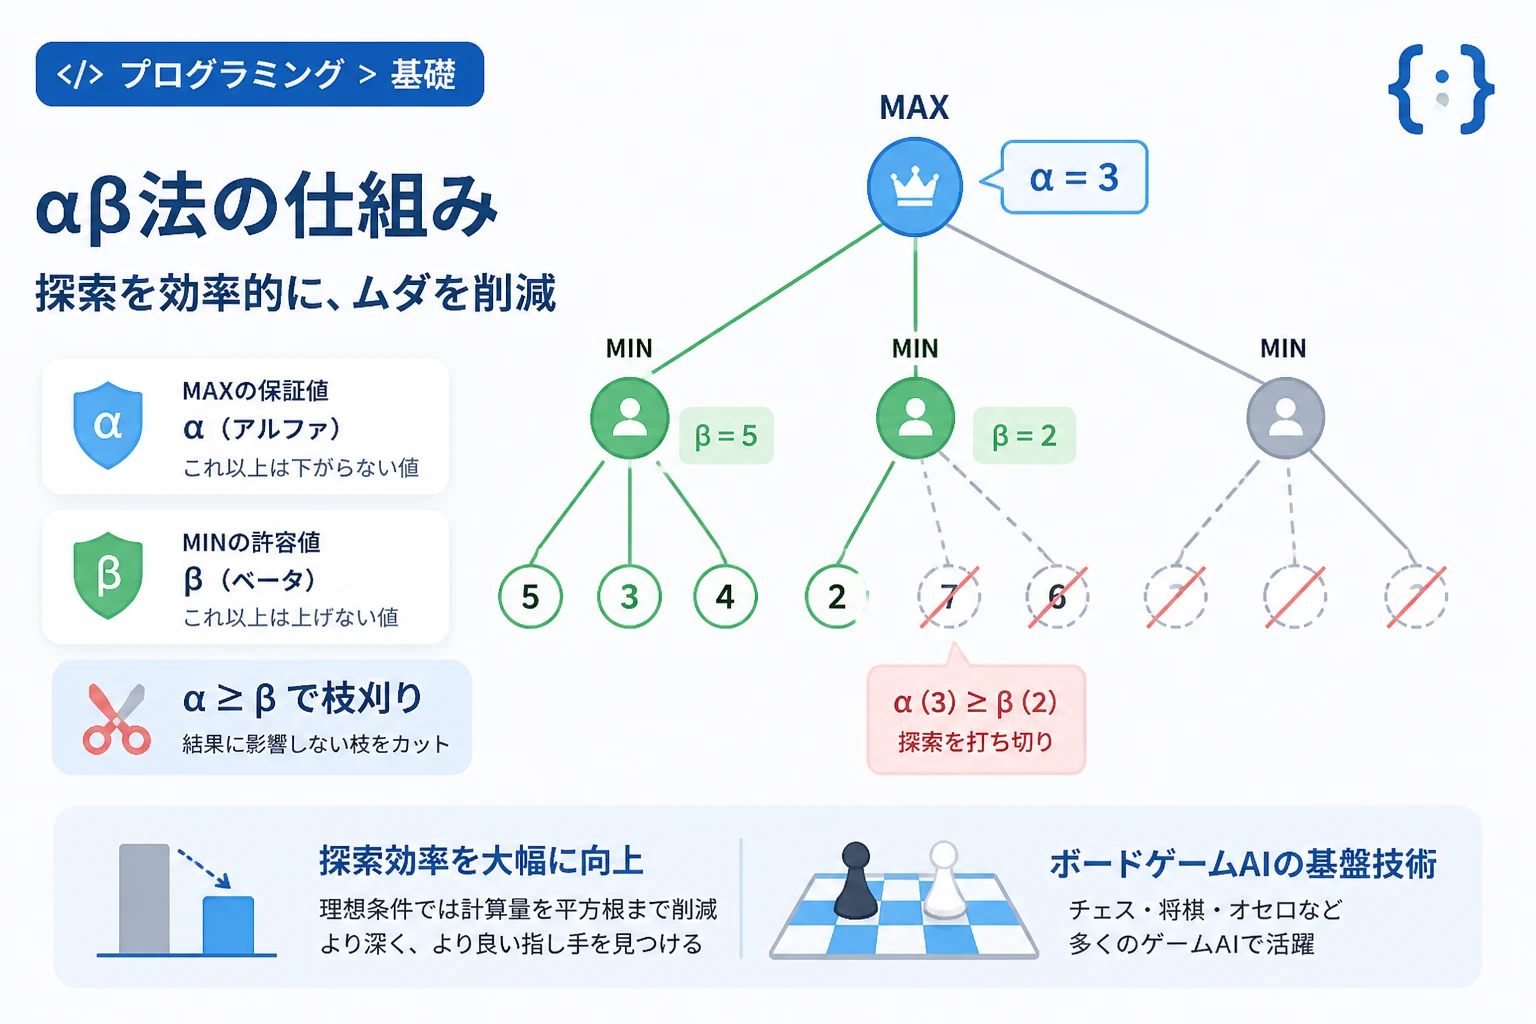
αβ法は、探索中に「α値」と「β値」という二つの閾値を持ち回り、不要な探索を中止します。
ここでは、それぞれの値の役割と、どのように枝刈りが行われるのかを具体的に見ていきましょう。
α値とβ値の役割
α値とは、「MAXプレイヤーがこれまでに保証されている最低スコア」を指します。
探索が進むにつれて、より良い手が見つかればα値は更新(増加)していきます。
一方でβ値とは、「MINプレイヤーがこれまでに許容している最大スコア」を指します。
相手(MIN)にとっても、より自分に有利な(スコアが低い)手が見つかれば、β値は更新(減少)していきます。
探索の初期状態では、α値はマイナス無限大、β値はプラス無限大に設定されます。
枝刈りが発生する条件
探索の途中で、「α値がβ値を上回った、または等しくなった(α ≧ β)」とき、その枝の先を探索する必要がなくなります。
なぜなら、その経路を進んでも、既に判明している他の経路よりも良い結果が得られないことが論理的に確定するためです。
具体例を挙げて考えてみましょう。
あるMAXノードにおいて、既に評価値が「5」の手(α=5)が見つかっているとします。
次に、別の枝にあるMINノードを探索中、その子ノードの一つから評価値「3」が返ってきたとします。
この時点でMINノードは「3以下の値」を返すことが確定し、MAXノードが既に持っている「5」を上回ることは絶対にありません。
したがって、このMINノードの残りの子ノードを調べる必要はなくなり、探索を打ち切ることができます。
これが「βカット」と呼ばれる枝刈りのプロセスです。
逆に、MINノード側で同様の論理によって探索を打ち切ることを「αカット」と呼びます。
αβ法の探索効率と計算量
αβ法を導入することで、どれほどの効率化が期待できるのでしょうか。
探索効率は、ノードが展開される順番、つまり「手の並び順」に大きく依存します。
理想的なケース(Best Case)
もし、各ノードにおいて常に最も良い手が最初に探索された場合、探索効率は最大化されます。
理想的な条件下では、αβ法はミニマックス法と同じ深さを、およそ半分の計算量(ノード数の平方根)で探索することが可能です。
これは、同じ時間制限であれば、ミニマックス法よりも約2倍の深さまで読めることを意味します。
計算量理論の観点では、分岐数をb、深さをdとしたとき、通常のミニマックス法が O(b^d) であるのに対し、理想的なαβ法は O(b^(d/2)) となります。
最悪のケース(Worst Case)
逆に、常に最も悪い手から順番に探索してしまった場合、一度も枝刈りが発生しません。
この場合、探索効率はミニマックス法と全く変わらず、O(b^d) の計算量が必要となります。
したがって、αβ法の実装においては「手のオーダリング(並び替え)」が極めて重要な役割を果たします。
αβ法のプログラム実装例
ここでは、Python風の疑似コードを用いて、αβ法の再帰的なアルゴリズムの実装例を紹介します。
このコードは、現在の深さ、α値、β値、および現在がMAXプレイヤーの手番かどうかを引数に取ります。
def alphabeta(node, depth, alpha, beta, is_max_player):
    # 深さの上限に達するか、終局ノードであれば評価値を返す
    if depth == 0 or node.is_terminal():
        return node.evaluate()

    if is_max_player:
        value = -float('inf')
        for child in node.get_children():
            # 子ノードを再帰的に探索し、最大値を選択する
            value = max(value, alphabeta(child, depth - 1, alpha, beta, False))
            alpha = max(alpha, value)
            # α値がβ値を上回ったら枝刈り
            if alpha >= beta:
                break
        return value
    else:
        value = float('inf')
        for child in node.get_children():
            # 子ノードを再帰的に探索し、最小値を選択する
            value = min(value, alphabeta(child, depth - 1, alpha, beta, True))
            beta = min(beta, value)
            # α値がβ値を上回ったら枝刈り
            if alpha >= beta:
                break
        return value

# 実行の呼び出し例(初期値としてαは最小、βは最大を設定)
# result = alphabeta(root_node, 5, -float('inf'), float('inf'), True)
このプログラムのポイントは、再帰呼び出しのたびに最新のα値とβ値を子ノードへ引き継いでいる点です。
そして、条件 alpha >= beta が満たされた瞬間にループを抜けることで、後続のノード探索をスキップしています。
実装における重要ポイント:手のオーダリング
先述した通り、αβ法の真価を発揮させるには、探索の順番を工夫する必要があります。
ここでは、実践的な開発で用いられる代表的なオーダリング手法を紹介します。
キラーヒューリスティック
「ある枝で枝刈りを発生させた手は、別の枝でも有効な手である可能性が高い」という仮説に基づいた手法です。
枝刈りを引き起こした強力な手を記憶しておき、他のノードでも優先的に探索することで、早い段階での枝刈りを狙います。
反復深化(Iterative Deepening)
最初から深いところまで探索するのではなく、深さ1、深さ2、深さ3……と段階的に探索を深めていく手法です。
一見無駄に見えますが、浅い探索で得られた「有望な手」の情報を次の深い探索のオーダリングに利用できるため、結果として全体の探索時間を短縮できます。
また、制限時間が来た時点で探索を打ち切り、そこまでの最善手を返すことができるため、実戦的なゲームAIでは必須の技術です。
置換表(Transposition Table)
ゲーム中には、異なる手順を経て全く同じ局面に到達することが多々あります。
一度探索した局面の評価値や探索結果(α値やβ値の情報)をハッシュテーブルに保存しておくことで、二度手手間を省く仕組みです。
これにより、重複する探索を劇的に減らし、実質的な探索深度を向上させることができます。
αβ法の応用と関連アルゴリズム
αβ法は非常に強力ですが、さらに発展させたバリエーションも存在します。
代表的なものに「PVS(Principal Variation Search)」や「NegaScout」があります。
これらは「最善手は一つであり、他の手はそれよりも悪い」という前提をより強く利用し、さらに探索窓を狭めることでαβ法以上の効率化を目指したものです。
また、静止画探索(Quiescence Search)と呼ばれる手法も重要です。
探索の末端で駒の取り合いが発生している場合、単純に探索を打ち切ると「水平線効果」と呼ばれる誤評価が起こりやすくなります。
静止画探索を導入することで、局面が落ち着くまで探索をわずかに延長し、評価の精度を高めることができます。
αβ法のメリットとデメリット
ここで改めて、αβ法の利点と欠点を整理しておきましょう。
| 特徴 | 内容 |
|---|---|
| メリット:探索の高速化 | ミニマックス法と比較して、計算量を劇的に削減できる。 |
| メリット:メモリ効率 | 深さ優先探索をベースとしているため、必要なメモリ量は探索深度に対して線形である。 |
| デメリット:オーダリング依存 | 手の並び順が悪いと、枝刈りの効果が薄れてしまう。 |
| デメリット:評価関数の限界 | どれだけ深く探索しても、最終的な精度は評価関数の質に左右される。 |
現代のゲームAIにおけるαβ法の位置づけ
近年では、ディープラーニングを用いたモンテカルロ木探索(MCTS)が囲碁などで脚光を浴びました。
しかし、チェスや将棋のような「王を詰ませる」という明確なゴールがあるゲームでは、依然としてαβ法をベースとした探索が強力なパフォーマンスを発揮します。
特に、高速なCPUを用いた短時間の計算においては、αβ法の確定的な読みが非常に有利に働きます。
現代の将棋ソフトにおいても、評価関数にニューラルネットワーク(NNUEなど)を使いつつ、探索アルゴリズムの基盤にはαβ法の発展形が採用されている例が多く見られます。
プログラミングの学習においても、再帰処理や最適化の考え方を学ぶための格好の題材と言えるでしょう。
まとめ
αβ法は、無駄な探索を論理的に排除することで、ゲームAIの思考を劇的に加速させる優れたアルゴリズムです。
ミニマックス法というシンプルな基盤の上に、α値とβ値による境界条件を設けるだけで、計算量を最大で平方根にまで抑えられる点は非常にエレガントです。
実装の際には、いかに早く「良い手」を見つけて枝刈りを発生させるかという、オーダリングの工夫が成功の鍵を握ります。
本記事を通じて、αβ法の理論的背景から具体的な実装のイメージまで、理解を深めていただけたでしょうか。
プログラミングを通じてボードゲームの思考エンジンを作ってみたい方は、ぜひこのαβ法の実装に挑戦してみてください。
効率的なアルゴリズムがもたらす驚異的なスピードアップを、身をもって体感できるはずです。