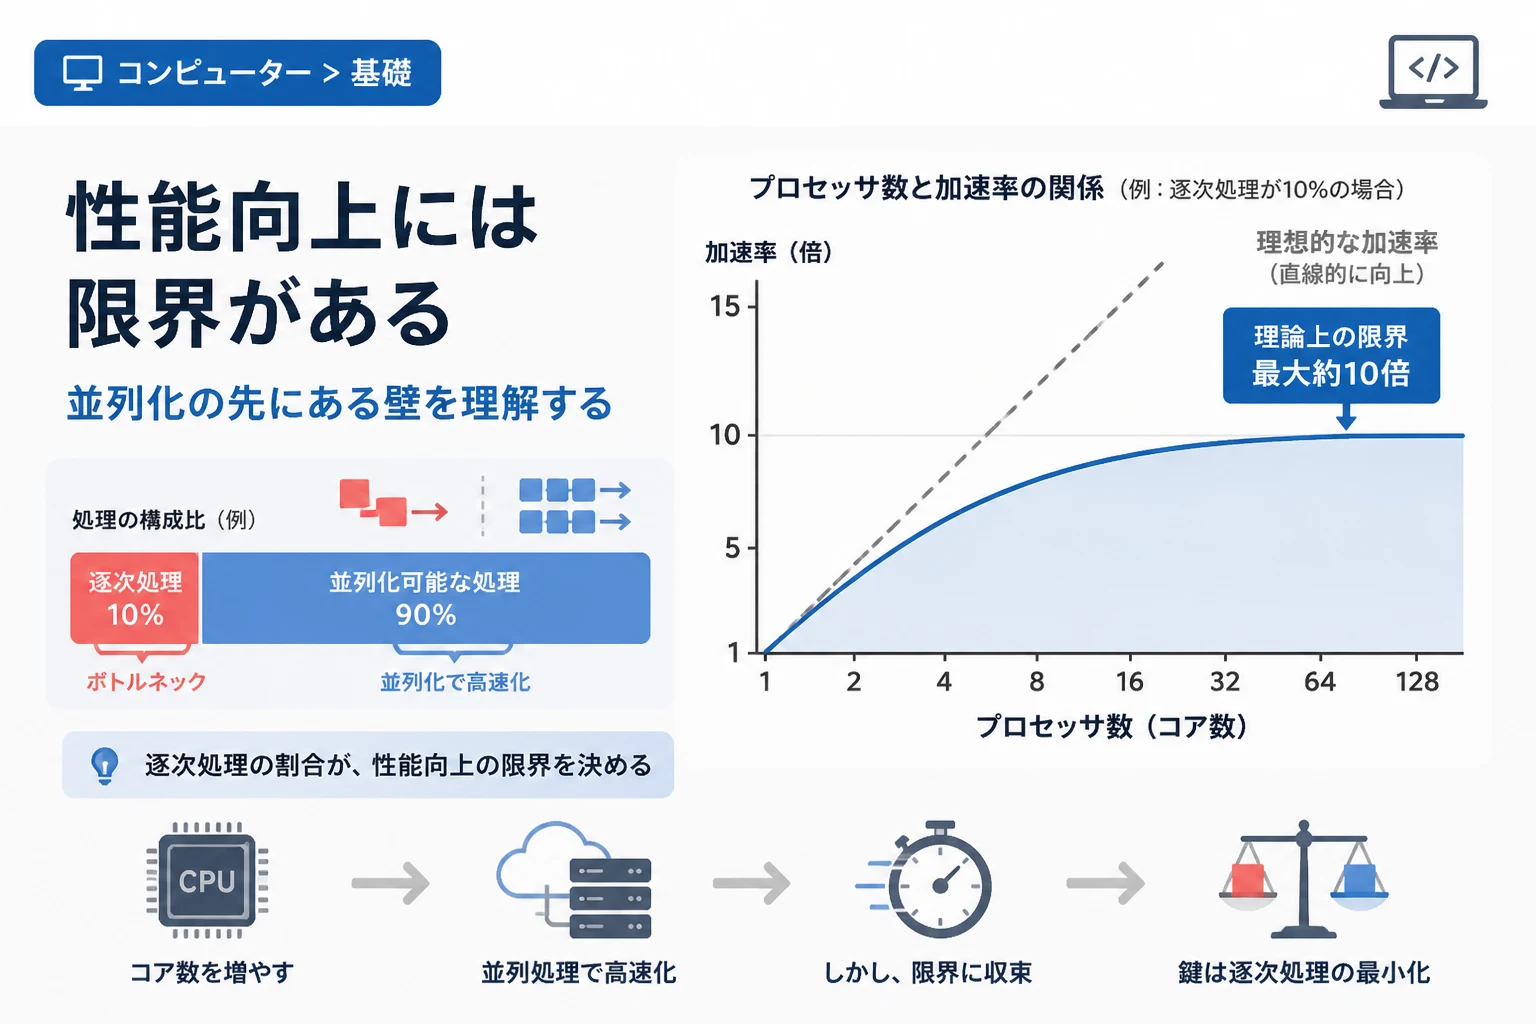
コンピューターの性能を向上させる手法として、複数のプロセッサで同時に処理を行う「並列処理」は欠かせない技術となっています。
しかし、プロセッサの数を増やせば増やすほど、処理速度が比例して無限に速くなるわけではありません。
この「並列化による性能向上の限界」を数式で示したのが、コンピューター科学における重要な理論であるアムダールの法則(Amdahl’s law)です。
1967年にジーン・アムダールによって提唱されたこの法則は、システムの最適化を行うエンジニアやアーキテクトにとって、現在でも避けては通れない指針となっています。
本記事では、アムダールの法則の定義から計算式の使い方、そして現代のコンピューティングにおける意味について詳しく解説します。
アムダールの法則の基礎知識
アムダールの法則とは、プログラムの性能向上において、全体の処理のうち並列化できない部分がボトルネックとなり、全体の加速率を制限するという法則です。
どのようなプログラムであっても、データの依存関係や入出力の制限により、どうしても順番に実行しなければならない「逐次処理(シリアル処理)」の部分が残ります。
たとえ1,000個のプロセッサを用意したとしても、この逐次処理部分が10%存在すれば、全体の処理時間は元の10%以下には短縮されません。
つまり、並列化による恩恵は「並列化可能な部分の割合」に完全に依存することを意味しています。
この考え方は、ハードウェアの増強だけでなく、ソフトウェアのアルゴリズムを最適化する際にも非常に重要な視点を与えてくれます。
コンピューターの設計者たちは、いかにしてこの「並列化できない部分」を最小化するかに知恵を絞ってきました。
アムダールの法則を導く計算式
アムダールの法則を具体的に理解するために、まずは基本となる計算式を見ていきましょう。
性能向上率(スピードアップ)を S とすると、数式は次のように定義されます。
S = 1 / ((1 – P) + (P / N))
各変数の意味と役割
この式に含まれる変数は、それぞれ以下の要素を表しています。
- S:システム全体の加速率(元の処理時間に比べて何倍速くなったか)
- P:全体の処理時間のうち、並列化が可能な部分の割合(0から1の範囲)
- 1 – P:並列化が不可能な「逐次処理」の部分の割合
- N:並列実行に投入するプロセッサ(コア)の数
この式からわかるのは、プロセッサ数 N を無限大に増やしたとしても、加速率 S は最終的に 1 / (1 – P) に収束するという事実です。
たとえば、並列化できない部分が全体の20%(1 – P = 0.2)ある場合、どんなに強力なマシンを使っても、元の5倍以上の速度を出すことは理論上不可能です。
具体的な計算例
いくつかのパターンで、実際にどの程度の性能向上が見込めるのかを計算してみましょう。
| 並列化可能な割合 (P) | プロセッサ数 (N) | 理論上の加速率 (S) |
|---|---|---|
| 50% (0.5) | 2個 | 約1.33倍 |
| 50% (0.5) | 100個 | 約1.98倍 |
| 90% (0.9) | 10個 | 約5.26倍 |
| 90% (0.9) | 1000個 | 約9.91倍 |
| 95% (0.95) | 100個 | 約16.8倍 |
この表から明らかなように、並列化可能な割合が50%しかない場合、プロセッサを100個に増やしても速度は2倍にも届きません。
一方で、並列化可能な割合を95%まで高めることができれば、プロセッサを増やすメリットが格段に大きくなります。
以下のコードは、Pythonを使ってアムダールの法則による加速率を計算するシミュレーションプログラムです。
def amdahls_law(p, n):
    """
    アムダールの法則に基づき加速率を計算する
    :param p: 並列化可能な割合 (0.0 to 1.0)
    :param n: プロセッサ数
    :return: 加速率 (S)
    """
    # 逐次処理部分の割合
    serial_part = 1 - p

    # 計算式を適用
    speedup = 1 / (serial_part + (p / n))
    return speedup

# 実行例:並列化可能割合90%、プロセッサ数16の場合
p_ratio = 0.9
processors = 16
result = amdahls_law(p_ratio, processors)

print(f"並列化可能な割合: {p_ratio * 100}%")
print(f"プロセッサ数: {processors}")
print(f"理論上の加速率: {result:.2f}倍")並列化可能な割合: 90.0%
プロセッサ数: 16
理論上の加速率: 6.40倍並列化における「収穫逓減」の法則
アムダールの法則が示唆するもう一つの重要な点は、「収穫逓減」の現象です。
収穫逓減とは、投資(この場合はプロセッサ数)を増やし続けても、それによって得られる利益(性能向上)が次第に小さくなっていくことを指します。
たとえば、並列化可能な割合が90%のシステムにおいて、プロセッサを1個から2個に増やすと、性能は約1.8倍に跳ね上がります。
しかし、プロセッサを100個から200個に増やしたとしても、性能は9.17倍から9.57倍へと、わずか0.4倍分しか向上しません。
このように、ある一定以上のリソース投入は、コストに見合った成果をもたらさなくなります。
インフラのコストパフォーマンスを最適化するためには、この飽和点を正確に見極める必要があります。
アムダールの法則が示す限界の正体
なぜプロセッサを増やしても速度が頭打ちになるのか、その理由をより深く掘り下げてみましょう。
主な要因は、大きく分けて「逐次処理部分の存在」と「並列化に伴うオーバーヘッド」の2点に集約されます。
逐次処理部分の重要性
プログラムの中には、どうしても順番を守らなければならない工程が必ず含まれています。
例えば、データの入力待ち、計算結果の集計、ファイルの書き出し、ユーザーからの入力確認などがこれに当たります。
これらは「前の処理が終わらなければ次の処理を開始できない」というデータ依存性を持っているため、並列化することができません。
アムダールの法則は、この「逃れられない逐次処理」がいかに全体の足を引っ張るかを冷徹に示しています。
並列化に伴うオーバーヘッド
厳密なアムダールの法則の数式には直接含まれませんが、現実のシステムでは「プロセッサ間の通信コスト」も無視できません。
複数のコアが同じメモリ領域にアクセスしようとする際の「メモリ競合」や、データの整合性を保つための「排他制御(ロック)」がパフォーマンスを低下させます。
プロセッサ数が増えれば増えるほど、これらの管理コスト(オーバーヘッド)が増大し、場合によってはプロセッサを増やすことで逆に遅くなる現象さえ発生します。
これを考慮すると、現実の限界はアムダールの法則が示す理論値よりもさらに低い場所にあると言えます。
グスタフソンの法則との違い
アムダールの法則と対比される概念として、グスタフソンの法則(Gustafson’s law)があります。
アムダールの法則が「処理するデータの量は一定」という前提に立っているのに対し、グスタフソンの法則は「プロセッサ数が増えれば、より大きなデータを処理できる」という考え方に基づいています。
アムダールの法則は「同じ仕事をどれだけ早く終わらせるか」という強スケーリングの視点です。
一方、グスタフソンの法則は「同じ時間でどれだけ多くの仕事をこなせるか」という弱スケーリングの視点を重視しています。
スーパーコンピューターのように、巨大なシミュレーションを行う分野では、グスタフソンの法則の考え方がより希望的な展望を与えてくれます。
しかし、一般的なアプリケーション開発やレスポンスタイムの改善においては、アムダールの法則による制約の方が支配的です。
現代のコンピューティングにおける意義
アムダールの法則が提唱されてから半世紀以上が経過しましたが、その価値は全く色褪せていません。
むしろ、ハードウェアの進化が限界を迎えつつある現代において、その重要性は増しています。
マルチコアCPUとメニーコアの時代
かつてのCPUは、単一のコアの動作周波数(クロック数)を上げることで性能を向上させてきました。
しかし、熱密度や電力消費の限界により、現在では複数のコアを搭載するマルチコア化が主流となっています。
8コア、16コア、さらにはサーバー用途の128コアといったプロセッサを効率よく使うためには、プログラムをアムダールの法則に逆らわないように設計しなければなりません。
開発者は「どのように並列化するか」だけでなく、「いかに逐次処理を削ぎ落とすか」という課題に直面しています。
クラウドコンピューティングと分散処理
クラウドサービスの普及により、数千台のサーバーを使って膨大なデータを処理する分散処理技術が一般的になりました。
ここでもアムダールの法則は牙を剥きます。
ネットワークを介した通信は、CPU内部の処理に比べて圧倒的に遅いため、わずかな逐次処理や通信の待ち時間が全体のボトルネックになりやすいからです。
そのため、ビッグデータ処理フレームワーク(Apache Sparkなど)では、データの分割方法や依存関係の排除にアムダールの法則の教訓が活かされています。
GPUコンピューティングの限界
AI(人工知能)の学習などで活躍するGPUは、数千個の小さなコアを持っています。
GPUはグラフィックスや行列演算のような「極めて高い並列性を持つタスク」には最適ですが、条件分岐が多い複雑なロジックには向きません。
プログラムの中に少しでも複雑な逐次処理が混ざっていると、GPUの圧倒的な演算能力は宝の持ち腐れとなってしまいます。
このため、現代のエンジニアリングではCPUとGPUの役割を適切に分担させる、ヘテロジニアス・コンピューティングの設計が重要視されています。
まとめ
アムダールの法則は、プログラムを並列化した際に得られる性能向上の限界を定義する、シンプルかつ強力な指針です。
「逐次処理というボトルネックがある限り、プロセッサを増やすだけでは速度向上に限界がある」という真理を私たちは忘れてはなりません。
性能向上を目指す際には、単にハードウェアを強化するのではなく、まずはプログラム内の逐次処理部分を徹底的に分析することが重要です。
どれほど高度な技術が登場しても、この基本的な法則がコンピューター科学の土台であり続けることは間違いありません。
理論上の限界を理解し、その上で現実的な最適化のバランスを見極めることこそが、優れたエンジニアに求められるスキルと言えるでしょう。
この記事が、アムダールの法則を正しく理解し、効率的なシステム開発に役立てる一助となれば幸いです。