
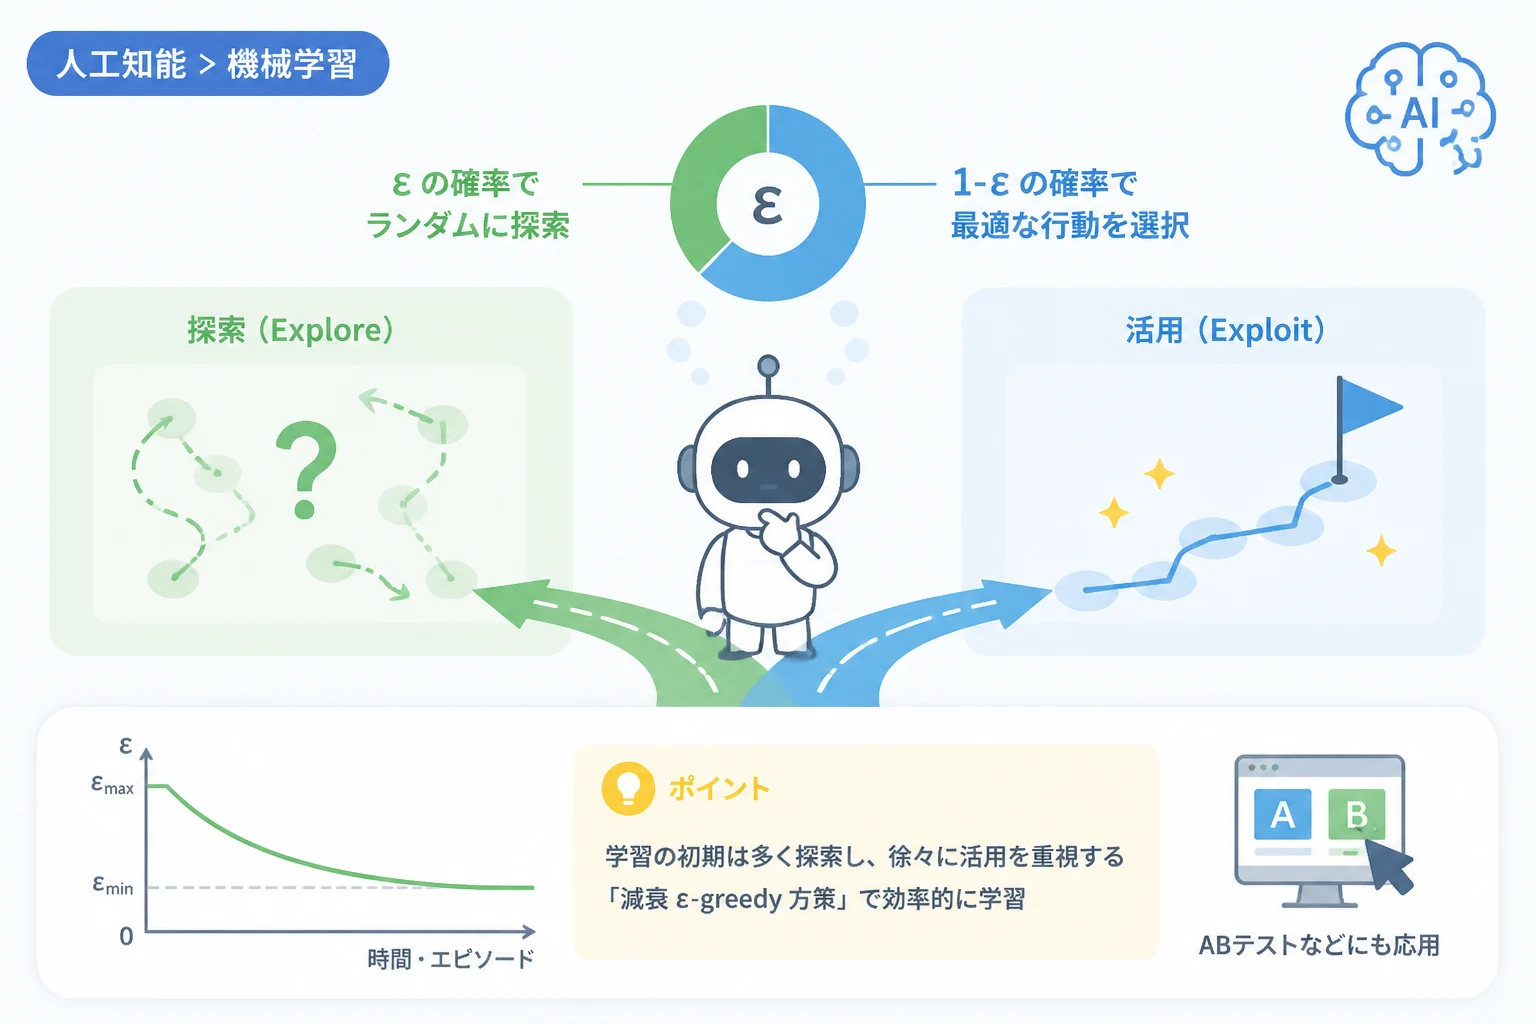
強化学習の分野において、エージェントが最適な行動を学習するための手法として「ε-greedy(イプシロングリーディ)方策」は非常に重要な役割を担っています。
この手法は、未知の環境を調査する「探索」と、これまでの経験から最善と思われる行動を選択する「活用」をバランスよく組み合わせるためのアルゴリズムです。
機械学習エンジニアやデータサイエンティストにとって、ε-greedy方策の理解は、効率的な学習モデルを構築するための第一歩と言えるでしょう。
本記事では、ε-greedy方策の仕組みからメリット・デメリット、さらには応用手法までを詳しく解説します。
強化学習における「探索」と「活用」のトレードオフ
ε-greedy方策を理解するためには、まず強化学習における「探索(Exploration)」と「活用(Exploitation)」の概念を知る必要があります。
強化学習のエージェントは、環境と対話しながら報酬を最大化する行動を学習します。
「活用」とは、現時点で最も高い報酬が得られると分かっている行動を選択し、確実な利益を得ることを指します。
一方で「探索」とは、まだ試したことがない行動や、報酬が不明確な行動をあえて選択し、より良い選択肢がないか調査することを指します。
もしエージェントが「活用」ばかりを優先すると、過去に一度うまくいった行動に固執してしまい、より大きな報酬が得られる可能性を見逃してしまいます。
逆に「探索」ばかりを繰り返すと、得られた知識を活かすことができず、最終的な累計報酬が低くなってしまいます。
この二者のバランスをどのように取るかという問題は「探索と活用のトレードオフ」と呼ばれ、強化学習における中心的な課題の一つです。
ε-greedy方策は、このトレードオフを非常にシンプルなルールで解決しようとするアルゴリズムです。
ε-greedy方策の基本的な仕組み
ε-greedy方策は、ある一定の確率 ε(イプシロン)に基づいて行動を決定する手法です。
具体的には、以下のようなルールに従ってエージェントが行動を選択します。
- 確率 ε で、全ての選択肢の中からランダムに行動を選択する(探索)
- 確率 1 – ε で、その時点で最も期待報酬が高い行動を選択する(活用)
たとえば、ε の値を 0.1(10%)に設定した場合を考えてみましょう。
この場合、エージェントは 90% の確率で「今一番良いと思っている行動」をとり、残りの 10% の確率で「あえて適当な行動」をとります。
この 10% の探索によって、エージェントは新しい情報を収集し、より優れた行動パターンを発見するチャンスを得ることができます。
数式で表すと、行動を選択する確率分布は非常に単純であり、実装も容易であるという特徴があります。
パラメータ ε の役割と重要性
ε-greedy方策において、パラメータ ε の設定値は学習のパフォーマンスに直結します。
ε を大きく設定すると、探索が頻繁に行われるため、新しい発見は増えますが、無駄な行動も多くなり収束が遅くなります。
逆に ε を小さく設定しすぎると、初期段階でたまたま見つけた「そこそこの正解」に満足してしまい、真の最適解にたどり着けないリスクが高まります。
一般的には 0.01 や 0.1 といった値が使われることが多いですが、解くべき問題の複雑さによって調整が必要です。
多腕バンディット問題とε-greedy方策
ε-greedy方策の有効性を説明する際によく用いられるのが「多腕バンディット問題」です。
これは、複数のスロットマシン(腕)があり、それぞれ当たりが出る確率が異なる状況で、どのようにレバーを引けば合計のメダル枚数を最大化できるかというパズルです。
もし一つの台で当たりが出たからといってその台ばかりを引き続けると、隣の台の方がもっと高い確率で当たりが出ることに気づけません。
ここで ε-greedy方策を導入すると、定期的に他の台も試す(探索する)ため、最終的には最も当たりの出やすい台を特定できるようになります。
以下の表は、探索と活用のバランスが学習結果に与える影響をまとめたものです。
| 手法 | 探索の頻度 | 特徴 | リスク |
|---|---|---|---|
| Greedy方策 (ε=0) | なし | 常に現在の最善を選択 | 局所解に陥り、最適解を見逃す |
| ε-greedy方策 (適度) | 一定割合 | 探索と活用のバランスをとる | 学習が進んでも一定の無駄が生じる |
| 純粋なランダム | 100% | 常に新しいことを試す | 学習した知識を全く活用できない |
Pythonによるε-greedy方策の実装例
ε-greedy方策がいかにシンプルであるかを確認するために、Pythonによるコード例を見てみましょう。
以下のプログラムは、各行動の価値(期待報酬)を保持するリストを基に、ε-greedy方策に従って次の行動を決定するロジックです。
import numpy as np

def select_action(q_values, epsilon):
    """
    ε-greedy方策に基づいて行動を選択する
    :param q_values: 各行動の価値(期待報酬)のリスト
    :param epsilon: 探索率
    :return: 選択された行動のインデックス
    """
    if np.random.rand() < epsilon:
        # 探索: ランダムに行動を選択
        action = np.random.choice(len(q_values))
    else:
        # 活用: 期待報酬が最大の行動を選択
        action = np.argmax(q_values)

    return action

# 各行動の推定報酬(例: 3つの選択肢がある場合)
q_estimates = [0.5, 0.8, 0.2]
# 探索率を 0.1 に設定
epsilon = 0.1

# 行動の選択を試行
selected = select_action(q_estimates, epsilon)
print(f"選択された行動のインデックス: {selected}")選択された行動のインデックス: 1このコードでは、乱数が ε 未満であればランダムな行動(探索)を行い、それ以外であれば np.argmax を用いて最大価値を持つ行動(活用)を選択しています。
このように、複雑な数学的処理を必要とせずに実装できる点が、ε-greedy方策の大きな魅力です。
ε-greedy方策のメリット
ε-greedy方策が広く採用されている理由は、その使い勝手の良さにあります。
第一のメリットは、アルゴリズムが極めて単純で、計算負荷が低いことです。
複雑な確率分布を計算したり、過去の全履歴を高度に分析したりする必要がないため、リアルタイム性が求められるシステムでも動作します。
第二のメリットは、どのような問題に対しても一定の成果が期待できる汎用性です。
特定の環境に依存せず、強化学習の導入初期段階でのベースラインとして非常に適しています。
ε-greedy方策の課題と限界
一方で、ε-greedy方策にはいくつかの課題も存在します。
最大の問題は、学習が進んで最適解がほぼ判明した後でも、一定の確率 ε でランダムな探索を続けてしまう点です。
これは、完成した AI モデルが実稼働するフェーズにおいて、不要なミス(最適ではない行動)を引き起こす原因となります。
また、探索の際に「どの行動を試すか」が完全にランダムであることも効率を下げることがあります。
明らかに報酬が低いと分かっている行動も、非常に有望そうな惜しい行動も、探索時には等確率で選ばれてしまいます。
発展手法:減衰ε-greedy方策(Decaying ε-greedy)
前述の「学習が進んでも探索を続けてしまう」という問題を解決するための手法が、「減衰ε-greedy方策」です。
これは、学習の初期段階では ε を大きく設定して積極的に探索を行い、学習が進むにつれて ε の値を徐々に小さくしていく手法です。
最終的には ε を 0 に近づけることで、学習の後半では蓄積した知識を最大限に活用し、安定したパフォーマンスを発揮させることができます。
減衰のさせ方には、ステップ数に応じて一定割合で減らす方法や、指数関数的に減少させる方法などがあります。
この工夫を取り入れることで、ε-greedy方策のシンプルさを維持しつつ、より高度な学習制御が可能になります。
他の探索アルゴリズムとの比較
ε-greedy方策以外にも、探索と活用のバランスをとるための手法はいくつか存在します。
代表的なものに「Softmax方策」があります。
Softmax方策は、各行動の報酬期待値に応じて選択確率を滑らかに変化させる手法で、報酬が高い行動ほど選ばれやすく、低いものほど選ばれにくくします。
また、「UCB(Upper Confidence Bound)方策」は、統計的な不確実性を考慮して、まだ試行回数が少ない行動を優先的に探索する手法です。
ε-greedy方策はこれらの手法に比べて「シンプルさ」で勝りますが、探索の「賢さ」においては Softmax や UCB に軍配が上がることが多いです。
実社会における活用シーン
ε-greedy方策の考え方は、デジタルマーケティングの世界でも広く応用されています。
例えば、Web サイトの A/B テストにおける「バンディット・アルゴリズム」がその一例です。
従来の A/B テストでは、一定期間データを収集した後に勝者を決めますが、これではテスト期間中に機会損失が発生します。
ε-greedy 方策を応用したシステムでは、現時点で反応が良いクリエイティブを優先的に表示しつつ(活用)、時折他のパターンも表示して反応の変化を確認します(探索)。
これにより、テストを行いながら同時にコンバージョン率の最大化を図ることが可能になります。
まとめ
ε-greedy(イプシロングリーディ)方策は、強化学習における探索と活用のトレードオフを解決するための、最も基本的かつ強力な手法の一つです。
「一定の確率で探索し、それ以外は活用する」というシンプルなルールながら、多腕バンディット問題をはじめとする多くの課題に対して効果を発揮します。
実装が容易で計算コストが低いため、初心者からプロフェッショナルまで幅広く利用されています。
一方で、学習が進んでも探索を続けるという弱点もありますが、これは ε の値を時間とともに減少させる「減衰ε-greedy方策」などの工夫で克服可能です。
まずはこの ε-greedy 方策をマスターすることで、強化学習のより複雑なアルゴリズムへの理解も深まっていくでしょう。
データサイエンスや AI 開発に取り組む際は、ぜひこの基本的な方策をベースラインとして活用してみてください。