現代のITシステム、特にクラウドネイティブな環境においては、膨大な数のサーバーが連携して動作する分散システムが主流となっています。
このような複雑な環境下で、複数のコンピューターが同期を取り合い、一貫性を保ちながら動作することは容易ではありません。
そこで重要となるのが、分散環境における「コーディネーション(調整)」を専門に担うミドルウェアです。
本記事では、その代表格であるApache ZooKeeperについて、その役割や仕組み、分散システムにおいて欠かせない理由を詳しく解説します。
Apache ZooKeeperとは何か
Apache ZooKeeperは、分散アプリケーションにおいて高度な信頼性とパフォーマンスを実現するための「集中型コーディネーションサービス」です。
もともとはYahoo!によって開発されたプロジェクトで、現在はApacheソフトウェア財団のトップレベルプロジェクトとして管理されています。
分散システムでは、複数のサーバーが個別に動作するため、特定の設定情報を全台で共有したり、どのサーバーがリーダーであるかを決定したりといった管理が非常に困難になります。
ZooKeeperは、このような「分散環境特有の課題」を解決するために設計されました。
具体的には、設定情報の管理、名前解決、分散同期、グループサービスなどの機能を提供し、開発者が分散ロジックをゼロから構築する手間を省いてくれます。
ZooKeeperの名称の由来
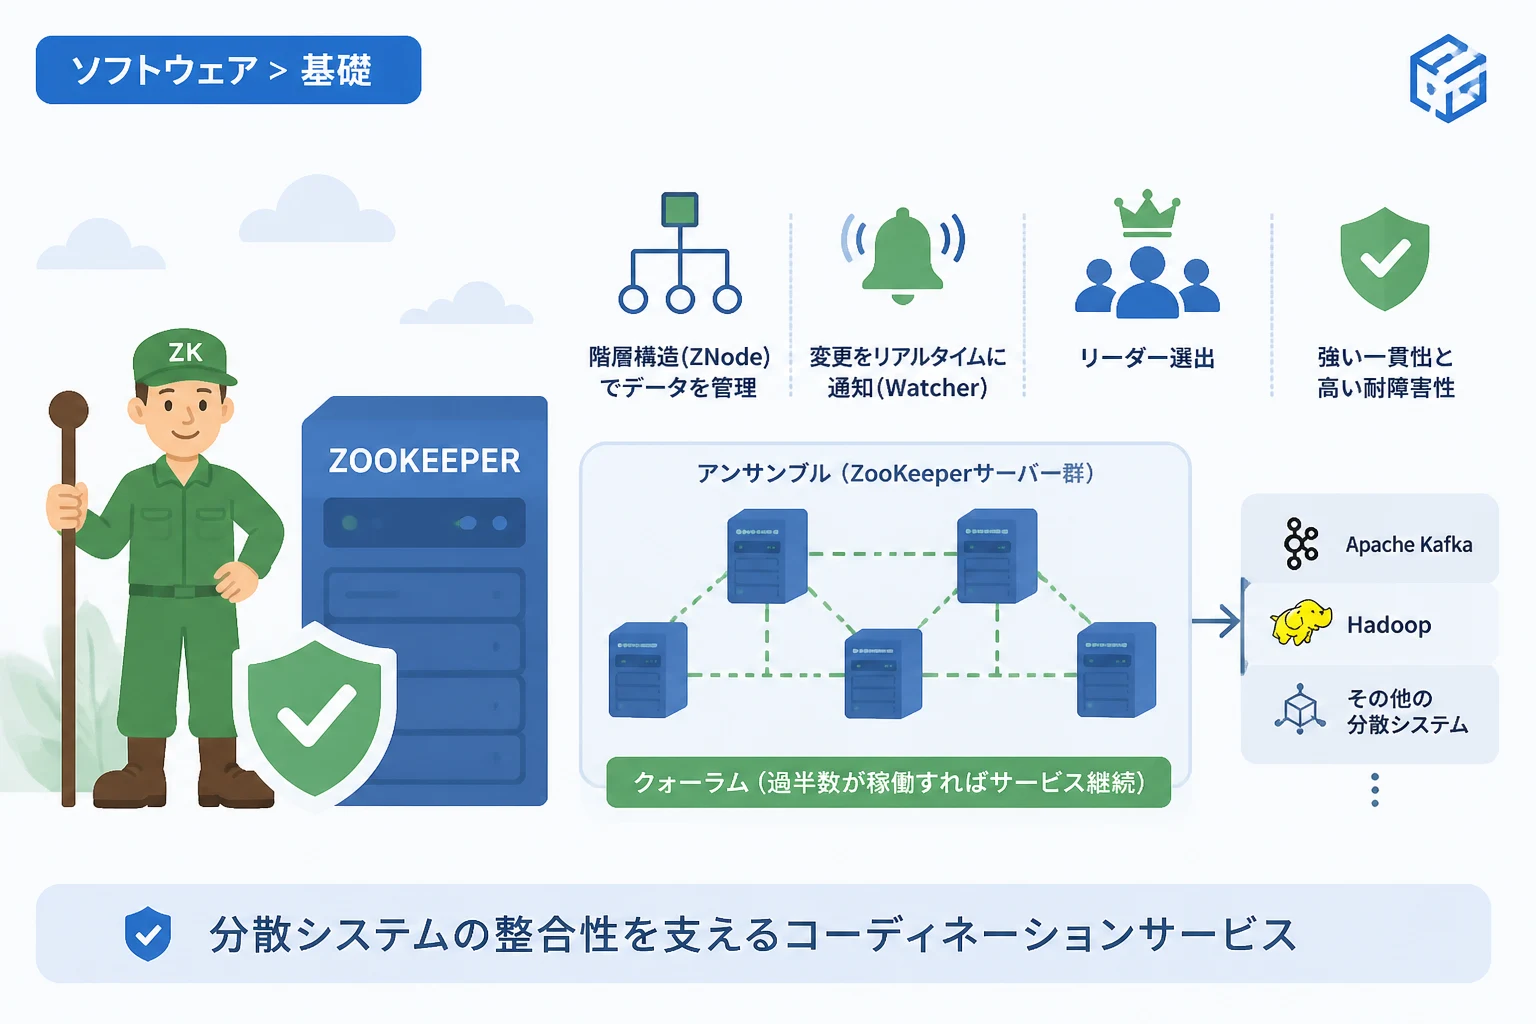
「ZooKeeper(動物園の飼育員)」というユニークな名前には、分散システムの歴史が反映されています。
Apache HadoopやHBaseなど、分散システムのプロジェクトには「象(Hadoop)」や「クジラ(Docker以前の文脈)」など、動物に関連する名前が多く付けられていました。
これら多くの「動物たち(分散プロジェクト)」が暴走しないよう、適切に管理・制御する存在が必要であるという意味を込めて、飼育員を意味する「ZooKeeper」と名付けられたと言われています。
分散システムにおける課題と解決策
分散システムにおいて最も厄介な問題の一つが、「部分的な障害(Partial Failure)」です。
ネットワークの瞬断や特定のサーバーのフリーズが発生した際、システム全体で「現在の状態」を一致させることが非常に難しくなります。
ZooKeeperは、強力な一貫性を保証するデータストアとして機能し、全サーバーが同じ情報を共有できる仕組みを提供します。
これにより、開発者は複雑なネットワーク制御のコードを書くことなく、堅牢な分散アプリケーションを構築できるようになります。
ZooKeeperの基本的な仕組み
ZooKeeperの動作を理解するためには、そのデータ構造と通信モデルを知ることが不可欠です。
ZooKeeperは、ファイルシステムに似た階層的な構造を持ってデータを保持しています。
データモデル:ZNode
ZooKeeper内に保存されるデータの単位は、ZNodeと呼ばれます。
ZNodeは、標準的なファイルシステムのディレクトリやファイルのような階層構造(ツリー構造)を形成します。
各ZNodeは、パス名(例:/app1/config)によって識別され、データとステータス情報を保持できます。
ZooKeeperのZNodeには、大きく分けて以下の3つの種類が存在します。
- 永続ノード (Persistent Node): 明示的に削除されるまで、ZooKeeper上に残り続けるノードです。
- エフェメラルノード (Ephemeral Node): 作成したクライアントのセッションが終了すると、自動的に削除されるノードです。
- シーケンシャルノード (Sequential Node): 作成時に自動的に一意の連番が付与されるノードです。
これらのノードを組み合わせることで、リーダー選挙や分散ロックといった高度な機能を実装することが可能となります。
監視メカニズム:Watcher
ZooKeeperの非常に強力な機能の一つに、Watcher(ウォッチャー)があります。
これは、特定のZNodeに変更があった際に、ZooKeeperサーバーからクライアントへリアルタイムに通知を送る仕組みです。
クライアントは常にデータをポーリング(定期確認)する必要がなく、通知を待つだけで最新の状態を把握できます。
これにより、ネットワーク負荷を抑えつつ、システム全体で瞬時の同期を実現できるのです。
一貫性のプロトコル:Zab
ZooKeeperは、データの整合性を保つために「Zab (ZooKeeper Atomic Broadcast)」という独自のプロトコルを採用しています。
これは、全ての書き込み要求を順序付けて処理し、全サーバーで同一の順序を保証するための仕組みです。
ZooKeeperは通常、複数のサーバーからなる「アンサンブル」というグループで動作しますが、Zabによって一部のサーバーが故障してもデータの整合性が失われません。
ZooKeeperのアーキテクチャ
ZooKeeperは、高い可用性を実現するために「アンサンブル」と呼ばれるクラスター構成で運用されるのが一般的です。
リーダーとフォロワー
アンサンブルを構成する各サーバーには、「リーダー」または「フォロワー」という役割が割り当てられます。
リーダーは、全ての書き込み要求を一元管理し、フォロワーへ変更を伝播させる役割を担います。
フォロワーは、読み取り要求を直接処理し、書き込み要求が発生した場合はそれをリーダーに転送します。
もしリーダーがダウンした場合は、残りのフォロワーの中から自動的に新しいリーダーが選出されます。
クォーラム(多数決)の原理
ZooKeeperが動作を継続するためには、アンサンブル内の「過半数(クォーラム)」のサーバーが稼働している必要があります。
例えば、3台のサーバーで構成されている場合、2台以上が稼働していればシステムは継続可能です。
このため、ZooKeeperのアンサンブルは、耐障害性を効率的に高めるために3台や5台といった「奇数台」で構成されることが推奨されます。
| サーバー総数 | 必要なクォーラム数 | 許容できる故障数 |
|---|---|---|
| 1 | 1 | 0 |
| 3 | 2 | 1 |
| 5 | 3 | 2 |
| 7 | 4 | 3 |
ZooKeeperが提供する主な機能
ZooKeeperは、単純なデータストアとしての役割を超え、分散システムに必要な多くの共通機能を提供します。
1. 設定管理 (Configuration Management)
分散システムでは、数百台のサーバーが同じ設定情報を参照する必要があります。
ZooKeeperに設定ファイルを保存し、各サーバーがそのZNodeを監視(Watch)することで、設定変更をシステム全体へ即座に反映させることが可能です。
2. リーダー選挙 (Leader Election)
複数のサーバーの中から一台だけがマスター(リーダー)として動作し、他がスタンバイ(待機)する構成はよく見られます。
ZooKeeperのエフェメラルノードとシーケンシャルノードを利用することで、リーダーが故障した際に即座に別のサーバーをリーダーに昇格させる仕組みが簡単に構築できます。
3. 分散ロック (Distributed Locks)
複数のプロセスが同時に共有リソースにアクセスするのを防ぐ「ロック」の仕組みを、ネットワーク越しに実現します。
ZooKeeper上で特定のパスにノードを作成できたクライアントがロックを取得したとみなすことで、排他制御を行います。
4. ネーミングサービス (Naming Service)
分散環境下で各サーバーのIPアドレスやポート番号を名前で管理する、いわば分散システムのDNSのような役割を果たします。
ZooKeeperの利用例とエコシステム
Apache ZooKeeperは、多くの著名な分散ソフトウェアの基盤として採用されています。
Apache Kafkaでの利用
分散メッセージングシステムのKafkaは、長らくZooKeeperをその基盤として利用してきました。
KafkaはZooKeeperを使用して、トピックの管理、ブローカーの死活監視、パーティションのリーダー選出などを行っています。
※なお、最新のKafkaではZooKeeper依存を排除する「KRaft」モードへの移行が進んでいますが、依然として多くの現場でZooKeeper構成が利用されています。
Apache Hadoop / HBaseでの利用
大規模データ処理プラットフォームであるHadoopや、分散データベースのHBaseでもZooKeeperは不可欠です。
HDFSのNameNodeの冗長化(HA構成)におけるフェイルオーバー管理などにZooKeeperが活用されています。
ZooKeeperを使用するメリットとデメリット
ZooKeeperを導入することで得られる恩恵は大きいですが、同時に注意すべき点も存在します。
メリット
- 高い信頼性: クォーラム構成により、単一障害点(SPOF)を排除できます。
- 厳密な一貫性: 分散システムで最も困難な「状態の不一致」を確実に回避できます。
- 高速な読み取り: メモリ上でデータを管理するため、参照処理が非常に高速です。
- 実績の豊富さ: 長年にわたり大規模な商用環境で利用されており、ノウハウが蓄積されています。
デメリットと注意点
- 運用の複雑さ: アンサンブルのメンテナンスや、JVMのチューニングには一定のスキルが必要です。
- 書き込みのボトルネック: 全ての書き込みがリーダーを経由し、クォーラムの合意を待つため、書き込み頻度が非常に高い用途には向きません。
- データ量の制限: 全データをメモリに保持する設計上、数GBを超えるような大規模データの保存には適していません。
ZooKeeperの基本的な操作例
実際にZooKeeperがどのように動作するか、標準のCLI(コマンドラインインターフェース)を用いた例を紹介します。
以下は、ノードを作成し、データを取得する基本的な流れです。
# /myconfig というパスに "server-01" というデータを保持する永続ノードを作成
create /myconfig "server-01"

# 作成したノードのデータを確認
get /myconfig

# ノードのデータを更新
set /myconfig "server-02"

# ノードを削除
delete /myconfigCreated /myconfig
server-01
cZxid = 0x2
ctime = Wed May 11 10:00:00 JST 2026
...
server-02このように、直感的なパス指定によって分散情報を管理できるのがZooKeeperの特徴です。
ZooKeeperと類似技術の比較
ZooKeeper以外にも、分散コーディネーションを提供するツールはいくつか存在します。
例えば、etcdは、Kubernetesのバックエンドとして採用されている非常に強力な競合です。
etcdはGo言語で記述されており、HTTP/gRPCベースのAPIを提供するため、コンテナ環境との親和性が高いという特徴があります。
また、HashiCorp社のConsulは、サービスディスカバリ(サービスの自動検出)に特化した機能を持ち、運用の容易さが評価されています。
ZooKeeperはこれらの技術と比較して、より厳格な順序保証や複雑な階層構造の管理に強みを持っており、ビッグデータ系のエコシステムと深く統合されている点が最大の利点です。
まとめ
Apache ZooKeeperは、複雑化する分散システムにおいて、影の立役者として非常に重要な役割を担っています。
ZNodeによる階層的なデータ管理、Watcherによるリアルタイム通知、そしてZabプロトコルによる強固な一貫性保証は、信頼性の高いシステム構築に欠かせません。
KafkaやHadoopといった大規模プラットフォームの基盤として、長年培われてきた安定性は、他の新しい技術にはない大きな魅力です。
分散システムの開発や運用に携わるエンジニアにとって、ZooKeeperの仕組みを理解することは、システム全体の安定性を確保するための第一歩となるでしょう。
近年のクラウドネイティブな潮流においても、ZooKeeperの設計思想は多くの技術に影響を与え続けています。
まずは小規模なアンサンブルから触れてみて、その強力なコーディネーション機能を体感してみることをおすすめします。