現代の音楽ストリーミングサービスや動画配信プラットフォームにおいて、シャッフル再生(ランダム再生)は欠かせない機能の一つとなっています。
多くのユーザーが無意識に利用しているこの機能ですが、実はその裏側では高度な数学的アルゴリズムや心理学に基づいた工夫が凝らされています。
本記事では、シャッフル再生の基本的な定義から、コンピュータがどのように「ランダム」を作り出しているのかという仕組み、そして主要なアルゴリズムの種類について詳しく解説します。
IT用語としての深い理解を得ることで、普段何気なく使っているアプリケーションの設計思想が見えてくるはずです。
シャッフル再生(ランダム再生)の基本定義
シャッフル再生とは、プレイリストやアルバムに含まれる楽曲やコンテンツを、あらかじめ決められた順序ではなく、不規則な順番で再生する機能のことです。
一般的には「ランダム再生」とも呼ばれますが、技術的な文脈では「シャッフル」と呼称されることが多く、トランプのカードを混ぜる動作に由来しています。
この機能の主な目的は、ユーザーに対して「次に何が流れるかわからない」というワクワク感や意外性を提供することにあります。
また、同じプレイリストを何度も聴く際に、特定の再生順序によるマンネリ化を防ぐ効果も期待されています。
現在では、単にランダムに選ぶだけでなく、ユーザーの好みを反映させた「スマートシャッフル」などの高度な機能も登場しています。
コンピュータにおける「ランダム」の正体
コンピュータの世界において、完全な意味での「ランダム(真の乱数)」を作り出すことは非常に困難であるとされています。
なぜなら、コンピュータは決定論的な命令に従って動作する機械であり、何らかの数式や規則に基づかずに値を生成することが苦手だからです。
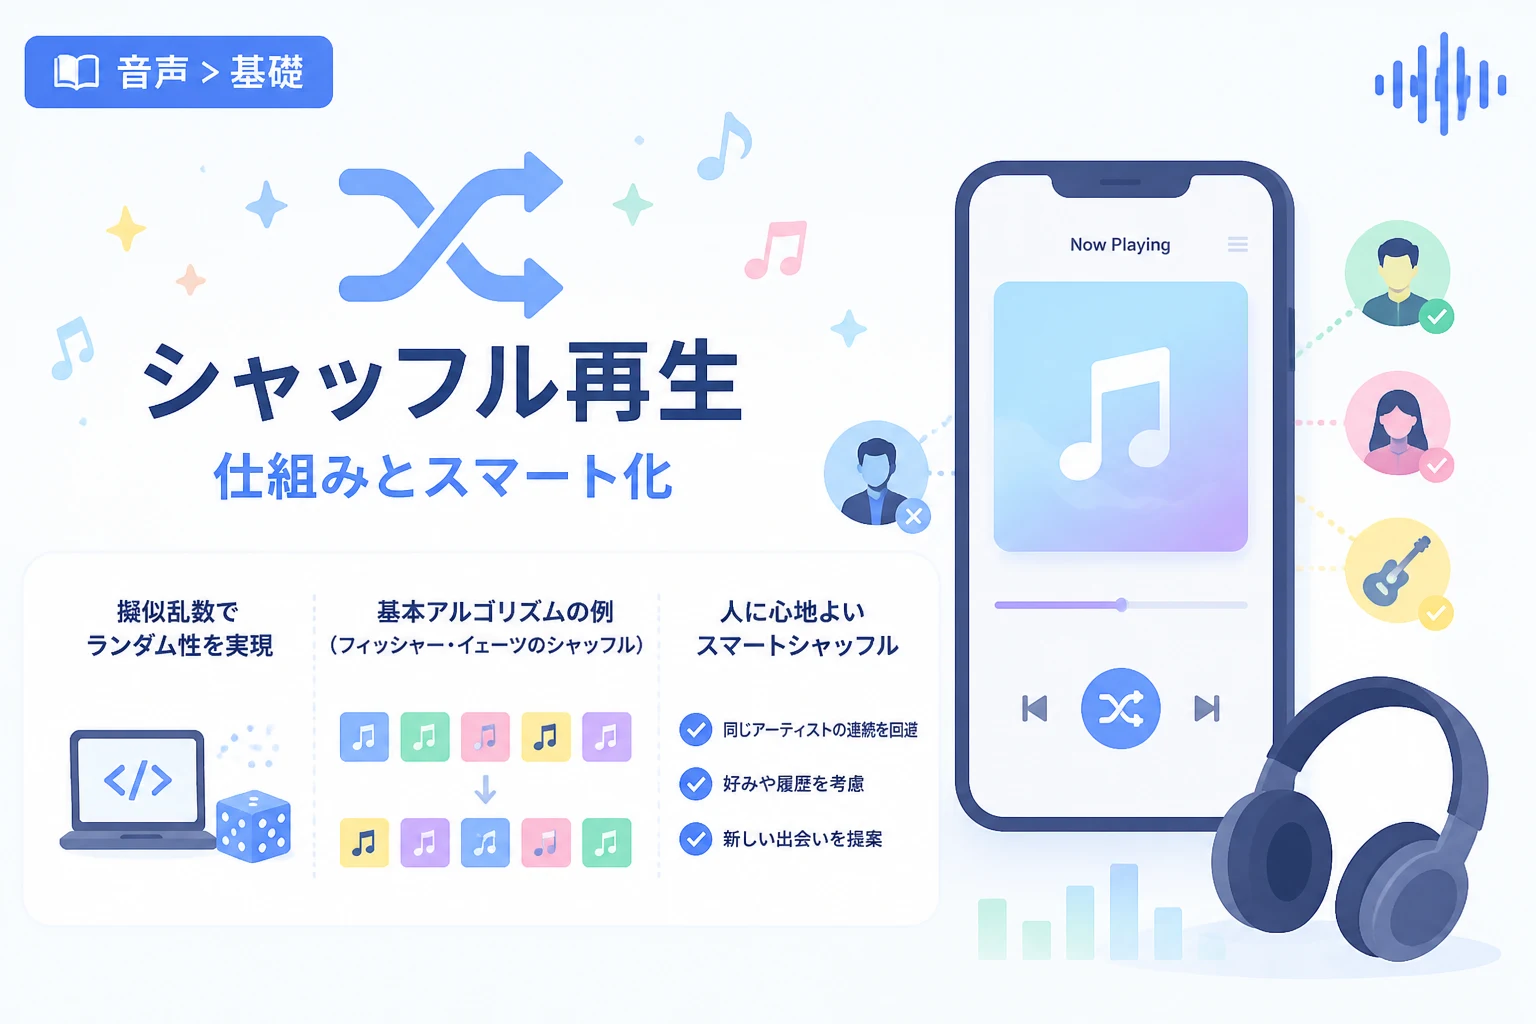
そのため、多くのソフトウェアでは擬似乱数(ぎじらんすう)と呼ばれる仕組みが利用されています。
擬似乱数は、一見すると不規則に見えますが、実際には特定の計算式によって算出された数列です。
真の乱数と擬似乱数の違い
真の乱数は、熱雑音や放射線の崩壊といった物理現象など、予測不可能な外部の情報をソースとして生成されます。
一方で、シャッフル再生で一般的に使われる擬似乱数は、計算の起点となる「シード値」を元にして生成されます。
シード値が同じであれば、生成されるランダムな順序も全く同じになってしまうという特性を持っています。
実用上のシャッフル再生においては、現在時刻のミリ秒単位の数値などをシード値に使うことで、実質的に予測不可能な順序を実現しています。
主要なシャッフルアルゴリズムの種類
プレイリストの楽曲を並び替える際、エンジニアは目的に応じてさまざまなアルゴリズムを選択します。
ここでは、代表的なアルゴリズムである「フィッシャー・イェーツのシャッフル」と、近年注目されている「バイアス付きシャッフル」について解説します。
フィッシャー・イェーツ(Fisher-Yates)シャッフル
フィッシャー・イェーツのシャッフルは、有限の集合を公平に並び替えるための最も標準的なアルゴリズムです。
この手法の最大の特徴は、すべての要素が選ばれる確率が均等であり、かつ計算効率が非常に高い点にあります。
具体的な手順は、リストの末尾から順番に、それ以前の要素(自分を含む)の中からランダムに一つを選び、現在の要素と入れ替えるという作業を繰り返します。
このアルゴリズムを使用することで、データ量が多くても一瞬で偏りのないシャッフル結果を得ることができます。
スマートシャッフル(重み付け・バランス型)
純粋な数学的ランダムは、時として人間の感覚とは乖離することがあります。
例えば、同じアーティストの曲が3曲連続で続いてしまった場合、人間は「これはランダムではない」と不快感や疑念を抱く傾向があります。
これを解決するために開発されたのが、スマートシャッフルと呼ばれるアルゴリズムです。
これは、特定のアーティストやジャンルが連続しないように制御を加えたり、ユーザーの再生履歴を元に「聴きたい可能性が高い曲」を前方に配置したりする仕組みです。
Spotifyなどの大手サービスでは、純粋なランダムよりも、あえて意図的な操作を加えたシャッフルのほうがユーザー満足度が高いという研究結果に基づき、独自の調整を行っています。
シャッフル再生の実装例(Python)
プログラミングにおいて、リストをシャッフルする処理がいかにシンプルに記述できるかを確認してみましょう。
以下のコードは、Python標準のrandomモジュールを使用して、楽曲リストをシャッフルする例です。
import random

# 再生リストの定義
playlist = ["Song A", "Song B", "Song C", "Song D", "Song E"]

# フィッシャー・イェーツのアルゴリズムに基づいたシャッフル
random.shuffle(playlist)

# 結果の表示
print(f"シャッフル後の再生順序: {playlist}")シャッフル後の再生順序: ['Song C', 'Song E', 'Song A', 'Song D', 'Song B']このように、モダンなプログラミング言語では、複雑な数式を書かなくても標準ライブラリとしてシャッフル機能が提供されています。
開発者はこれらの関数を呼び出すだけで、簡単にランダムな再生順序を生成することが可能です。
なぜ「完全なランダム」は不自然に感じるのか
シャッフル再生を議論する上で興味深いのは、人間の心理と統計学的なランダムのギャップです。
「ギャンブラーの誤謬」という言葉がある通り、人間は「以前の結果が次の結果に影響を与える」と錯覚してしまう性質を持っています。
例えば、コイン投げで5回連続で表が出た後、多くの人は「次は裏が出る確率が高い」と直感的に考えがちですが、実際には確率は常に50%のままです。
シャッフル再生においても、100曲ある中で特定の曲が再生された直後、再びその曲が(あるいは同じアーティストの曲が)選ばれる可能性はゼロではありません。
しかし、ユーザーはこの「偶然の重複」をシステムの不具合や偏りと認識してしまいます。
そのため、現代の高度なシャッフル機能は、「人間がランダムだと感じるように、あえてランダム性を崩す」という逆説的なアプローチを取っているのです。
シャッフル再生における主な制御パターン
ユーザー体験を向上させるために、具体的にどのような制御が行われているのかを以下の表にまとめました。
| 制御の種類 | 目的 | 内容 |
|---|---|---|
| 重複排除 | マンネリ防止 | 全曲を一通り再生し終わるまで、同じ曲を流さないように制御する。 |
| アーティスト分散 | 多様性の確保 | 同じアーティストの楽曲が連続しないように、一定の間隔を空ける。 |
| 人気度考慮 | 満足度向上 | ユーザーの評価が高い曲や、スキップ回数が少ない曲の出現率を上げる。 |
| シームレス移行 | 聴き心地の維持 | 曲調(テンポやキー)が似ているものを近くに配置し、流れをスムーズにする。 |
これらの制御が組み合わさることで、私たちはストレスなく音楽を楽しむことができています。
技術の進化により、単なる「かき混ぜ」から、個人の嗜好に最適化された「キュレーション」へとシャッフル再生は進化し続けています。
まとめ
シャッフル再生(ランダム再生)は、一見単純な機能に見えますが、その背景には高度なアルゴリズムと人間心理への深い洞察が存在します。
コンピュータが生成する擬似乱数を利用しながらも、ユーザーが「心地よいランダムさ」を感じられるように各社が工夫を凝らしています。
フィッシャー・イェーツ法のような古典的で強力なアルゴリズムに加え、現代ではAIや機械学習を活用したパーソナライズが進んでいます。
次にスマートフォンの再生ボタンを押すときは、その一曲が選ばれるまでの背景にある複雑な仕組みに思いを馳せてみてはいかがでしょうか。
こうしたIT用語の背景を知ることは、私たちが利用するデジタルツールの本質を理解するための第一歩となります。