ITシステムやサーバーの運用において、最も基本的かつ重要な指標の一つが「アップタイム」です。
アップタイムは、システムが正常に稼働し、ユーザーがサービスを利用可能な状態にある時間を指します。
DX(デジタルトランスフォーメーション)が進む現代社会では、システムの停止はビジネスに甚大な影響を及ぼします。
本記事では、アップタイムの基礎知識から具体的な計算方法、そして稼働率を高めるための具体的なポイントまで詳しく解説します。
アップタイムとは?基本概念の理解
アップタイムとは、コンピューターシステムやサーバー、ネットワーク機器などのITインフラが連続して稼働し続けている時間のことです。
一般的には、システムの電源が投入されてから現在までの経過時間や、前回の再起動からの経過時間を指します。
システムの安定性を評価する際、この数値が大きければ大きいほど、長期間にわたって停止することなく動作していることを証明します。
反対に、システムが何らかの理由で停止して利用できない状態にある時間は「ダウンタイム」と呼ばれます。
システムの信頼性を評価する基準としては、このアップタイムとダウンタイムの比率が非常に重要視されます。
アップタイムと稼働率の違い
アップタイムそのものは「150日」や「2,000時間」といった「時間」の絶対的な量で表されます。
一方で、IT業界で頻繁に耳にする「稼働率」は、全運用時間に対してアップタイムが占める割合をパーセンテージで示したものです。
例えば、1年間の運用期間の中でどれだけシステムが動いていたかを評価する際には、稼働率という指標がよく用いられます。
サービス提供者がユーザーに対して保証する「SLA(サービス品質保証)」でも、稼働率が基準となります。
可用性(アベイラビリティ)との関係
アップタイムと密接に関係する言葉に「可用性(アベイラビリティ)」があります。
可用性とは、システムが「必要な時にいつでも使える状態にあること」を示す性質を指します。
可用性が高いシステムは、アップタイムが極めて長く、ダウンタイムが最小限に抑えられているシステムと言い換えることができます。
稼働率の計算方法と「ファイブナイン」の基準
システムの信頼性を定量化するために、具体的な計算式を理解しておくことは欠かせません。
基本的な稼働率の計算式は以下の通りです。
稼働率(%) = アップタイム ÷ (アップタイム + ダウンタイム) × 100
この式によって、システムがどれほど安定して動作しているかを客観的に把握することが可能になります。
ファイブナイン(99.999%)という究極の目標
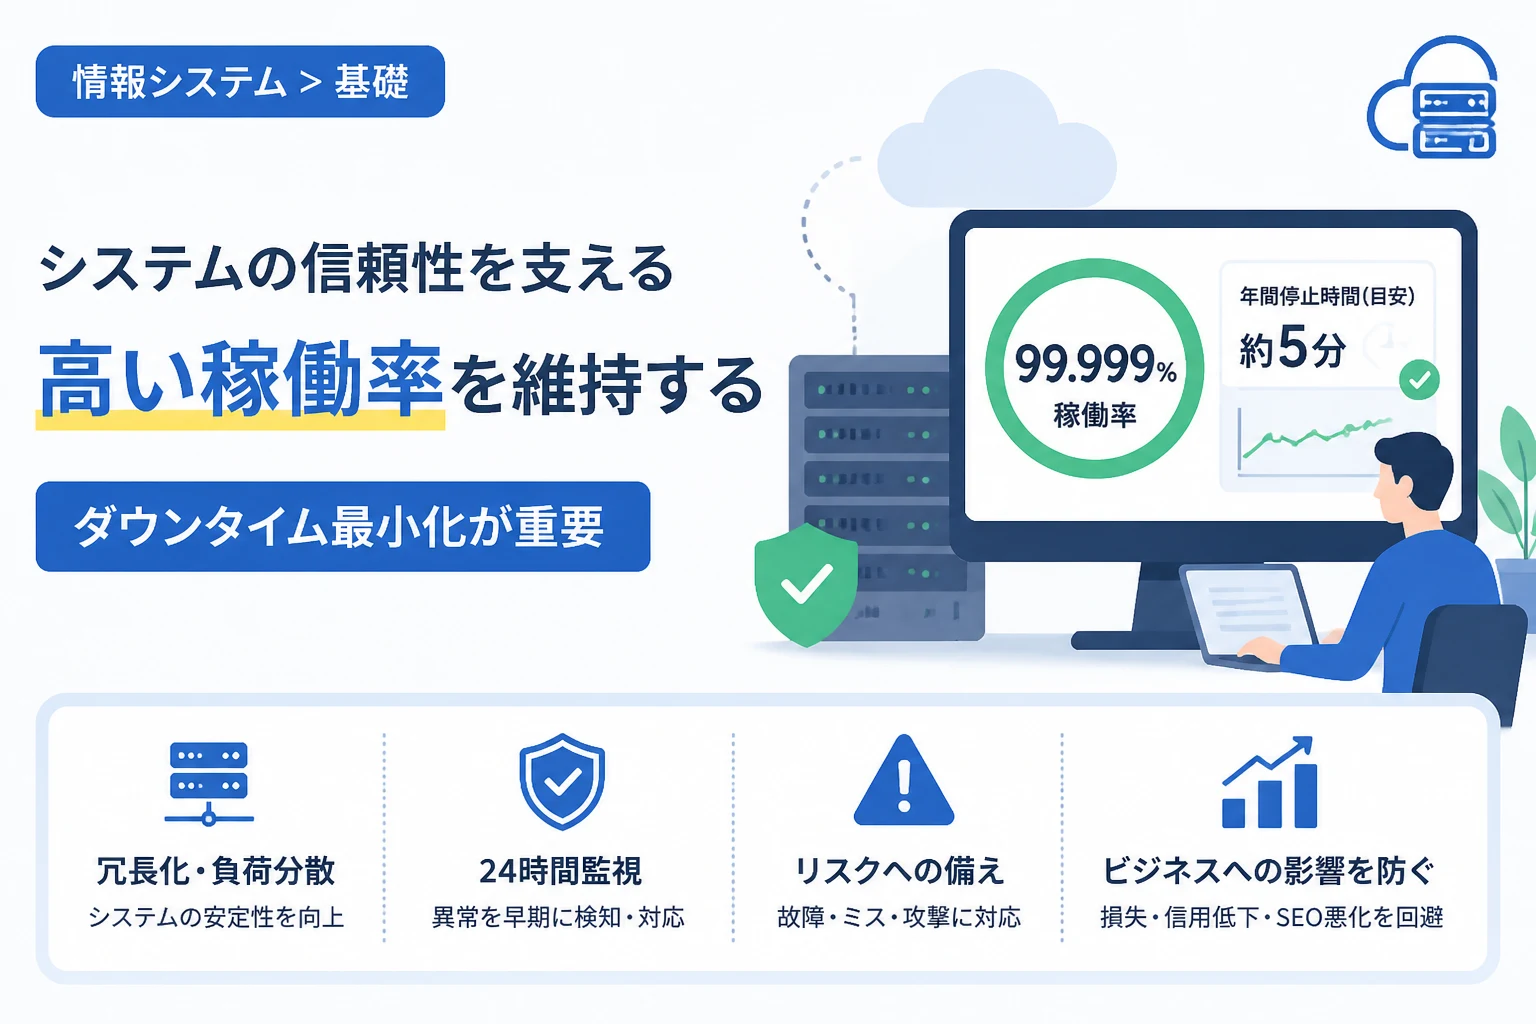
IT業界において一つの究極的な目標とされるのが、「ファイブナイン」と呼ばれる稼働率99.999%です。
これは、1年間のうちに許される停止時間がわずか5分強(約5分15秒)以内であることを意味します。
金融機関の基幹システムや医療システム、社会インフラなど、高度な可用性が求められる環境で基準とされる数値です。
以下の表は、稼働率のパーセンテージが示す、年間の許容ダウンタイムをまとめたものです。
| 稼働率(%) | 年間の最大ダウンタイム | 1ヶ月の最大ダウンタイム |
|---|---|---|
| 99.0% | 約3.65日 | 約7.2時間 |
| 99.9%(スリーナイン) | 約8.76時間 | 約43.2分 |
| 99.99%(フォーナイン) | 約52.56分 | 約4.32分 |
| 99.999%(ファイブナイン) | 約5.26分 | 約25.9秒 |
このように、わずか「0.1%」や「0.01%」の差が、実際の運用現場では大きな意味を持つことがわかります。
アップタイムが重要視される理由
なぜ、これほどまでにアップタイムが重要視されるのでしょうか。
それは、現代のビジネスモデルがITサービスに完全に依存しているからです。
経済的損失の回避
ECサイトやSaaS、オンラインゲームなどのサービスにおいて、システム停止は直接的な収益の機会損失につながります。
多額の広告費をかけて集客していても、サイトが表示されなければ売上は完全にゼロになります。
特に大規模なプラットフォームでは、わずか数分の停止で数億円単位の損害が出ることも珍しくありません。
顧客満足度と社会的信頼の維持
ユーザーは「システムは常に動いていて当たり前」という前提でサービスを利用しています。
頻繁にアクセス不能になったり、エラーが発生したりするサービスは、ユーザーの不満を募らせます。
信頼性の低いサービスは、SNSなどでの悪評を招き、最終的には他社サービスへの乗り換えを加速させます。
一度失った社会的信頼を取り戻すには、システムの改修以上のコストと時間を要します。
検索エンジン最適化(SEO)への影響
Webサイトのアップタイムが不安定な場合、Googleなどの検索エンジンの評価に悪影響を与える可能性があります。
検索エンジンのクローラーがサイトにアクセスした際にサーバーがダウンしていると、インデックスの削除や順位下落を招く恐れがあります。
ビジネスの集客をWebに依存している場合、システムの不安定さは致命的なダメージとなります。
アップタイムを向上させるための技術的な対策
物理的な故障や定期的なメンテナンスを考慮すると、100%のアップタイムを達成することは極めて困難です。
しかし、様々な技術的アプローチを組み合わせることで、100%に限りなく近づける努力が続けられています。
冗長化(レダンダンシー)の確保
単一障害点(SPOF)を排除するために、サーバーやネットワーク機器、ストレージを多重化することが基本です。
万が一、一つの機器が故障しても、予備のシステムが自動的に処理を引き継ぐ「フェイルオーバー」の仕組みを構築します。
物理的なデータセンター自体を複数の場所に分ける「マルチリージョン構成」を採用する場合もあります。
負荷分散(ロードバランシング)の導入
特定のサーバーにトラフィックが集中すると、過負荷によってシステムがハングアップする恐れがあります。
ロードバランサーを配置してアクセスを複数のサーバーに適切に振り分けることで、システム全体の安定性を高めます。
これにより、一台のサーバーにメンテナンスが必要な際も、他のサーバーでサービスを継続させることが可能です。
定期的なメンテナンスとパッチ適用
セキュリティホールやバグを放置することは、将来的なダウンタイムを引き起こす大きなリスクとなります。
OSやミドルウェアのアップデートを計画的に実施し、システムを常に健全な状態に保つことが重要です。
最近では、システムを止めることなく更新プログラムを適用する「ローリングアップデート」という手法も普及しています。
アップタイムを監視するためのツールと手法
異常を早期に検知し、ダウンタイムを最小限に抑えるためには、24時間365日の監視体制が不可欠です。
外部監視と内部監視
外部監視は、インターネット越しにサービスが実際に利用可能かどうかをチェックする手法です。
HTTP/HTTPSレスポンスの内容を確認し、ユーザーがページを閲覧できる状態にあるかを評価します。
一方、内部監視は、CPU使用率、メモリの空き容量、ディスクの読み書き速度など、サーバー内部のリソースを詳細に監視します。
これらを組み合わせることで、障害の予兆を事前に察知し、実際の影響が出る前に対処することが可能となります。
システム稼働時間の確認コマンド
エンジニアがサーバーのアップタイムを直接確認する場合、OSの標準コマンドを利用することが一般的です。
Linux環境では、以下のようなコマンドで簡単に現在の稼働時間を知ることができます。
# システムの起動時間と稼働時間を表示する
uptime
このコマンドを実行すると、以下のような結果が得られます。
14:20:05 up 150 days, 4:32, 1 user, load average: 0.08, 0.03, 0.01この出力結果から、システムが150日間にわたって一度も再起動されずに動き続けていることがわかります。
アップタイム低下を招く主な要因
安定稼働を阻害する要因は多岐にわたりますが、代表的なものを理解しておくことで対策を立てやすくなります。
ハードウェアの故障
サーバーを構成するハードディスク(HDD/SSD)の寿命や、電源ユニットの故障は避けて通れない問題です。
部品の故障を前提とした設計(デザイン・フォー・フェイラー)を行うことが、アップタイム向上の鍵となります。
ヒューマンエラー
意外にも多いのが、設定ミスや誤操作によるシステムの停止です。
作業手順の自動化や、ダブルチェック体制の構築によって、人の手によるミスを最小限に抑える必要があります。
サイバー攻撃
DDoS攻撃(大量のパケットを送りつけてサーバーを過負荷にする攻撃)は、アップタイムを直接的に削りに来ます。
適切なファイアウォールやWAF(Web Application Firewall)を導入し、外部からの攻撃に耐えられる体制を整えなければなりません。
まとめ
アップタイムは、ITサービスの品質と信頼性を象徴する極めて重要な指標です。
高い稼働率を維持することは、単なる技術的な目標ではなく、ビジネスの継続性とユーザーの信頼を守るための必須条件と言えます。
まずは自社システムの現在のアップタイムを正確に把握し、現実的な目標数値を設定することから始めましょう。
「ファイブナイン」のような極めて高い基準を目指す場合は、コストと効果のバランスを見極めながら、冗長化や監視ツールの導入を進めていくことが重要です。
完璧に停止しないシステムを作ることは不可能に近いですが、適切な設計と運用管理によって、ダウンタイムの影響を限りなくゼロに近づけることは可能です。
日々の継続的な監視と、予期せぬトラブルに備えた準備こそが、優れたアップタイムを実現する唯一の道となります。