現代のデジタル社会において、コンピュータやスマートフォンの動作速度は利便性を左右する極めて重要な要素です。
私たちがデバイスを操作する際、データの読み込み待ちを感じさせないスムーズな動作の裏側には、「キャッシュ(Cache)」と呼ばれる技術が深く関わっています。
キャッシュは、一度利用したデータを一時的な保存場所に蓄えておくことで、次回以降のアクセスを高速化させる仕組みを指します。
ITインフラやストレージ、ウェブブラウザなど、あらゆるレイヤーで活用されているキャッシュは、パフォーマンス最適化の要と言っても過言ではありません。
本記事では、キャッシュの基本的な概念から具体的な仕組み、ストレージにおける役割まで、詳しく紐解いていきます。
キャッシュの基本概念と役割
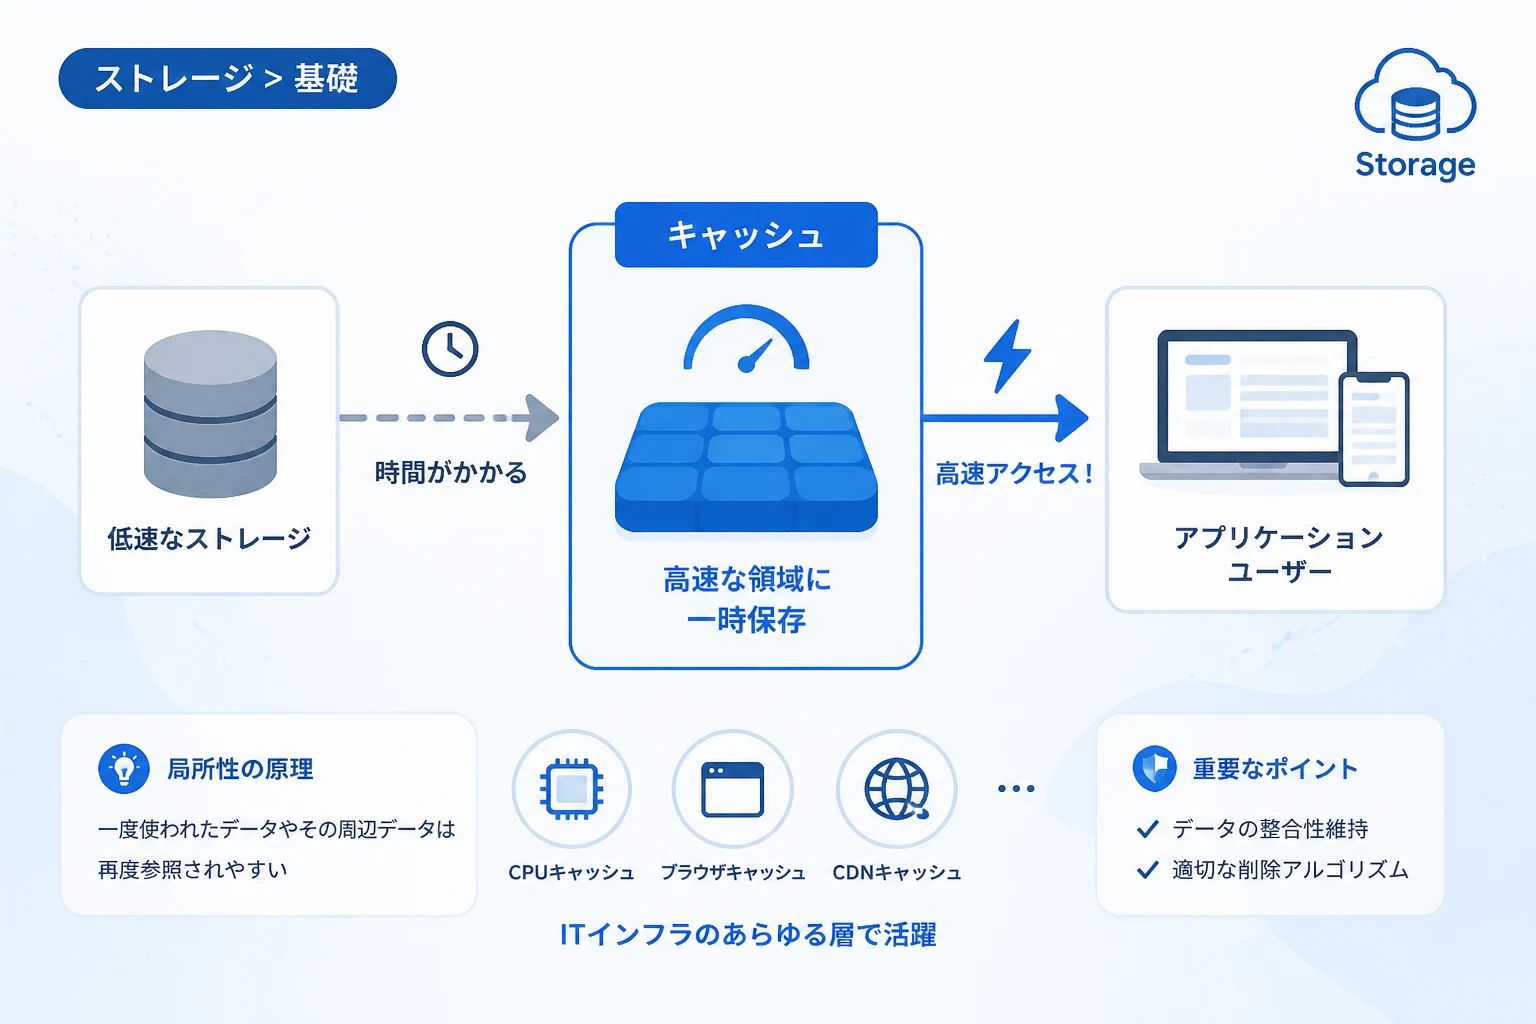
キャッシュとは、データへのアクセス速度を向上させるために、低速なデバイスにあるデータを高速なデバイスへ一時的にコピーして保持する仕組みのことです。
コンピュータの処理においては、データを保存しているストレージ(HDDやSSD)から、処理を行うCPUへとデータを転送する必要があります。
しかし、CPUの処理能力に対してストレージの読み書き速度は圧倒的に遅いため、この速度差がボトルネックとなってシステム全体の動作が停滞してしまいます。
そこで、CPUに近い場所に高速なメモリ領域を設け、頻繁に使うデータを置いておくことで、遅いストレージに何度もアクセスする必要をなくしたのがキャッシュの始まりです。
キャッシュは、いわば「机の上の作業スペース」に例えられます。
資料が必要になるたびに遠くの書庫(ストレージ)まで取りに行くのではなく、よく使う資料を手元の机(キャッシュ)に置いておけば、即座に作業を再開できるという理屈です。
このように、キャッシュを活用することでシステム全体のレスポンスタイムを劇的に改善することが可能になります。
キャッシュを支える「局所性」の原理
キャッシュが効率的に機能する背景には、コンピュータプログラムの動作特性である「参照の局所性」という原理が存在します。
局所性には、大きく分けて「時間的局所性」と「空間的局所性」の二種類があります。
時間的局所性
時間的局所性とは、一度アクセスされたデータは、近い将来に再びアクセスされる可能性が高いという性質です。
例えば、プログラム内のループ処理で使われる変数や、頻繁に更新される設定ファイルなどがこれに該当します。
この性質を利用して、一度読み込んだデータを一定期間保持しておくことで、二度目以降のアクセスを高速化します。
空間的局所性
空間的局所性とは、あるデータにアクセスされたとき、その近くにあるデータも近いうちにアクセスされる可能性が高いという性質です。
配列データの処理や、文書ファイルを先頭から順番に読み進めるようなケースが典型的な例です。
キャッシュは単一のデータだけでなく、その周辺のデータもまとめて読み込むことで、次回のアクセスに備えます。
IT環境におけるキャッシュの種類
キャッシュ技術は、ハードウェアからソフトウェアに至るまで、コンピュータシステムのあらゆる階層に組み込まれています。
ここでは、代表的なキャッシュの種類とその役割について解説します。
CPUキャッシュ
CPUの内部または近傍に搭載されている、最も高速なキャッシュメモリです。
CPUは非常に高速に演算を行いますが、主記憶装置(RAM)とのやり取りには時間がかかります。
この速度差を埋めるため、CPUキャッシュはL1、L2、L3という階層構造を持ってデータを保持します。
| 階層 | 名称 | 特徴 |
|---|---|---|
| L1キャッシュ | レベル1 | 最も容量が小さいが、CPUコアと同期して動作する最高速のメモリ。 |
| L2キャッシュ | レベル2 | L1よりは遅いが、容量が大きく、各コアまたは複数コアで共有される。 |
| L3キャッシュ | レベル3 | さらに大容量で、CPU全体の複数のコアで共有されることが多い。 |
ストレージキャッシュ(ディスクキャッシュ)
HDDやSSD、ストレージコントローラに搭載されているキャッシュです。
OSがストレージにデータを書き込む際、物理的な記録メディアへの書き込み完了を待たずにキャッシュにデータを保存することで、書き込み処理を高速化します。
また、読み込み時にもキャッシュ上のデータを提供することで、物理ドライブの回転や電子の移動待ちを削減します。
ブラウザキャッシュ
Google ChromeやSafariなどのウェブブラウザが、ウェブサイトの画像やスクリプト(JS)、スタイルシート(CSS)をパソコン内に保存する仕組みです。
同じサイトを再度訪問した際、インターネット経由でデータをダウンロードし直す必要がなくなり、ページの表示速度が大幅に向上します。
CDN(Content Delivery Network)キャッシュ
世界各地に配置されたキャッシュサーバーにウェブサイトのコンテンツをコピーしておく技術です。
ユーザーから物理的に近い距離にあるサーバーがデータを提供することで、ネットワークの遅延を最小限に抑えます。
これは、大規模な動画配信サービスや高トラフィックなニュースサイトで不可欠な技術となっています。
データベースキャッシュ
データベースへのクエリ(問い合わせ)結果を一時的に保存する仕組みです。
複雑な計算や大量のデータ検索が必要なクエリに対し、結果をキャッシュしておくことで、サーバーの負荷を下げ、レスポンスを速めます。
RedisやMemcachedといったインメモリデータベースが、この用途でよく利用されます。
ストレージにおけるキャッシュの書き込み方式
ストレージキャッシュにおいて、データの書き込みをどのように管理するかは、パフォーマンスとデータの安全性に関わる重要なポイントです。
主に「ライトスルー」と「ライトバック」の2つの方式があります。
ライトスルー方式(Write-through)
キャッシュとストレージ本体の両方に、同時にデータを書き込む方式です。
常に最新のデータがストレージに保存されているため、電源障害などでキャッシュの内容が消えてもデータが失われる心配がありません。
ただし、物理ストレージへの書き込み完了を待つ必要があるため、書き込み速度の向上は期待できません。
ライトバック方式(Write-back)
データを一旦キャッシュにだけ書き込み、OSには書き込み完了を通知する方式です。
ストレージ本体への書き込みは、システムの負荷が低い時や、キャッシュが一杯になった時に後回しで行われます。
書き込み処理が非常に高速になりますが、書き込み完了前に停電などでキャッシュデータが消えると、データが消失したり不整合が起きたりするリスクがあります。
このリスクを回避するため、エンタープライズ向けのストレージではバッテリー(BBU)やコンデンサでキャッシュを保護するのが一般的です。
キャッシュの管理とアルゴリズム
キャッシュの容量は有限であるため、どのデータを残し、どのデータを削除するかを決定する管理アルゴリズムが重要です。
効率の悪いアルゴリズムを使うと、必要なデータがキャッシュに残らず、キャッシュのメリットを享受できません。
LRU (Least Recently Used)
「最も長い間使われていないデータ」を優先的に削除し、新しいデータを格納する方式です。
キャッシュ管理において最も一般的で、効率的なアルゴリズムとされています。
LFU (Least Frequently Used)
「アクセスされた頻度が最も低いデータ」を削除する方式です。
頻繁に参照されるデータは残り続け、一時的に一度だけ使われたようなデータが追い出される仕組みです。
FIFO (First-In, First-Out)
「最も古い時期にキャッシュされたデータ」から順番に削除する方式です。
実装は単純ですが、古くても頻繁に使うデータまで削除されてしまう可能性があるため、性能面では劣る場合があります。
キャッシュとバッファの違い
キャッシュと混同されやすい言葉に「バッファ(Buffer)」があります。
どちらも「一時的な保存領域」という点では共通していますが、その目的が異なります。
キャッシュは、前述の通り「同一データへの再アクセスを高速化すること」が主な目的です。
対してバッファは、「転送速度の異なるデバイス間の速度差を吸収すること」を目的としています。
例えば、プリンターにデータを送る際、PCの送信速度に対してプリンターの印刷速度が遅いため、一時的にデータを溜めておく領域がバッファです。
ストリーミング動画を視聴する際、通信が途切れないように少し先のデータをあらかじめ読み込んでおくのもバッファリングと呼ばれます。
キャッシュ利用における注意点とデメリット
キャッシュは非常に便利な技術ですが、導入にあたって考慮すべき課題も存在します。
データの整合性(コヒーレンシ)
キャッシュにコピーされたデータと、元のストレージにあるデータが一致しなくなる状態を回避しなければなりません。
特にマルチコアCPUや分散サーバー環境では、一方がデータを更新した際、他のキャッシュにある古いデータを無効化する複雑な制御が必要です。
キャッシュ・スタンプ(Cache Stampede)
キャッシュの有効期限が切れた瞬間に、大量のアクセスがオリジナルのデータベース等へ殺到し、システムがダウンする現象です。
適切な有効期限の設定や、再構築のタイミングをずらすといった対策が求められます。
古いデータの参照(Stale Data)
ウェブサイトの更新を行ったのに、ブラウザに古いキャッシュが残っているせいで、変更が反映されないことがあります。
これを防ぐためには、キャッシュのクリアを促す設定や、ファイル名にバージョン番号を付与するなどの工夫が必要です。
最新ストレージ技術とキャッシュの進化
近年、NVMe(Non-Volatile Memory express)プロトコルの普及により、ストレージ自体の速度が飛躍的に向上しました。
これにより、キャッシュの役割もさらに高度化しています。
例えば、低速な大容量HDDと高速なSSDを組み合わせ、SSDをキャッシュとして利用する「階層化ストレージ」技術があります。
また、インテルのOptaneメモリのように、メモリとストレージの中間的な速度を持つ不揮発性メモリをキャッシュとして活用する手法も注目されました。
クラウド環境においても、物理的なストレージの物理制約を超えるために、分散キャッシュシステムがインフラの基盤を支えています。
# シンプルなキャッシュ機能の例 (Pythonのlru_cacheデコレータ)
from functools import lru_cache
import time

@lru_cache(maxsize=32)
def heavy_process(n):
    # 重い処理をシミュレート
    time.sleep(2)
    return f"結果: {n}"

# 1回目の呼び出し(時間がかかる)
print(heavy_process(100))

# 2回目の呼び出し(キャッシュから即座に返される)
print(heavy_process(100))結果: 100
結果: 100上記のコード例のように、プログラムレベルでもキャッシュを実装することで、計算負荷の高い処理の繰り返しを避けることができます。
まとめ
キャッシュは、現代のITシステムにおいて「速度の不均衡を解消する魔法の領域」として機能しています。
CPU、ストレージ、ウェブブラウザ、ネットワークなど、あらゆる場所でキャッシュが働いているおかげで、私たちはストレスのないデジタル体験を享受できています。
しかし、その裏側にはデータの不整合を防ぐための高度な管理アルゴリズムや、物理的なデータ保護の仕組みが欠かせません。
エンジニアやIT担当者だけでなく、一般のユーザーも「キャッシュがあるから速い、しかし時には古いデータが残ることもある」という特性を理解しておくことは有用です。
今後もデータ転送量の増大に伴い、キャッシュ技術はよりインテリジェントに、そして不可欠なものとして進化し続けるでしょう。
ストレージを選定したり、Webサイトを運営したりする際には、キャッシュの仕組みを最適に活用できているかをぜひ確認してみてください。