システム開発において、アプリケーション側のプログラミング言語と、データを保存するためのデータベースの間で、データの扱いや構造が噛み合わない現象が発生することがあります。
この技術的なギャップは「インピーダンスミスマッチ」と呼ばれ、古くからエンジニアを悩ませてきた重要な課題の一つです。
現代のソフトウェア開発では、このミスマッチをいかに効率よく解消し、保守性の高いシステムを構築できるかがプロジェクトの成否を分けるポイントとなります。
本記事では、インピーダンスミスマッチの定義や具体的な原因、そしてシステム開発における最新の解消手法について詳しく解説します。
インピーダンスミスマッチとは何か
インピーダンスミスマッチとは、もともとは電気工学の用語で、回路間の電気抵抗(インピーダンス)が一致しないためにエネルギーが効率よく伝達されない状態を指します。
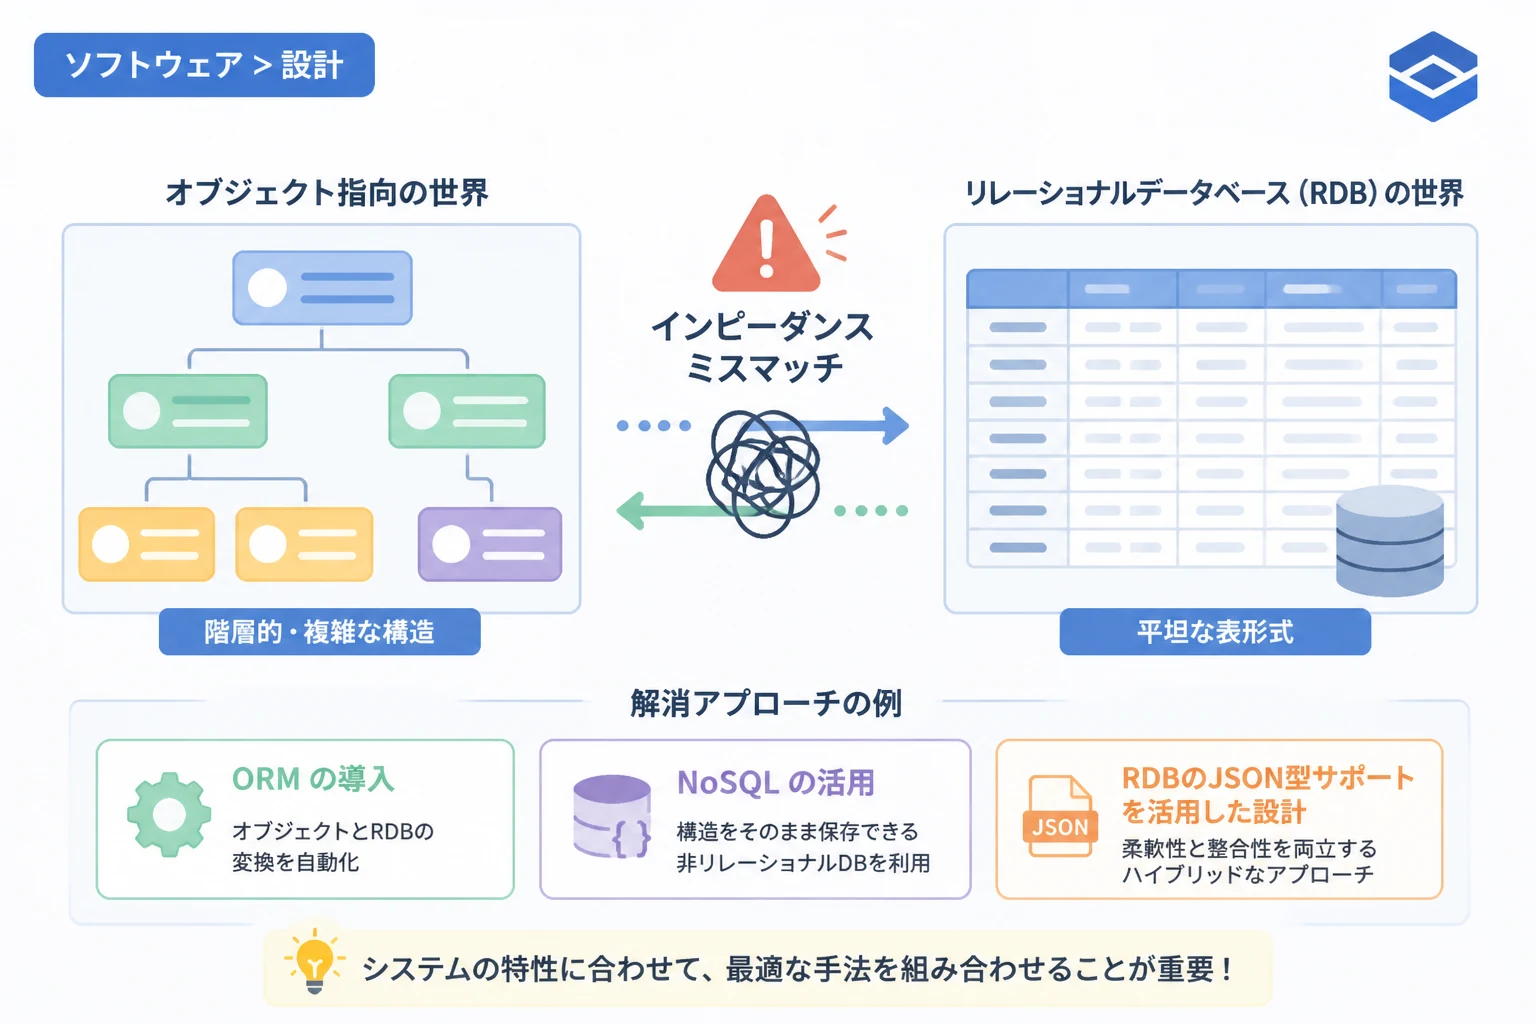
ITの分野、特にソフトウェア開発においては、「オブジェクト指向プログラミング言語」と「関係データベース(RDB)」の間で、データの構造や表現方法が根本的に異なることを意味します。
JavaやPython、Rubyなどのモダンな言語では、データを「オブジェクト」として網目状の構造で扱います。
一方で、OracleやMySQL、PostgreSQLといった関係データベースは、データを「テーブル」という二次元の表形式で管理します。
この「オブジェクト」と「テーブル」という、異なるデータモデルを相互に変換する際に生じる摩擦や不整合が、インピーダンスミスマッチの正体です。
開発者は、このギャップを埋めるために大量の変換コードを書く必要があり、これがバグの温床や開発コストの増大につながっています。
なぜインピーダンスミスマッチが起こるのか
インピーダンスミスマッチが発生する背景には、オブジェクト指向と関係モデルという、二つの異なるパラダイムの設計思想の乖離があります。
ここでは、具体的にどのような違いがミスマッチを引き起こしているのか、4つの主要な側面から解説します。
1. 構造の違い(階層構造と平坦な構造)
オブジェクト指向の世界では、オブジェクトの中に別のオブジェクトを含める「コンポジション(包含)」や階層的な構造が一般的です。
例えば、「注文」オブジェクトの中に複数の「注文明細」オブジェクトが含まれ、さらにその中に「商品」オブジェクトが含まれるといった、再帰的で深い階層を持つことができます。
これに対し、関係データベースは「正規化」というプロセスを経て、データを平坦な二次元の表に分解して保存します。
オブジェクトの階層構造をデータベースに保存しようとすると、複数のテーブルにデータを分散させ、それらを外部キーで紐付ける必要があります。
この「網目状のオブジェクト」を「バラバラの表」に変換して戻す作業が、非常に複雑な処理を要求するのです。
2. 継承の概念の欠如
オブジェクト指向には「継承」という概念があり、親クラスの性質を子クラスが引き継ぐことができます。
例えば、「ユーザー」という親クラスから、「管理者ユーザー」や「一般ユーザー」という子クラスを派生させることが可能です。
しかし、標準的な関係データベースには継承という概念が基本的に存在しません。
継承関係をテーブルで表現するためには、「一つの巨大なテーブルにすべての属性を詰め込む」か、「クラスごとにテーブルを分ける」か、「共通部分だけを別テーブルにする」といった工夫が必要になります。
どの方法を選んでも、プログラム側の直感的な継承関係と、データベース側の物理的なテーブル構造の間にズレが生じてしまいます。
3. アイデンティティ(同一性)の定義
オブジェクト指向では、二つのオブジェクトが同一かどうかは「メモリ上の参照(ポインタ)」で判断されます。
たとえ全ての属性値が同じであっても、メモリ上の配置が異なれば、それらは別々のインスタンスとして扱われます。
一方、関係データベースにおける同一性は「主キー(プライマリキー)」の値によって決定されます。
データベースから読み込んだデータをオブジェクトに変換した後、そのオブジェクトを再びデータベースに書き戻す際、どのレコードを更新すべきかを正しく追跡し続けるのは容易ではありません。
4. カプセル化とアクセスの制限
オブジェクト指向の重要な原則に「カプセル化」があり、内部のデータ(フィールド)を隠蔽し、メソッドを通じてのみ操作を許可します。
しかし、関係データベースは「すべてのデータが公開されていること」を前提としており、SQLを用いて任意の列に対して自由にアクセスできます。
プログラミング側で厳格に隠蔽したはずのデータが、データベース層では丸見えになってしまうという、設計上の矛盾が生じます。
インピーダンスミスマッチがもたらす弊害
インピーダンスミスマッチを放置すると、システムの品質や開発効率に深刻な悪影響を及ぼします。
まず、「ボイラープレートコード(定型的なコード)」の激増が挙げられます。
データベースから取得したレコードを一つずつオブジェクトのプロパティに詰め替える作業は、非常に単調で退屈なプログラミング作業です。
次に、「N+1問題」に代表されるパフォーマンスの劣化が発生しやすくなります。
これは、一つの親データを取得した後に、それに関連する子データをループ内で一件ずつクエリして取得してしまう現象です。
オブジェクトの関連をたどるような直感的なコードを書くと、背後で大量のSQLが発行され、システム全体のレスポンスが低下してしまいます。
| 比較項目 | オブジェクト指向 (OOP) | 関係データベース (RDB) |
|---|---|---|
| データの基本単位 | オブジェクト | レコード(行) |
| データの構造 | グラフ・階層構造 | 表・集合(二次元) |
| 識別方法 | オブジェクトの参照 | 主キー(プライマリキー) |
| 関連の表現 | ポインタ・参照の保持 | 外部キーによる結合 |
| 共通化の手法 | 継承(Inheritance) | なし(テーブル分割等で代用) |
システム開発における解消方法
インピーダンスミスマッチを完全にゼロにすることは難しいですが、現代のシステム開発ではいくつかの有効な解決策が確立されています。
1. ORM(オブジェクト関係マッピング)の導入
最も一般的な解決策は、ORM(Object-Relational Mapping)フレームワークを利用することです。
ORMは、オブジェクトとテーブルの間の変換を自動的に行い、開発者が直接SQLを書かなくてもデータベース操作ができるようにするツールです。
代表的なツールには、Javaの「Hibernate」、Ruby on Railsの「ActiveRecord」、Pythonの「SQLAlchemy」、TypeScriptの「Prisma」などがあります。
ORMを使用することで、エンジニアはデータの詰め替え作業から解放され、ビジネスロジックの実装に集中できるようになります。
# SQLAlchemyを用いたORMの例
# データベースのレコードをオブジェクトとして直感的に操作できる
user = session.query(User).filter_by(id=1).first()
user.name = "田中太郎"
session.commit() # 自動的にUPDATE文が発行される
2. NoSQLデータベースの活用
RDBそのものを使わず、オブジェクトの構造をそのまま保存できる「NoSQLデータベース」を採用するという選択肢もあります。
特に「ドキュメント指向データベース」であるMongoDBなどは、データをJSON(BSON)形式で保存するため、プログラム側のオブジェクト構造と極めて相性が良いのが特徴です。
階層構造をそのままネストされたドキュメントとして保存できるため、変換によるオーバーヘッドや摩擦がほとんど発生しません。
ただし、強力なトランザクション機能や複雑な結合クエリが必要なシステムでは、引き続きRDBが優位なケースも多いため、用途に応じた使い分けが重要です。
3. データ転送オブジェクト (DTO) の設計
プログラム内部の複雑なオブジェクトをそのままデータベースに当てはめようとせず、データの受け渡し専用のシンプルなクラス(DTO)を用意する手法です。
これにより、ドメインモデル(ビジネス論理を持つオブジェクト)と、データベースの永続化モデルを明確に分離できます。
設計は多少複雑になりますが、データベースの構造変更がプログラム全体に波及するのを防ぎ、保守性を高めることができます。
4. RDBのJSON型サポートを利用する
近年のPostgreSQLやMySQLなどのRDBは、カラム内にJSON形式のデータをそのまま格納できる「JSON型」をサポートしています。
基本構造は厳格なテーブル形式で管理しつつ、頻繁に変更される階層構造や柔軟なプロパティのみをJSONカラムに格納するという「ハイブリッドアプローチ」が可能です。
これにより、RDBの堅牢性とNoSQLの柔軟性を良いとこ取りし、ミスマッチの影響を最小限に抑えることができます。
解消方法を選択する際の注意点
インピーダンスミスマッチの解消手段としてORMを導入する場合、その「代償」についても理解しておく必要があります。
ORMは内部で複雑な処理を行っているため、ツールがどのようなSQLを生成しているかを把握していないと、予期せぬパフォーマンス劣化を招くことがあります。
「魔法のツール」として盲信せず、必要に応じて実行計画を確認したり、生のSQL(Native Query)を併用したりする柔軟な姿勢が求められます。
また、システム全体のアーキテクチャが「データ中心(Data-Centric)」なのか「ドメイン中心(Domain-Centric)」なのかによって、最適な解決策は異なります。
データの整合性が最優先される金融システムなどでは、ミスマッチを受け入れてでも厳格なRDB設計を優先すべきです。
一方で、アジャイルな開発とスピードが求められるWebサービスでは、ORMやNoSQLを積極的に活用して開発速度を優先するのが定石です。
まとめ
インピーダンスミスマッチは、オブジェクト指向言語と関係データベースという、異なる歴史と設計思想を持つ技術を組み合わせる際に必ず直面する問題です。
このギャップを無視して開発を進めると、コードの複雑化やパフォーマンスの低下を招き、最終的にはメンテナンス不可能なシステムになってしまいます。
現代のエンジニアには、ORMの適切な利用、NoSQLの検討、あるいはDTOを用いた階層の分離といった、複数のアプローチを状況に応じて組み合わせるスキルが求められています。
それぞれの技術の特性を深く理解し、インピーダンスミスマッチを最小限に抑える設計を心がけることで、堅牢かつ柔軟なシステムを構築することができるでしょう。
まずは、現在開発しているシステムのデータモデルを見直し、どこに無理な変換が生じているかを特定することから始めてみてください。