音声技術は、私たちの日常生活やビジネスシーンにおいて、今や欠かすことのできない身近な存在となりました。
スマートフォンの音声アシスタントやスマートスピーカーだけでなく、企業のカスタマーサポートや議事録の自動作成など、その活用範囲は劇的に広がっています。
近年の人工知能(AI)技術、特にディープラーニングの飛躍的な進化により、音声技術の精度は人間と同等、あるいはそれ以上のレベルにまで達しようとしています。
本記事では、音声技術の基本的な仕組みから、最新のトレンド、そして今後の展望までを詳しく解説します。
音声技術とは何か
音声技術とは、人間の声をコンピュータで処理し、解析・生成・識別するための技術の総称を指します。
この技術は、大きく分けて「音声認識」「自然言語処理」「音声合成」という3つの要素で構成されています。
まず、人間が発した音響信号をデジタルデータとして取り込み、それをテキストデータに変換するのが音声認識の役割です。
次に、変換されたテキストの意味を理解し、文脈に応じた適切な回答を導き出すのが自然言語処理です。
そして、コンピュータが生成したテキストを、人間の声に近い自然な音声として出力するのが音声合成です。
これら一連のプロセスが組み合わさることで、私たちはコンピュータと「会話」をすることが可能になります。
また、最近では特定の個人の声を識別する「話者識別」や、感情を読み取る「感情認識」といった技術も音声技術の重要な一部として注目されています。
音声技術を支える主要な構成要素
音声技術は単一の技術ではなく、複数の高度なテクノロジーが組み合わさって成り立っています。
ここでは、主要な4つの技術要素について、それぞれの役割を整理します。
1. 音声認識(ASR: Automatic Speech Recognition)
音声認識は、アナログ信号である人間の声を解析し、文字情報(テキスト)に変換する技術です。
マイクから入力された音声の波形を、音素と呼ばれる最小単位に分解して認識を行います。
かつては認識精度に課題がありましたが、現在はニューラルネットワークの活用により、騒音下でも高い精度を誇るようになりました。
2. 自然言語処理(NLP: Natural Language Processing)
音声認識によって得られたテキストは、そのままでは単なる記号の羅列に過ぎません。
自然言語処理は、そのテキストがどのような意味を持ち、どのような意図で発せられたのかを解析します。
文章の構造を分析する「構文解析」や、単語の意味を特定する「意味解析」などがここに含まれます。
3. 音声合成(TTS: Text-to-Speech)
音声合成は、テキストデータを音声波形に変換し、人工的な声を作成する技術です。
従来の機械的な音声とは異なり、最新の技術ではイントネーションやアクセントを学習し、人間と遜色ない自然な発話が可能になっています。
特定の著名人の声を再現する「ボイスクローニング」も、この音声合成技術の応用例です。
4. 音声バイオメトリクス(話者認識)
音声バイオメトリクスは、声の特徴から個人を特定する「声紋認証」技術です。
指紋や顔認証と同様に、声の高さ、周波数、話し方の癖などを分析して本人確認を行います。
非接触で認証が行えるため、セキュリティ分野やコールセンターでの本人確認への活用が進んでいます。
| 技術名称 | 略称 | 主な役割 | 活用例 |
|---|---|---|---|
| 音声認識 | ASR | 声を文字に変換する | 文字起こし、音声入力 |
| 自然言語処理 | NLP | 言葉の意味を理解する | チャットボット、翻訳 |
| 音声合成 | TTS | 文字を声に変換する | カーナビ、読み上げ機能 |
| 話者認識 | – | 誰の声かを特定する | 声紋認証、本人確認 |
音声認識の仕組みとプロセス
音声がどのようにしてコンピュータに理解されるのか、その技術的なプロセスを段階的に見ていきましょう。
音声処理は、大きく分けて「前処理」「特徴量抽出」「デコーディング」の3つのステップで進行します。
前処理(ノイズ除去とデジタル化)
マイクが拾った音声には、周囲の雑音やエコーが含まれていることがほとんどです。
まず、これらの不要なノイズを取り除き、純粋な音声データのみを抽出する作業が行われます。
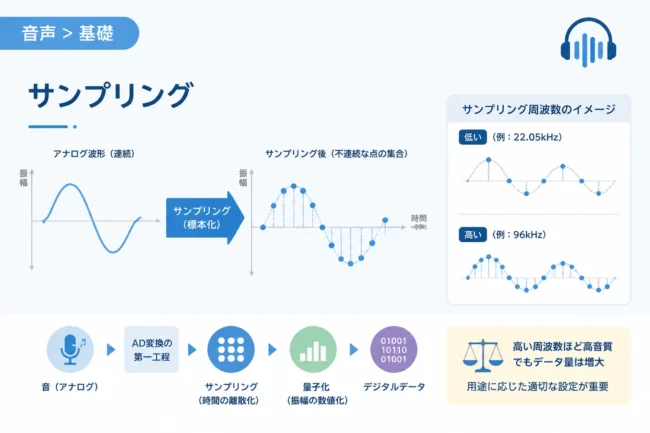
その後、連続的なアナログ波形を、コンピュータが処理しやすいデジタル信号へと変換(サンプリング)します。
特徴量抽出
デジタル化されたデータから、音声の特徴を示す「特徴量」を取り出します。
これには、周波数分布や音の強弱といった情報が含まれ、人間の耳が音を認識する仕組みを模した手法が用いられます。
このプロセスによって、膨大なデータ量が、認識に必要な重要な情報だけに圧縮されます。
デコーディング(音響モデルと言語モデル)
抽出された特徴量は、あらかじめ学習された2つのモデルに照らし合わされます。
「音響モデル」は、入力された音がどの音素(「あ」「い」「う」など)に対応するかを判定します。
「言語モデル」は、単語のつながりとして不自然でないか、文脈的に正しい組み合わせはどれかを確率的に計算します。
最終的に、最も確からしい単語の並びがテキストとして出力されるのです。
# 音声認識のシンプルなプログラム例(SpeechRecognitionライブラリを使用)
import speech_recognition as sr

# 認識器の初期化
recognizer = sr.Recognizer()

# マイクからの入力を受け取る
with sr.Microphone() as source:
    print("何か話してください...")
    audio = recognizer.listen(source)

try:
    # Google Web Speech APIを使用して音声をテキストに変換
    text = recognizer.recognize_google(audio, language="ja-JP")
    print("認識結果: " + text)
except sr.UnknownValueError:
    print("音声が認識できませんでした")
except sr.RequestError:
print("サーバーに接続できません")何か話してください...
認識結果: 音声技術の仕組みを勉強しています最新の音声技術活用トレンド
現在の音声技術は、単なる「便利なツール」の枠を超え、ビジネスモデルそのものを変革する力を持ち始めています。
特に注目すべき3つのトレンドについて解説します。
生成AIとの融合
ChatGPTに代表される大規模言語モデル(LLM)と音声技術の統合は、最もホットなトピックです。
これにより、従来の機械的な一問一答ではなく、文脈を完璧に理解した人間らしい雑談や、複雑な相談が可能になりました。
ユーザーの意図を汲み取り、よりパーソナライズされた体験を提供する「AIエージェント」の開発が加速しています。
リアルタイム多言語翻訳
音声認識と機械翻訳、音声合成を組み合わせることで、異なる言語間でのリアルタイム会話が実現しています。
国際会議や観光、医療現場において、言語の壁を感じさせないスムーズなコミュニケーションが可能になっています。
最新のモデルでは、翻訳後の音声に話し手本人の声質を維持したまま別言語を話させる技術も登場しています。
感情認識技術の高度化
声のトーン、ピッチ、話すスピードを分析し、話し手の感情を読み取る技術が実用化されています。
カスタマーサポートにおいて、顧客の怒りや不満を早期に検知し、適切なオペレーターに引き継ぐといった活用が行われています。
また、メンタルヘルスケアの分野でも、声の変化からうつ状態などの兆候を察知する研究が進められています。
音声技術がもたらすビジネス上のメリット
多くの企業が音声技術を導入する背景には、具体的な経営上のメリットが存在します。
主な利点として、業務効率化、顧客体験の向上、アクセシビリティの確保が挙げられます。
業務効率の飛躍的な向上
議事録の自動作成ツールを導入することで、これまで数時間かかっていた作業が数分に短縮されます。
また、現場作業員が両手を使わずに音声でレポートを入力することで、作業効率と安全性を同時に高めることができます。
顧客体験(CX)の刷新
24時間365日対応可能な音声AIボットにより、顧客の待機時間をゼロにすることが可能です。
AIが初期対応を行い、複雑な案件のみを人間に繋ぐことで、サポート品質の均一化とコスト削減を両立できます。
アクセシビリティの改善
視覚障がいを持つ方や、キーボード入力が困難な高齢者にとって、音声技術は重要なインターフェースとなります。
すべての人がデジタルデバイスの恩恵を受けられる「デジタル・インクルージョン」を実現するための鍵となります。
導入における課題と注意点
音声技術は万能ではありません。
導入に際しては、いくつかの留意すべき点があります。
まず、プライバシーとデータセキュリティの問題です。
音声データは極めて個人的な情報を含んでいるため、その収集と保管には厳格なガイドラインが求められます。
次に、周囲の騒音や反響、方言などによる認識精度の低下です。
利用環境に合わせたチューニングや、適切なハードウェア(高性能マイク等)の選定が不可欠となります。
また、AIが生成した音声によるなりすまし(ディープフェイクボイス)のリスクについても、社会的な対策が急がれています。
まとめ
音声技術は、AIの進化とともに驚異的なスピードで発展を続けています。
もはや「声を文字にする」だけの段階は終わり、「言葉の裏にある意図や感情までを理解し、人間のように応答する」次世代のステージへと突入しました。
今後、VUI(音声ユーザーインターフェース)がさらに普及することで、私たちの生活や働き方はより直感的でスマートなものに変わっていくでしょう。
企業にとっても、この進化する音声技術をいかに戦略的に取り入れるかが、将来の競争力を左右する重要な鍵となります。
私たちは今、テクノロジーと声が真に調和する、新しいコミュニケーションの時代の入り口に立っています。