人工知能やディープラーニングの分野において、データの順序や時間の経過を考慮した処理は非常に重要なテーマです。
エルマンネットワーク(Elman Network)は、このような時系列データを扱うために考案された再帰型ニューラルネットワーク(RNN)の初期のモデルとして知られています。
1990年にジェフリー・エルマン氏によって提案されたこのモデルは、ネットワーク内部に過去の情報を保持する仕組みを取り入れた画期的なものでした。
現代の高度なAI技術の基礎を築いたエルマンネットワークについて、その構造や仕組み、メリット、そして現代の技術との違いを詳しく解説していきます。
エルマンネットワークとは?
エルマンネットワークは、一般的に「シンプル・リカレント・ネットワーク(SRN)」とも呼ばれる、最も基本的な再帰型ニューラルネットワークの一種です。
従来の階層型ニューラルネットワーク(フィードフォワードネットワーク)は、入力されたデータを一度だけ処理して出力するため、情報の流れが一方通行であるという特徴がありました。
そのため、前後のデータのつながりが重要となる「音声データ」や「文章の文脈」といった時系列情報の処理には不向きとされてきました。
エルマンネットワークは、中間層(隠れ層)の出力を一時的に保存し、それを次のタイミングの入力として再利用する構造を持っています。
この「内部状態のフィードバック」により、ネットワークは短期的な記憶を持つことが可能になりました。
現在広く使われているLSTM(Long Short-Term Memory)やGRU(Gated Recurrent Unit)といった高度なRNNの原点とも言える技術です。
エルマンネットワークの基本構造
エルマンネットワークの最大の特徴は、通常の入力層、中間層、出力層に加えて、「コンテキスト層(Context Layer)」という特殊な層を備えている点です。
ここでは、各層がどのような役割を担っているのかを詳しく見ていきましょう。
各層の役割と情報の流れ
エルマンネットワークは、以下の4つの主要な要素で構成されています。
- 入力層:外部からのデータを受け取る層です。
- 中間層(隠れ層):入力データとコンテキスト層からの情報を組み合わせて処理を行う層です。
- コンテキスト層:1つ前の時刻における中間層の状態をそのままコピーして保持する層です。
- 出力層:中間層の処理結果に基づき、最終的な予測値や分類結果を出力する層です。
情報の流れは、まず入力層から中間層へと伝わりますが、このとき同時に「一歩前の自分自身の状態」がコンテキスト層から中間層へと入力されます。
この仕組みにより、現在の処理に過去のエッセンスを加えることができ、連続性のあるデータを扱うことが可能となります。
コンテキスト層が果たす「記憶」の役割
コンテキスト層は、まさにネットワークにとっての「短期記憶装置」のような役割を果たします。
中間層の値をそのまま保存するだけで、重み(ウェイト)の更新が行われない点が、他の層との大きな違いです。
具体的には、時刻 t において中間層が計算した結果が、次の時刻 t+1 における計算の際の補助情報として使われます。
これにより、文脈(コンテキスト)に応じた出力が可能になり、例えば「私は」の次に「学校へ」が来る確率を学習できるようになります。
エルマンネットワークの仕組みを詳しく解説
エルマンネットワークがどのようにして時系列データを処理しているのか、その動作原理をさらに深掘りします。
情報の循環プロセス
エルマンネットワークの動作は、離散的な時間ステップごとに繰り返されます。
まず、時刻 t において外部入力ベクトルが入力層に与えられます。
中間層は、この外部入力と、コンテキスト層に保存されている時刻 t-1 の中間層出力を合算し、活性化関数を通して新しい状態を計算します。
計算された中間層の新しい値は、出力層へ送られて予測結果を生み出すと同時に、次回のステップのためにコンテキスト層の値を上書きします。
このプロセスを繰り返すことで、ネットワーク内部で情報が循環し、過去の影響を保持し続けることができるのです。
学習アルゴリズム:BPTT(Backpropagation Through Time)
エルマンネットワークの学習には、一般的な誤差逆伝播法を時系列に拡張した「BPTT(Backpropagation Through Time)」が用いられます。
BPTTは、時間の流れをネットワークの階層のように展開して考え、過去に遡って誤差を計算する手法です。
各時刻での誤差を計算し、それぞれの重みパラメータがどれだけ最終的なエラーに寄与したかを算出します。
ただし、エルマンネットワークのような単純な構造では、「勾配消失問題」と呼ばれる現象が発生しやすく、あまり長い時間の記憶を遡ることは困難です。
エルマンネットワークとジョーダンネットワークの違い
エルマンネットワークとよく比較される初期のRNNモデルに「ジョーダンネットワーク」があります。
どちらも再帰的な構造を持っていますが、情報をフィードバックする場所に違いがあります。
| 項目 | エルマンネットワーク | ジョーダンネットワーク |
|---|---|---|
| フィードバック元 | 中間層(隠れ層) | 出力層 |
| 記憶の内容 | 内部的な状態・文脈 | 過去の具体的な出力結果 |
| 主な提案者 | Jeffrey Elman | Michael I. Jordan |
| 特性 | 複雑な内部パターンの記憶に向く | 出力の傾向を捉えるのに向く |
エルマンネットワークは、中間層の抽象的な情報を保持するため、より複雑な文脈やパターンを学習する能力に優れているとされています。
一方で、ジョーダンネットワークは出力結果を直接利用するため、過去の結果が明確な影響を与える予測タスクに適しています。
エルマンネットワークのメリット
現代の複雑なモデルと比較した際、エルマンネットワークには以下のような独自のメリットがあります。
構造がシンプルで理解しやすい
エルマンネットワークはRNNの最小構成とも言える構造であるため、アルゴリズムの挙動を直感的に理解しやすいという特徴があります。
数学的なモデル化が容易であり、時系列処理の基礎を学ぶための教材としても非常に優れています。
また、複雑なゲート機構を持たないため、計算コストが低く、限られたリソースでも動作させることが可能です。
短期的な時系列パターンの抽出に強い
直近の数ステップ程度の情報であれば、エルマンネットワークでも十分に高い精度でパターンを抽出できます。
例えば、短い単語の並びや、急激に変化するセンサーデータの局所的な特徴を捉えるのには適しています。
特定の条件下では、最新の複雑なモデルよりも高速に収束し、実用的なパフォーマンスを発揮することもあります。
エルマンネットワークの課題と限界
一方で、実運用においてエルマンネットワークが直面する大きな課題も存在します。
勾配消失問題と長距離依存性
エルマンネットワークにおける最大の弱点は、「長期的な依存関係」を学習できないことです。
BPTTによって過去に遡って誤差を伝播させる際、活性化関数の微分値を何度も掛け合わせる必要があります。
この過程で勾配(学習のための信号)が極端に小さくなってしまう「勾配消失問題」が発生し、数ステップ以上前の情報を正確に反映できなくなります。
長い文章の最初の方に出てきた単語を、文末の処理に活かすといった高度な処理は、このモデル単体では困難です。
記憶の制御ができない
エルマンネットワークのコンテキスト層は、毎ステップで中間層の値をすべて上書きしてしまいます。
「どの情報を忘れ、どの情報を重要として残すか」という選択的な記憶の制御機能を持っていません。
この限界を克服するために、後にLSTMのような「ゲート」の概念を持つモデルが開発されることとなりました。
エルマンネットワークの主な活用事例
登場から長い年月が経っていますが、エルマンネットワークの考え方はさまざまな分野で応用されてきました。
自然言語処理(NLP)の初期段階
エルマンネットワークは、文法構造の学習や、次にくる単語の予測といった言語モデルの研究において重要な役割を果たしました。
「文脈を読む」という概念をニューラルネットワークに持ち込んだ功績は大きく、初期の機械翻訳のプロトタイプなどでも利用されていました。
株価や気象の短期予測
金融市場や気象データなど、時間とともに変化する数値データの解析にも活用されてきました。
数時間後や数日後のトレンドを予測するための軽量なモデルとして、現在でも特定のニッチな解析手法の一部として組み込まれることがあります。
音声信号のパターン認識
音声は時間的な広がりを持つデータであるため、エルマンネットワークの構造と相性が良い分野です。
特定の音のパターンや、短いフレーズの識別において、そのリアルタイム性を活かした実装が行われてきました。
実装のイメージ:Pythonによる概念コード
エルマンネットワークの構造をより具体的に理解するために、Pythonでの簡易的な実装イメージを紹介します。
ここでは、ライブラリを使用せずにその計算フローを再現するようなコードを記述します。
import numpy as np

# パラメータの設定
input_size = 10   # 入力層のサイズ
hidden_size = 20  # 中間層のサイズ
output_size = 5   # 出力層のサイズ

# 重みの初期化
W_xh = np.random.randn(hidden_size, input_size) * 0.01  # 入力から中間層
W_hh = np.random.randn(hidden_size, hidden_size) * 0.01 # コンテキストから中間層
W_hy = np.random.randn(output_size, hidden_size) * 0.01 # 中間層から出力

# 初期状態(コンテキスト層)の定義
h_prev = np.zeros((hidden_size, 1))

def forward_step(x, h_prev):
    # 中間層の計算(現在の入力 + 過去の状態)
    # h = tanh(W_xh * x + W_hh * h_prev)
    h_next = np.tanh(np.dot(W_xh, x) + np.dot(W_hh, h_prev))

    # 出力層の計算
    y = np.dot(W_hy, h_next)

    return y, h_next

# サンプル入力
x_t = np.random.randn(input_size, 1)

# 1ステップ実行
output, h_context = forward_step(x_t, h_prev)

print("出力結果の形状:", output.shape)
print("保存されたコンテキストの形状:", h_context.shape)出力結果の形状: (5, 1)
保存されたコンテキストの形状: (20, 1)このコードからもわかる通り、「h_prev」という過去の状態が計算式に含まれていることが、エルマンネットワークの核心部分です。
エルマンネットワークから次世代モデルへ
エルマンネットワークが抱えていた「長期記憶が保持できない」という問題は、1997年に提案されたLSTM(Long Short-Term Memory)によって大きく改善されました。
LSTMは「セル状態」というさらに長期的な情報を流すためのラインを追加し、ゲートによって情報の取捨選択を行います。
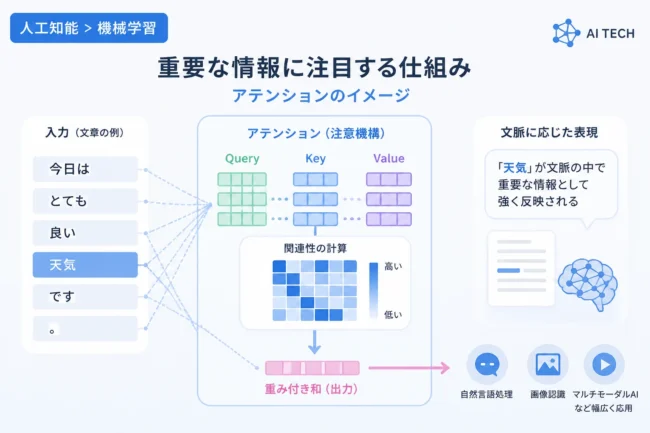
しかし、近年の「Attention(アテンション)」機構や「Transformer」の登場により、RNNという枠組み自体が、より並列処理に適した新しいアーキテクチャへと置き換わりつつあります。
それでもなお、エルマンネットワークの「内部状態を保持して再利用する」という哲学は、現代のAI技術の中に脈々と受け継がれています。
まとめ
エルマンネットワークは、時系列データの処理を可能にした再帰型ニューラルネットワーク(RNN)の先駆的なモデルです。
コンテキスト層を通じて過去の状態を現在に反映させるその仕組みは、人間が文脈を理解するプロセスを数学的に表現しようとした画期的な試みでした。
勾配消失問題などの弱点はありますが、そのシンプルさゆえに、ディープラーニングの基礎理論を学ぶ上では欠かせない存在です。
最新のAIモデルを扱う際も、その根底にあるエルマンネットワークの思想を理解しておくことで、より深い洞察が得られることでしょう。
今後、時系列データの解析に取り組む際は、ぜひこのシンプルな「記憶の仕組み」を思い出してみてください。