近年の人工知能(AI)技術、特にChatGPTをはじめとする大規模言語モデル(LLM)の急速な発展を支えている中心的な技術が「アテンション(Attention/注意機構)」です。
アテンションは、膨大なデータの中から「どこに注目すべきか」をモデル自身が判断する仕組みであり、自然言語処理の歴史を大きく塗り替えました。
本記事では、アテンションの基礎概念から具体的な仕組み、そして現代のAIに欠かせないTransformerモデルにおける役割まで、最新の動向を踏まえて詳しく解説します。
アテンション(注意機構)とは何か
アテンションとは、入力データの一部に「注意(Attention)」を向け、重要な情報に高い重みを与える仕組みのことです。
人間が文章を読むとき、すべての単語を均等に認識しているわけではなく、文脈を理解するために重要なキーワードを無意識に選び出しています。
例えば、「彼は公園で犬を散歩させていたが、それはとても楽しそうだった」という一文を考えてみましょう。
ここで「それ」という代名詞が何を指しているのかを判断するためには、「散歩」や「犬」といった単語に注目する必要があります。
アテンション機構は、このような情報の関連性を数値化し、処理の優先順位を決定する役割を担っています。
かつてのディープラーニングモデルでは、長い文章の情報を固定長のベクトルに詰め込む必要があり、情報の欠落が課題となっていました。
しかし、アテンションの登場により、入力データの長さに関わらず、必要な箇所から直接情報を引き出すことが可能になったのです。
アテンションが登場した背景と歴史
アテンションが普及する以前、自然言語処理の主流はRNN(再帰型ニューラルネットワーク)やLSTM(長短期記憶)でした。
RNNは時系列データを順番に処理していく性質を持っており、前の単語の情報を隠れ状態として次に引き継ぎます。
しかし、RNNには「文章が長くなると、最初の方の情報を忘れてしまう」という勾配消失問題や情報のボトルネック問題が存在していました。
2014年頃、翻訳タスクにおいてこの課題を解決するために提案されたのが、初期のアテンション機構です。
当時の手法は、RNNのエンコーダーが出力する各単語の状態に対して、デコーダーが適宜参照しに行くという補助的な役割でした。
その後、2017年に発表された論文「Attention Is All You Need」によって、RNNを使わずアテンションのみで構成された「Transformer」が登場します。
これにより、処理の並列化が可能になり、学習効率と精度が劇的に向上したことで、現在のAIブームの基盤が築かれました。
アテンションの核心的な仕組み:Q・K・V
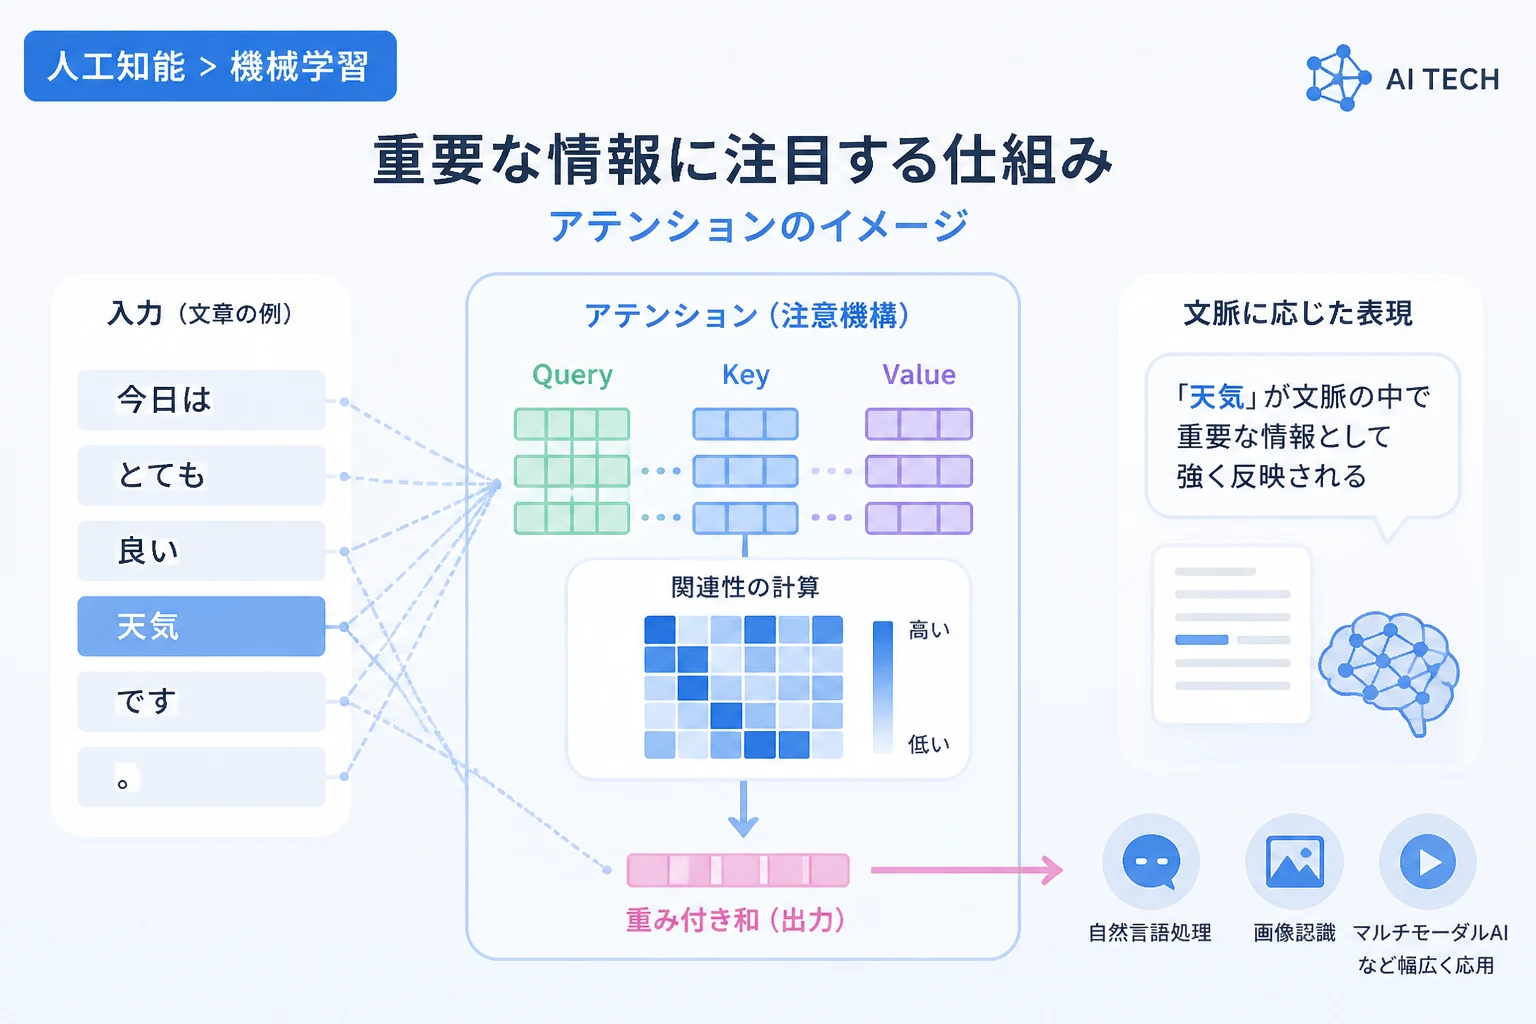
アテンションの計算において最も重要な概念が、「クエリ(Query)」「キー(Key)」「バリュー(Value)」という3つの要素です。
これらは、検索エンジンの仕組みに例えると理解しやすくなります。
クエリ(Query:Q)
クエリは、「現在注目している対象」や「何を探しているか」を表す情報です。
検索エンジンにおける検索キーワードそのものに相当します。
キー(Key:K)
キーは、「入力データの各要素がどのような特徴を持っているか」を示すインデックスのようなものです。
検索対象となるWebページのタイトルやメタデータに例えられます。
バリュー(Value:V)
バリューは、「入力データの各要素の具体的な中身」を表す情報です。
クエリとキーの親和性が高いと判断された場合に、実際に取り出される情報の本体です。
アテンションの計算フロー
アテンションのプロセスは、以下の手順で数学的に処理されます。
- クエリ(Q)とすべてのキー(K)の間の類似度(内積)を計算する。
- 計算した類似度をソフトマックス関数に通し、合計が1になるような「重み」に変換する。
- 得られた重みを各バリュー(V)に掛け合わせ、合計を算出する。
この結果、関連性の高い情報が強調され、不要な情報がフィルタリングされた出力が得られます。
アテンションの主要な種類
アテンションには、その用途や構造に応じていくつかの種類が存在します。
それぞれの特徴を理解することで、最新のAIモデルの動作原理がより明確になります。
自己注意機構(Self-Attention)
Self-Attentionは、同じ入力シーケンス内での単語同士の関連性を計算する手法です。
「私はリンゴを食べた」という文において、「食べ」という単語が「私(主語)」や「リンゴ(目的語)」とどう結びついているかを解析します。
これにより、文全体の構造や文脈を一段と深く理解することが可能になります。
相互注意機構(Cross-Attention)
Cross-Attentionは、異なる2つのデータソース間での関連性を計算する手法です。
主に翻訳モデルのエンコーダー・デコーダー構造で使用されます。
翻訳先の単語を生成する際に、翻訳元の文章のどの部分に注目すべきかを判断するために使われます。
マルチヘッドアテンション(Multi-Head Attention)
アテンションを1つの視点だけでなく、複数の異なる「ヘッド(Head)」で並行して行う手法です。
あるヘッドは文法構造に注目し、別のヘッドは意味的な関連性に注目するといった具合に、多様な情報の捉え方ができます。
これにより、モデルは複雑な文脈や多義的な表現を多角的に解釈できるようになります。
Transformerにおけるアテンションの重要性
Transformerは、現在主流となっているほぼすべてのAIモデル(BERT, GPT, T5など)の基盤となっているアーキテクチャです。
Transformerの最大の特徴は、RNNを完全に排除し、アテンションのみで情報の伝達を行う点にあります。
並列処理による学習の高速化
RNNは単語を一つずつ順番に処理しなければならないため、計算を並列化することが困難でした。
一方、Transformerのアテンションは、文章内のすべての単語間の関係を同時に計算することができます。
この並列計算性能の高さが、GPUリソースを最大限に活用した巨大なモデルの構築を可能にしました。
長期依存関係の解決
非常に長いドキュメントであっても、アテンションは文頭と文末の単語を直接結びつけることができます。
これにより、文脈が途切れることなく、一貫性のある文章生成や高度な要約が可能になりました。
スケーラビリティの向上
アテンションを中心とした設計は、データの規模を大きくすればするほど性能が向上するという「スケーリング則」に適しています。
これが、数十億から数兆ものパラメータを持つ大規模言語モデルの誕生に繋がりました。
アテンションと従来手法(RNN/CNN)の比較
アテンションがなぜこれほどまでに画期的なのか、従来のネットワーク手法と比較してみましょう。
| 特徴 | RNN (LSTM/GRU) | CNN (畳み込み) | Attention (Transformer) |
|---|---|---|---|
| 処理単位 | 逐次的(シーケンシャル) | 局所的(フィルタ単位) | 全域的(グローバル) |
| 並列化 | 不可能 | 可能 | 容易に可能 |
| 長期記憶 | 苦手(忘却が発生) | 層を深くする必要あり | 得意(直接参照可能) |
| 計算コスト | 文長に比例 | カーネルサイズに依存 | 文長の2乗に比例(初期型) |
このように、アテンションは計算量こそ増加するものの、学習の効率と表現力の面で圧倒的な優位性を持っています。
アテンションの具体的な活用事例
アテンション技術は、自然言語処理以外にも幅広い分野で応用されています。
機械翻訳
Google翻訳などの高精度な翻訳サービスは、アテンションによってソース言語とターゲット言語の対応関係を正確に把握しています。
文法が大きく異なる言語間でも、適切な語順の入れ替えを実現しています。
画像認識(Vision Transformer)
画像処理においても、ピクセル間の関連性をアテンションで計算する「Vision Transformer (ViT)」が普及しています。
従来のCNNでは捉えにくかった、画像内の離れた物体同士の関係を認識するのに長けています。
ソースコード生成
GitHub Copilotなどのコード補完ツールは、コードの構造的な依存関係をアテンションで解析しています。
関数定義と呼び出し箇所の距離が離れていても、正確な型推論や補完が可能です。
マルチモーダルAI
画像とテキストを同時に扱うAIにおいて、画像のどの部分がテキストのどの単語に対応しているかをアテンションで結びつけています。
「画像の説明文を生成する」といったタスクで非常に重要な役割を果たしています。
アテンションの課題と今後の展望
非常に強力なアテンション機構ですが、万能というわけではなく、いくつかの課題も指摘されています。
計算量の問題(Quadratic Complexity)
標準的なアテンションは、入力データの長さの2乗に比例して計算量が増大します。
これは「2次計算量問題」と呼ばれ、非常に長い文章や高解像度の画像を処理する際の障壁となっています。
この解決策として、計算量を線形に抑える「Linear Attention」や、注目範囲を絞る「Sparse Attention」などの研究が進んでいます。
過学習のリスク
アテンションは非常に表現力が高いため、少量のデータではノイズに対して過剰に適合してしまうことがあります。
そのため、大量の事前学習データと、適切なドロップアウトなどの正則化手法が不可欠です。
説明責任と解釈性
アテンションの重みを可視化することで「モデルがどこを見ているか」をある程度把握することは可能です。
しかし、それがそのまま「人間が納得できる理由」になっているとは限らないという議論も存在します。
アテンションの発展:FlashAttentionなど
計算効率を劇的に向上させるための実装技術として、最近では「FlashAttention」などが注目されています。
これは、GPUのメモリ階層を意識した高速なアルゴリズムであり、同じハードウェアでも数倍の速度向上を実現します。
こうした低レイヤーの最適化により、さらに長いコンテキストウィンドウ(一度に処理できる情報量)を持つAIが登場し続けています。
また、アテンションの概念をさらに拡張し、必要な時だけ計算を行う動的な注意機構の研究も盛んです。
プログラムでのアテンション実装例
最後に、アテンションの概念を簡略化したPythonコードによる実装例を紹介します。
これは、クエリとキーから重みを計算し、バリューを重み付け加算する基本的な仕組みを示したものです。
import torch
import torch.nn.functional as F

def simple_attention(q, k, v):
    # 1. クエリ(Q)とキー(K)の類似度を内積で計算
    # q, k の形状は [batch, seq_len, dim]
    scores = torch.matmul(q, k.transpose(-2, -1))

    # 2. スケーリング(次元の平方根で割る)
    dim_k = k.size(-1)
    scores = scores / (dim_k ** 0.5)

    # 3. ソフトマックス関数で重みを正規化
    weights = F.softmax(scores, dim=-1)

    # 4. 重みをバリュー(V)に掛けて出力
    output = torch.matmul(weights, v)

    return output, weights

# サンプルデータの作成
# クエリ、キー、バリューを同じデータから生成(自己注意機構の模倣)
data = torch.randn(1, 5, 64) # 1バッチ, 5単語, 64次元
output, weights = simple_attention(data, data, data)

print("Output shape:", output.shape)
print("Attention weights shape:", weights.shape)Output shape: torch.Size([1, 5, 64])
Attention weights shape: torch.Size([1, 5, 5])このコードは非常に簡略化されていますが、実際のTransformer内部で行われている計算の核心を突いています。
実際のライブラリ(PyTorchのnn.MultiheadAttentionなど)では、さらに多頭化やマスク処理などが加わります。
まとめ
アテンション(注意機構)は、現代のAI技術における最も革新的な発明の一つと言っても過言ではありません。
膨大な情報の中から重要な部分を動的に選び出すこの仕組みは、RNNが抱えていた長期記憶の課題を克服し、Transformerという強力なモデルを生み出しました。
その結果、AIは単なるパターン認識を超え、文脈を深く理解し、人間のように自然な文章を生成する能力を手に入れたのです。
現在、アテンションの計算効率をさらに高める研究や、画像・音声といった多種多様なメディアへの応用が加速しています。
計算量の課題や解釈性の問題は残されているものの、アテンションが今後もAI進化の最前線に居続けることは間違いありません。
私たちが日常的に利用するAIサービスの裏側で、この「注意」の仕組みが働いていることを理解することは、最新テクノロジーを使いこなす上で大きな助けとなるでしょう。
今後もアテンションをベースとした新しいアーキテクチャや最適化手法の登場に注目していく必要があります。