機械学習の分野において、モデルの予測精度を極限まで高めるために欠かせない技術が「アンサンブル学習」です。
アンサンブル学習は、単一のモデルで予測を行うのではなく、複数のモデルを賢く組み合わせることで、より強固で正確な結果を導き出す手法を指します。
データサイエンスのコンペティションや実務の現場でも、高い成果を出すための標準的なアプローチとして広く採用されています。
この記事では、アンサンブル学習の基本的な仕組みから、代表的な3つの手法、さらにはそのメリットや注意点について詳しく解説します。
アンサンブル学習とは?複数の知恵を統合する仕組み
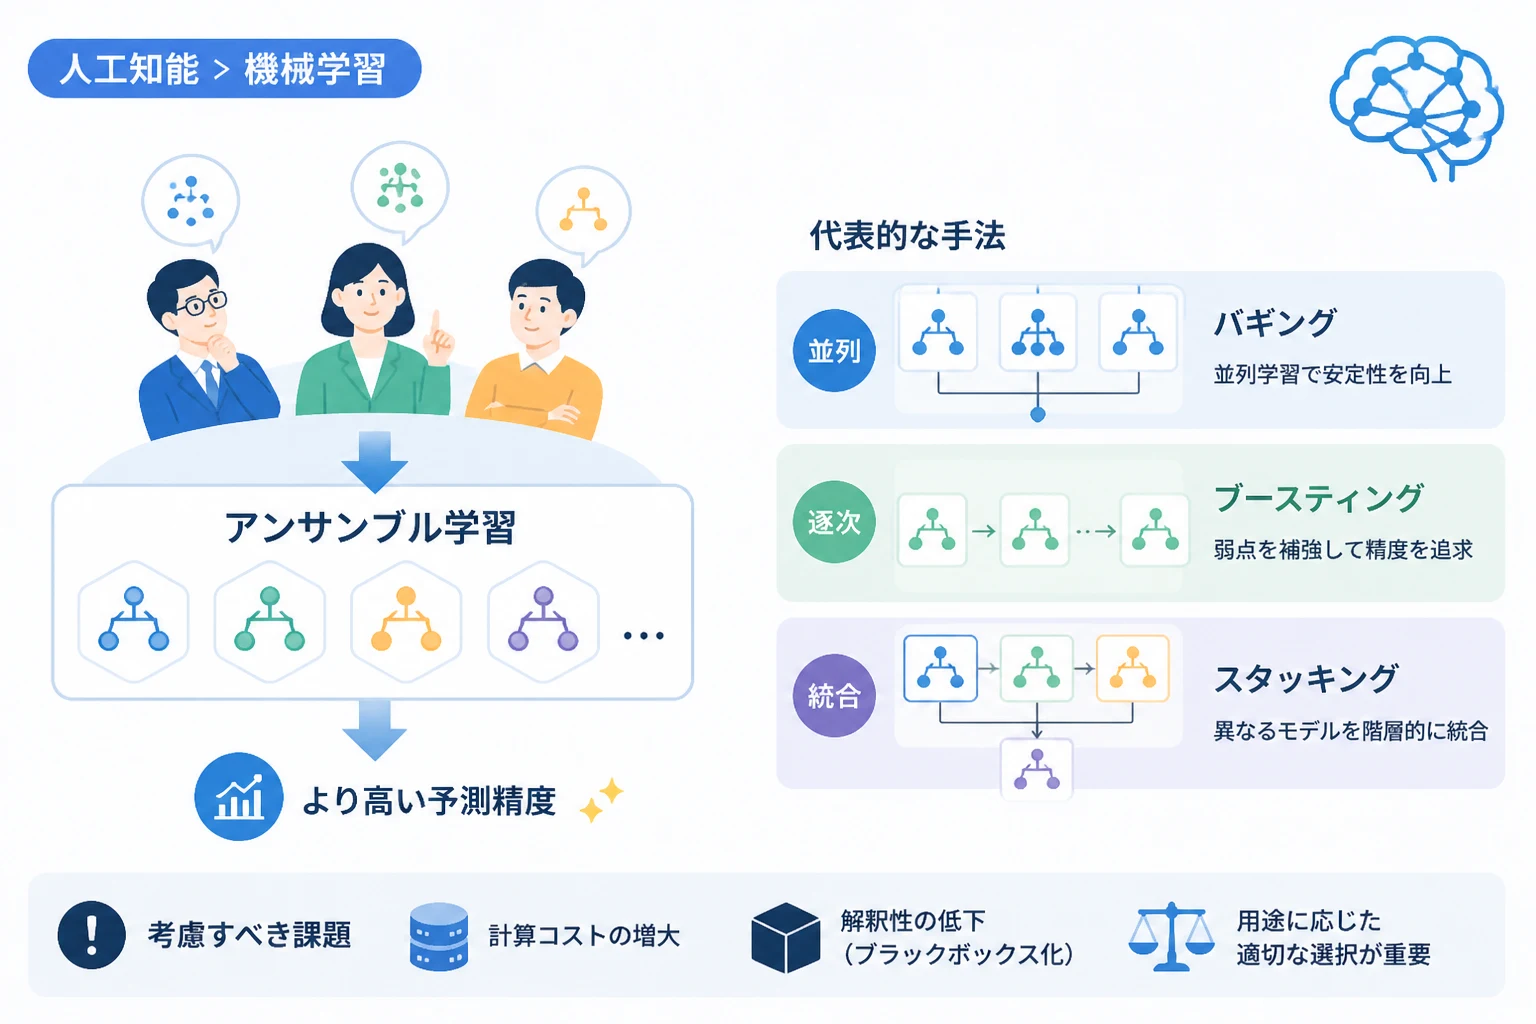
アンサンブル学習(Ensemble Learning)とは、複数の学習アルゴリズムを組み合わせて、単一のアルゴリズムよりも優れた予測性能を得る手法のことです。
この手法は、私たちの日常生活における「合議制」や「三人寄れば文殊の知恵」という考え方に非常に似ています。
一人の専門家が判断を下すよりも、複数の専門家が集まって意見を出し合い、多数決や平均を取る方が、最終的な判断のミスが少なくなるという原理に基づいています。
機械学習における「専門家」は個々の学習モデルを指し、これらを「弱学習器」または「ベースレポータ」と呼びます。
弱学習器とは、単体ではそれほど高い精度を持たないモデルのことですが、これらを適切に統合することで、非常に精度の高い「強学習器」を構築することが可能になります。
アンサンブル学習の主な目的は、モデルの「バリアンス(分散)」や「バイアス(偏り)」を減少させることにあります。
特定のデータに過剰に適合してしまう過学習を防ぎつつ、未学習の状態を回避して汎用性の高いモデルを作り上げることが、この手法の最大の強みです。
アンサンブル学習の基本的な考え方
アンサンブル学習のプロセスは、大きく分けて「個別のモデルによる学習」と「予測結果の統合」の2段階で構成されます。
まず、同じデータセットや、あるいは一部をサンプリングした異なるデータセットを用いて、複数のモデルを並列または直列に学習させます。
次に、それぞれのモデルが出力した予測値を集計し、最終的な結論を出します。
分類問題であれば多数決が一般的に用いられ、回帰問題であれば平均値や中央値が採用されることが多いです。
なぜアンサンブル学習が必要なのか
単一の強力なモデルを作成するのではなく、あえて複数のモデルを組み合わせるのには明確な理由があります。
機械学習モデルが抱える誤差の原因は、主に「バイアス」「バリアンス」「ノイズ」の3要素に分類されます。
バイアスとは、モデルがデータの真の構造を捉えきれていないことによる誤差を指し、これが高いと未学習(アンダーフィッティング)の原因となります。
バリアンスとは、学習データ内の些細な変化にモデルが過敏に反応してしまうことによる誤差で、過学習(オーバーフィッティング)を引き起こします。
アンサンブル学習は、これらの誤差を効果的に制御する手段を提供してくれます。
例えば、バリアンスが高いモデルを複数集めて平均化すれば、個々のモデルが持つ極端な予測が相殺され、安定した結果が得られます。
また、バイアスが高いモデルであっても、前のモデルの失敗を次のモデルが修正するように学習を進めることで、段階的に精度を高めることができます。
アンサンブル学習の3大手法
アンサンブル学習には、モデルの組み合わせ方によって大きく分けて3つの主要なアプローチが存在します。
それぞれの特性を理解することで、課題に応じた最適な手法を選択できるようになります。
1. バギング(Bagging)
バギングは「Bootstrap Aggregating」の略称であり、並列的に複数のモデルを学習させる手法です。
まず、元のデータセットから重複を許してランダムにデータを抽出する「ブートストラップサンプリング」を行い、複数の異なるサブセットを作成します。
それぞれのサブセットに対して独立したモデルを学習させ、最後にそれらの予測結果を平均化(回帰)または多数決(分類)で統合します。
バギングの最大の利点は、モデルのバリアンスを大幅に抑えられる点にあります。
一部のデータに外れ値が含まれていても、他のモデルがそれをカバーするため、全体として堅牢な予測が可能になります。
バギングの代表的なアルゴリズムとしては、決定木を組み合わせた「ランダムフォレスト(Random Forest)」が非常に有名です。
2. ブースティング(Boosting)
ブースティングは、直列的にモデルを学習させ、段階的に精度を高めていく手法です。
バギングとは異なり、モデルを順番に作成していくのが特徴です。
最初のモデルで予測を行い、その予測が外れたデータに対して「重み」を付与します。
次のモデルは、その重みが大きいデータ(つまり前のモデルが苦手としたデータ)を重点的に学習するように調整されます。
このプロセスを繰り返すことで、弱点を補強し続け、最終的に非常に精度の高い強学習器を作り上げます。
ブースティングはバイアスを減少させる効果が非常に高いですが、一方で学習データに過剰に適合しやすいため、ハイパーパラメータの調整が重要になります。
代表的な手法には「AdaBoost」や「勾配ブースティング(Gradient Boosting)」があり、その派生であるXGBoostやLightGBM、CatBoostは現代の機械学習シーンで主役となっています。
3. スタッキング(Stacking)
スタッキングは、異なる種類のモデルの予測結果を、さらに別のモデルの入力として使う手法です。
バギングやブースティングが通常同じ種類のモデル(主に決定木)を組み合わせるのに対し、スタッキングでは異なるアルゴリズムを混ぜることができます。
例えば、第1層(ベースモデル)として「ロジスティック回帰」「サポートベクターマシン」「決定木」を用意し、それぞれの予測値を出力します。
第2層(メタモデル)では、それらの予測値を「特徴量」として受け取り、最終的な予測を行うための学習を行います。
複数の異なる視点を持つモデルの強みを抽出できるため、非常に高度な予測が可能になりますが、計算コストが高く構造が複雑になるという側面もあります。
主要手法の比較表
各手法の特徴を整理するために、以下の比較表を参考にしてください。
| 手法名 | 学習の進め方 | 主な目的 | 代表的なアルゴリズム |
|---|---|---|---|
| バギング | 並列(独立して学習) | バリアンスの低減(過学習抑制) | ランダムフォレスト |
| ブースティング | 直列(逐次的に学習) | バイアスの低減(精度追求) | XGBoost, LightGBM |
| スタッキング | 階層構造(予測を学習) | 予測精度の最大化 | 独自のメタモデル構築 |
アンサンブル学習のメリット
アンサンブル学習がこれほどまでに普及しているのは、実用上の多くの利点があるからです。
精度の劇的な向上
最も大きなメリットは、単体モデルでは到達できないレベルまで予測精度を高められることです。
モデルを増やすことで、個々のモデルが持つランダムなエラーが相殺され、データの真のパターンに近い予測が可能になります。
過学習への耐性(バギングなど)
特にバギングを用いる手法では、一部のノイズや外れ値に振り回されにくい安定したモデルを構築できます。
これにより、学習データ以外の未知のデータに対しても高い汎化性能を発揮することができます。
異なる特性の結合
スタッキングなどを活用すれば、線形的な関係を捉えるのが得意なモデルと、非線形な関係を捉えるのが得意なモデルを共存させることができます。
これにより、複雑な構造を持つデータセットに対しても柔軟に対応できるようになります。
アンサンブル学習のデメリットと注意点
非常に強力なアンサンブル学習ですが、導入にあたっては考慮すべき課題も存在します。
計算コストの増大
複数のモデルを学習・維持する必要があるため、単純なモデルと比較して計算リソース(CPU/メモリ)を多く消費します。
また、学習にかかる時間もモデルの数に比例して増える傾向にあります。
「ブラックボックス化」の問題
モデルが複雑に組み合わさることで、「なぜそのような予測結果になったのか」という解釈性が低下します。
単一の決定木であれば判断基準を可視化して説明することが容易ですが、数百の木を組み合わせたモデルの説明は困難を極めます。
金融や医療など、判断の根拠(説明責任)が求められる分野では、この透明性の欠如がハードルになる場合があります。
実装の複雑さ
特にスタッキングなどの高度な手法では、データリーク(正解データの漏洩)を防ぐための慎重なバリデーション設計が必要です。
安易に実装すると、学習データでは完璧な精度が出ているように見えても、本番環境では全く役に立たないモデルになってしまう恐意があります。
Pythonによる簡単な実装例
ここでは、代表的なアンサンブル学習手法であるランダムフォレストをPythonで実装する例を紹介します。
scikit-learnライブラリを使用することで、非常に簡単に強力なモデルを作成できます。
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# データセットの読み込み
data = load_iris()
X, y = data.data, data.target

# 学習データとテストデータに分割
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)

# ランダムフォレストのモデルを構築(n_estimators=100は100個の決定木を作る意味)
model = RandomForestClassifier(n_estimators=100, random_state=42)

# モデルの学習
model.fit(X_train, y_train)

# 予測の実行
predictions = model.predict(X_test)

# 精度の表示
print(f"Accuracy: {accuracy_score(y_test, predictions)}")Accuracy: 1.0このコードでは、100個の小さな決定木を作成し、それらの合議制によってアイリス(あやめ)の種類を分類しています。
個々の木が判断を誤っても、他の多くの木が正しい判断を下すことで、極めて高い精度を実現しています。
アンサンブル学習の将来展望
現在、アンサンブル学習はディープラーニングとの融合も進んでいます。
ニューラルネットワークの複数のエポックにおける重みを平均化する「SWA (Stochastic Weight Averaging)」などの技術も、広義のアンサンブル学習と言えます。
また、AutoML(機械学習の自動化)ツールにおいても、最終的な出力精度を最大化するためにアンサンブル学習が自動的に適用されることが一般的になっています。
計算リソースが今後さらに低コスト化していく中で、アンサンブル学習の重要性はますます高まっていくでしょう。
まとめ
アンサンブル学習は、複数のモデルの力を結集させることで、単一のアルゴリズムでは到達できない高精度な予測を可能にする強力な手法です。
バリアンスを抑えて安定性を高めるバギング、バイアスを削って精度を突き詰めるブースティング、そして異なるモデルの長所を統合するスタッキングの3つがその中核を成しています。
計算コストやモデルの透明性といった課題はあるものの、現代のデータ分析業務においてアンサンブル学習を避けて通ることはできません。
まずはランダムフォレストのような扱いやすい手法から始め、徐々にXGBoostやLightGBMといった高度なブースティング手法へとステップアップしていくのが良いでしょう。
データの特性に合わせて最適なアンサンブルの形を見つけ出すことが、優れたデータサイエンティストへの近道となります。