近年、ディープラーニングの技術は目覚ましい発展を遂げており、特に画像生成やスタイル変換の分野では驚くべき成果が次々と発表されています。
こうした高度なAI技術を支えている重要な要素技術の一つに、「正規化(Normalization)」と呼ばれるプロセスが存在します。
正規化は、ニューラルネットワークの学習を安定させ、精度を向上させるために欠かせない処理です。
その中でも「インスタンス正規化(Instance Normalization)」は、画像処理において特有の効果を発揮する手法として知られています。
本記事では、インスタンス正規化の基本的な仕組みから、広く普及しているバッチ正規化との違い、そして最新のAI画像生成における役割までを詳しく紐解いていきます。
インスタンス正規化とは何か
インスタンス正規化は、ディープラーニング、特に畳み込みニューラルネットワーク(CNN)において用いられる正規化手法の一種です。
この手法は、2016年に発表された論文「Instance Normalization: The Missing Ingredient for Fast Stylization」によって広く知られるようになりました。
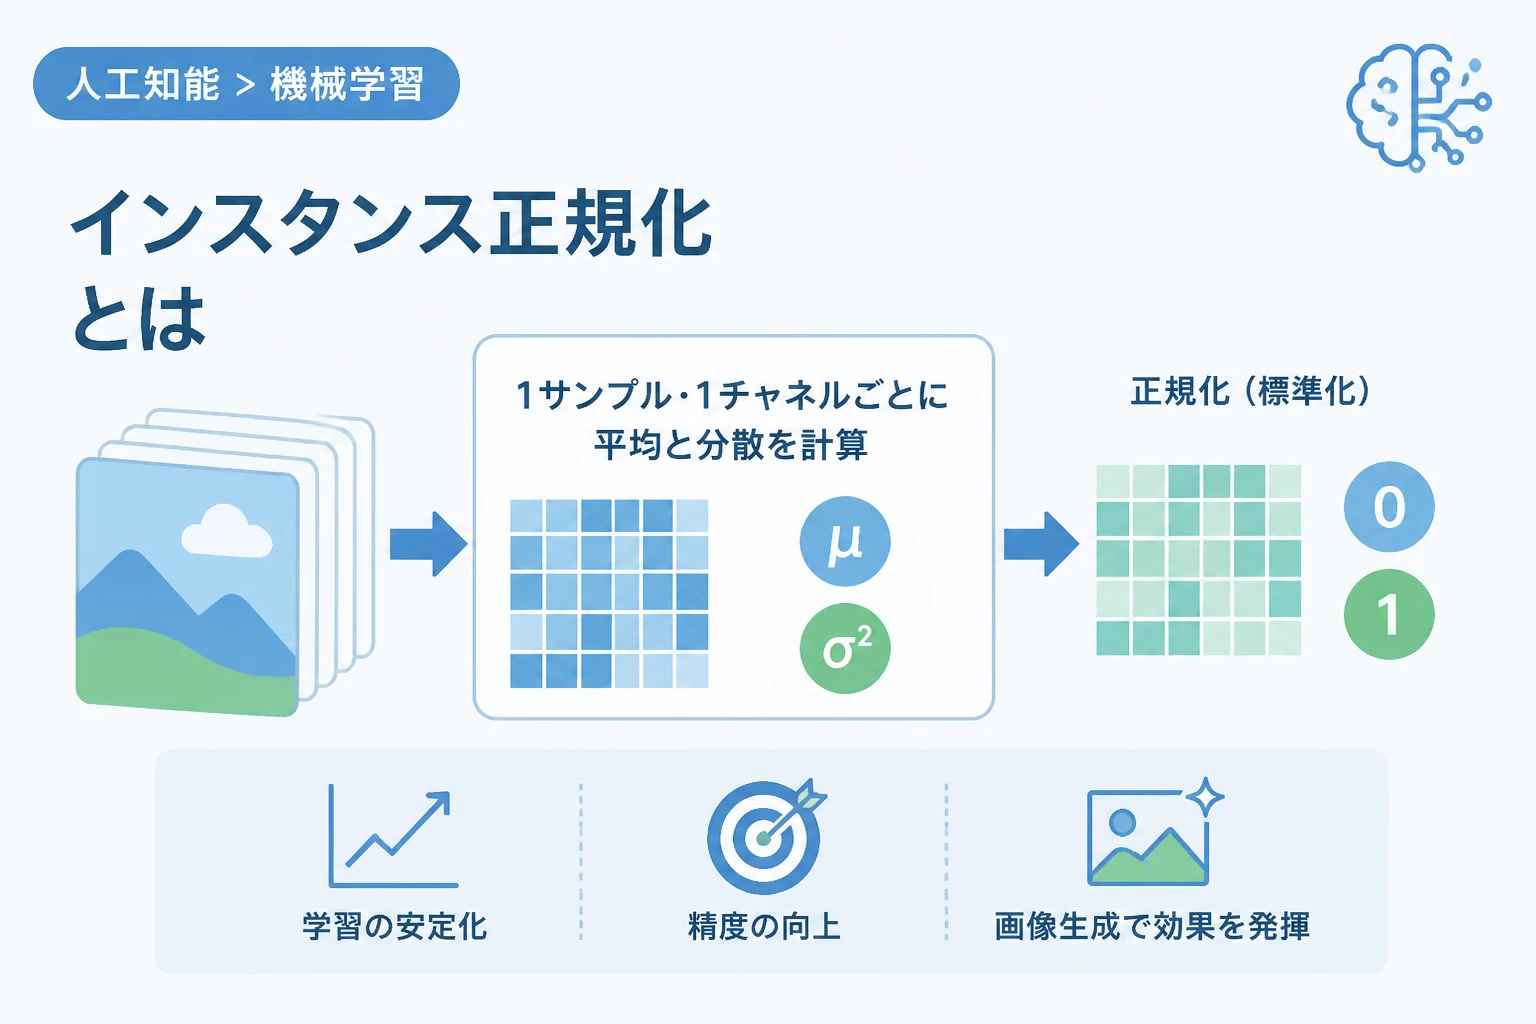
その最大の特徴は、入力データの「1サンプル(1インスタンス)」かつ「1チャネル」ごとに平均と分散を計算し、正規化を行う点にあります。
一般的な画像データにおいて、1つのサンプルは「高さ(H)× 幅(W)× チャネル(C)」という次元で構成されています。
インスタンス正規化では、各サンプルの各チャネル内(H×Wの平面内)だけで統計量を算出するため、他の画像サンプルの影響を全く受けません。
これにより、画像が持つコンテンツの構造は維持しつつ、コントラストや明るさといったスタイル情報を効果的に除去・調整することが可能になります。
画像生成タスクにおいては、この「スタイル情報の分離」が極めて重要な役割を果たします。
正規化が必要とされる理由
なぜ、ニューラルネットワークにおいて正規化が必要なのでしょうか。
深層学習モデルは、多数の層を重ねることで複雑なパターンを学習しますが、層が深くなるにつれて入力データの分布が変化してしまう「内部共変量シフト」という問題に直面します。
データ分布がバラバラになると、学習の収束が遅くなったり、勾配消失・勾配爆発といった問題が発生しやすくなります。
正規化を導入することで、各層への入力を適切な範囲(平均0、分散1など)に揃え、学習を効率的かつ安定的に進めることができるようになります。
インスタンス正規化は、こうした正規化の恩恵を受けつつ、特に画像独自の特性にフォーカスした設計となっています。
インスタンス正規化とバッチ正規化の違い
インスタンス正規化を理解する上で、最も一般的な手法である「バッチ正規化(Batch Normalization)」との比較は避けて通れません。
これら二つの手法は、計算の対象となる範囲が決定的に異なります。
バッチ正規化の仕組みと限界
バッチ正規化は、ミニバッチに含まれる複数のサンプル全体にわたって統計量を計算します。
つまり、同じチャネルであれば、バッチ内の全画像のデータを混ぜて平均と分散を求めることになります。
この手法は画像分類タスクなどでは非常に強力ですが、バッチサイズが小さい場合に学習が不安定になるという弱点があります。
また、画像生成やスタイル変換においては、他のサンプルの統計情報が混ざることがノイズとなり、出力品質を低下させることが指摘されてきました。
計算範囲の比較表
以下の表は、主要な正規化手法における計算範囲の違いをまとめたものです。
| 手法名 | 統計量の計算範囲(次元) | 主な特徴 |
|---|---|---|
| バッチ正規化 (BN) | バッチ全体 (Batch × H × W) | 分類タスクの標準。バッチサイズに依存する。 |
| インスタンス正規化 (IN) | 単一サンプル内のチャネルごと (H × W) | スタイル変換に最適。バッチサイズに依存しない。 |
| レイヤー正規化 (LN) | 単一サンプル内の全チャネル (Channel × H × W) | 自然言語処理(NLP)で主流。RNNやTransformerで多用。 |
| グループ正規化 (GN) | チャネルを数個のグループに分けて計算 | BNとLNの中間的性質。小バッチ時に有効。 |
このように、インスタンス正規化は「個別の画像内のチャネル独立性」を尊重する手法であると言えます。
なぜ画像生成ではインスタンス正規化が好まれるのか
画像生成やスタイル変換において、インスタンス正規化がバッチ正規化よりも優れているとされる理由を深掘りします。
最大の理由は、画像における「コンテンツ」と「スタイル」の分離能力にあります。
スタイル不変性の獲得
画像のスタイル(筆致や色彩、質感など)は、多くの場合、チャネル間の統計的な特徴として現れます。
インスタンス正規化を適用すると、各チャネルの平均と分散が強制的に一定にリセットされます。
これは、画像から固有のスタイル情報を一旦取り除く(正規化する)作業に相当します。
その結果、ネットワークの以降の層では、純粋な画像構造(コンテンツ)の処理に集中しやすくなります。
スタイルの変更が必要な場合は、正規化した後に別のスタイルパラメータを適用することで、自由自在に見た目を変換できるようになります。
バッチサイズからの解放
画像生成モデルは非常にメモリを消費するため、学習時のバッチサイズを1や2といった極小の値に設定せざるを得ないケースが多々あります。
バッチ正規化はバッチサイズが小さいと統計量が不安定になり、精度が著しく低下します。
一方、インスタンス正規化は単一のサンプルのみで計算を完結させるため、バッチサイズが1であっても安定して動作します。
この特性が、高解像度な画像生成を目的とするモデルにおいて大きなアドバンテージとなります。
AI画像生成における具体的な役割
現代のAI技術において、インスタンス正規化はどのような場所で使われているのでしょうか。
具体的な応用例を挙げて解説します。
リアルタイム・スタイル変換
写真をお洒落な絵画調に変換するアプリなどで使われる「スタイル変換」技術において、インスタンス正規化は革命を起こしました。
従来のバッチ正規化をインスタンス正規化に置き換えるだけで、生成される画像の品質が飛躍的に向上し、さらに学習速度も高速化することが確認されています。
これにより、スマホ上でのリアルタイムなフィルタリング処理などが可能になりました。
GAN(敵対的生成ネットワーク)
実在しない人物の顔を生成するなどで有名なGANにおいても、インスタンス正規化は多用されます。
特に「CycleGAN」のように、あるドメインの画像を別のドメインに変換(例:馬をシマウマに変換)するモデルでは、標準的な構成要素となっています。
変換プロセスにおいて元の画像の特徴を維持しつつ、ターゲットとなるスタイルを自然に合成するために、インスタンス正規化の性質が最適だからです。
適応的インスタンス正規化(AdaIN)への発展
インスタンス正規化から派生した「Adaptive Instance Normalization (AdaIN)」は、さらに高度な技術です。
AdaINは、コンテンツ画像から計算された統計量を、スタイル画像から抽出した統計量に動的に置き換える手法です。
これにより、任意の画像スタイルを別の画像へ瞬時に転送することが可能になりました。
この技術は、現在のStable Diffusionなどの拡散モデルや、高品質な画像生成AIの基礎的なアイディアにも繋がっています。
実装のイメージ
実際にプログラム上でインスタンス正規化がどのように扱われるのか、PyTorchを例に見てみましょう。
多くのフレームワークでは、標準ライブラリとして提供されており、非常に簡単に利用できます。
import torch
import torch.nn as nn

# インスタンス正規化の定義
# num_featuresには入力のチャネル数を指定します
instance_norm = nn.InstanceNorm2d(num_features=64)

# ダミーデータの作成 (バッチサイズ, チャネル, 高さ, 幅)
input_data = torch.randn(4, 64, 128, 128)

# 正規化の実行
output_data = instance_norm(input_data)

print(f"入力サイズ: {input_data.shape}")
print(f"出力サイズ: {output_data.shape}")入力サイズ: torch.Size([4, 64, 128, 128])
出力サイズ: torch.Size([4, 64, 128, 128])このように、コードレベルでは通常のバッチ正規化とほぼ同じ感覚で記述することができます。
モデルの設計思想に応じて、nn.BatchNorm2dをnn.InstanceNorm2dに差し替えるだけで、その特性を試すことが可能です。
インスタンス正規化の課題と注意点
非常に便利なインスタンス正規化ですが、どのようなケースでも万能というわけではありません。
いくつかの課題や注意点も存在します。
識別タスクには不向きな場合がある
インスタンス正規化はスタイル情報を消去する性質があるため、画像分類(Recognition)のようなタスクでは、逆効果になることがあります。
例えば、特定の色やコントラストが分類の重要なヒントになる場合、それらを正規化で消してしまうと精度が下がってしまいます。
そのため、ResNetなどの一般的な分類モデルでは、依然としてバッチ正規化が主流です。
計算コストの考慮
インスタンス正規化はサンプルごとに統計量を計算するため、実装によってはバッチ正規化よりも計算ステップが増える場合があります。
現代のGPU環境では大きな差にはなりにくいですが、極めて高速な推論が求められるエッジデバイスなどでは検討材料になります。
まとめ
インスタンス正規化は、各サンプルのチャネルごとに独立して正規化を行うことで、画像からスタイル情報を分離し、コンテンツを際立たせる手法です。
バッチ正規化が「集団の統計」を重視するのに対し、インスタンス正規化は「個別のデータの個性」を扱うという違いがあります。
この特性により、スタイル変換やGAN、最新の画像生成AIにおいて、なくてはならない技術としての地位を確立しました。
バッチサイズに依存せず学習を安定させられる点は、計算リソースが限られる開発者にとっても大きな魅力です。
今後も画像生成AIの進化とともに、インスタンス正規化やその派生技術であるAdaINなどの重要性はますます高まっていくでしょう。
ディープラーニングの実装に取り組む際は、タスクの目的に応じて最適な正規化手法を選択することが、モデルの性能を最大限に引き出す鍵となります。