大規模言語モデル(LLM)の急速な発展に伴い、AIが私たちの日常生活やビジネスにおいて身近な存在となりました。
しかし、膨大なテキストデータを学習しただけのモデルは、必ずしもユーザーの「問いかけ」に対して適切な「回答」を返せるわけではありません。
このギャップを埋め、AIを実用的なアシスタントへと進化させる重要な工程が「インストラクションチューニング」です。
本記事では、インストラクションチューニングの定義から、その仕組み、学習データの重要性までを詳しく解説します。
インストラクションチューニングとは何か
インストラクションチューニングとは、大規模言語モデルがユーザーの指示(インストラクション)を正しく理解し、適切な形式で実行できるように微調整するプロセスのことです。
一般的に、LLMの学習プロセスは「事前学習」と「ファインチューニング」の二段階に大きく分けられます。
事前学習のみを終えたモデルは、次の単語を予測する能力には長けていますが、特定のタスクをこなす「対話相手」としては不十分な場合があります。
例えば「富士山の高さは?」と尋ねた際、事前学習モデルは「富士山の高さは3776メートルです」と答えるのではなく、「富士山の高さに関するクイズ」という続きの文章を生成してしまうことがあります。
このような振る舞いを修正し、人間の意図に沿った回答を出力できるように訓練することが、インストラクションチューニングの主目的です。
事前学習モデルと命令追従型モデルの違い
事前学習モデルは、インターネット上の膨大なテキストを読み込み、言語の構造や知識を蓄積した状態にあります。
一方で、インストラクションチューニングを経たモデルは、その知識をどのように「出力」すべきかのマナーを習得しています。
この工程を経ることで、モデルは「要約してください」「プログラムを書いてください」「翻訳してください」といった具体的な命令に対して、的確に反応できるようになります。
現在、ChatGPTやClaudeなどの対話型AIが非常に自然な受け答えを維持できているのは、このチューニングが高度に行われているためです。
インストラクションチューニングの仕組み
インストラクションチューニングは、技術的には「教師ありファインチューニング(SFT: Supervised Fine-Tuning)」の一種に分類されます。
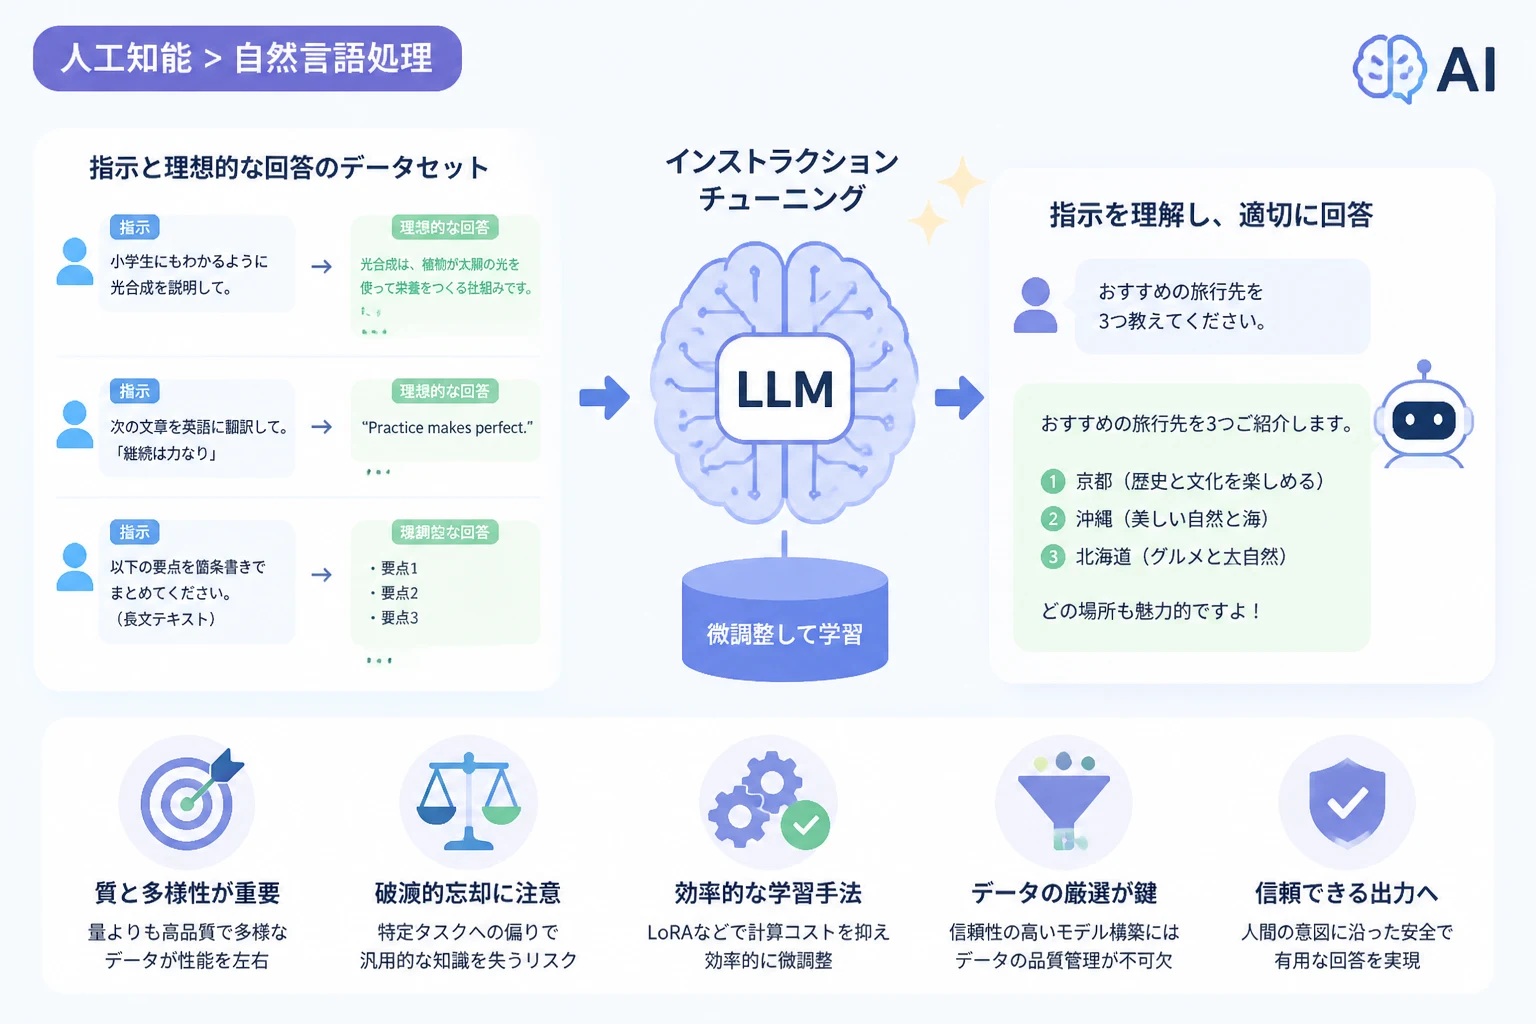
このプロセスでは、「指示(Input)」と「理想的な回答(Output)」のペアで構成されたデータセットをモデルに学習させます。
学習を通じて、モデルは特定の入力パターンに対してどのようなトーンや形式で答えるべきかをパターン認識として学習していきます。
学習データの構造
インストラクションチューニングで使用されるデータは、通常、以下の3つの要素で構成されます。
- 指示(Instruction):ユーザーがモデルに対して何をさせたいかを記述したテキスト。
- 入力(Input):指示を補足する具体的な文脈やデータ(任意)。
- 回答(Response):モデルが生成すべき正解となるテキスト。
例えば、「次の文章を要約してください」という指示に対し、対象となる長い文章を入力として与え、簡潔なまとめを回答として提示します。
このようなペアを数千から数万件学習させることで、モデルは未知の指示に対しても応用力を発揮するようになります。
評価と損失関数の最小化
モデルが生成した回答と、データセット内の正解回答を比較し、その差異(損失)を計算します。
この差異が最小になるようにモデル内のパラメータを更新していくことで、次第に人間が望む回答に近い出力を生成できるようになります。
この段階では、単なる知識の丸暗記ではなく、「指示の構造」を理解させることが重要視されます。
学習データの質と重要性
インストラクションチューニングにおいて、最も重要な要素は「データの量」ではなく「データの質」であると言われています。
低品質なデータ、例えば事実誤認が含まれる回答や、論理的に破綻したデータを大量に学習させると、モデルの性能はかえって低下してしまいます。
LIMAの衝撃:データの質に関する研究
AI研究の分野では「LIMA(Less Is More for Alignment)」と呼ばれる画期的な研究成果が発表されました。
この研究では、わずか1,000件程度の非常に高品質なデータを用いてチューニングするだけで、数万件のデータを用いたモデルに匹敵する性能が得られることが示されました。
この結果から、「質の高い多様なデータ」を厳選することが、優れたAIモデルを作る近道であることが広く認識されるようになりました。
データの多様性がもたらす効果
データセットには、多種多様なタスクを含める必要があります。
| タスクの種類 | 具体例 |
|---|---|
| クリエイティブ作成 | 詩の執筆、物語の構成、キャッチコピー案の作成 |
| 論理的推論 | 数学の文章題、論理パズル、コードのデバッグ |
| 情報抽出・変換 | 文章の要約、構造化データ(JSON等)への変換、翻訳 |
| 安全性・倫理 | 不適切な質問に対する拒絶回答、バイアスの回避 |
これらのバリエーションを網羅することで、モデルは特定の領域に偏ることなく、汎用的な「指示追従能力」を獲得します。
インストラクションチューニングの手法と技術
インストラクションチューニングを効率的に行うための技術も、日々進化しています。
巨大なモデルの全パラメータを更新するには膨大な計算リソースが必要となるため、現在では「効率的なパラメータ学習(PEFT)」が主流となっています。
LoRA(Low-Rank Adaptation)の活用
LoRAは、モデルの全パラメータを更新する代わりに、低ランクの行列を挿入して一部のみを学習させる手法です。
この手法を用いることで、計算コストとメモリ消費を大幅に抑えつつ、フルチューニングに近い性能を実現できます。
個人の開発者や中小企業が独自のインストラクションチューニングを行う際にも、LoRAは非常に有力な選択肢となります。
RLHFへの架け橋
インストラクションチューニング(SFT)は、その後の工程である「人間のフィードバックによる強化学習(RLHF)」の土台となります。
まずSFTによって基本的な指示追従ができるようになったモデルに対し、RLHFでさらに「人間にとって好ましい回答」を選択するよう磨きをかけていきます。
したがって、SFTの精度がモデルの最終的な品質を決定づけると言っても過言ではありません。
インストラクションチューニングの課題と注意点
強力な手法である一方で、インストラクションチューニングにはいくつかの注意点や副作用も存在します。
破滅的忘却(Catastrophic Forgetting)
特定の指示に従うように強く学習させすぎると、モデルが事前学習で得た汎用的な知識や能力を失ってしまうことがあります。
例えば、要約タスクばかりを学習させた結果、自由な創作活動ができなくなってしまうといった現象です。
これを防ぐためには、事前学習データの一部を混ぜて学習させたり、学習率を慎重に調整したりする工夫が求められます。
ハルシネーション(もっともらしい嘘)
インストラクションチューニングは、モデルに「何が何でも回答を生成しようとする姿勢」を植え付けてしまう側面があります。
その結果、知らないことに対しても「知りません」と言えず、自信満々に嘘をついてしまう「ハルシネーション」が発生しやすくなる場合があります。
「分からない場合には正直に回答を避ける」というパターンの学習データを含めることが、信頼性の高いモデル構築には不可欠です。
データセットのバイアス
学習データを作成する人間に偏見やバイアスがある場合、モデルもそれを継承してしまいます。
特定の文化や価値観に偏った回答を避けるためには、データ作成チームの多様性を確保し、厳格なガイドラインに基づいたデータ収集を行う必要があります。
開発における実践的なアプローチ
実際にインストラクションチューニングを行う場合、どのようなステップを踏むべきでしょうか。
現在では、多くのオープンソースライブラリやツールが登場しており、以前よりも格段にハードルが下がっています。
主要なフレームワーク
Hugging Faceの「TRL (Transformer Reinforcement Learning)」や「LLaMA-Factory」といったツールが広く使われています。
これらのフレームワークを活用することで、複雑な学習パイプラインを簡略化し、効率的にチューニングを実行できます。
独自のデータセット構築
特定の業務特化型AIを作る場合、社内のドキュメントやマニュアルを基に独自のインストラクションペアを作成します。
例えば、顧客対応の履歴から「問い合わせ内容」と「模範回答」を抽出して学習データに変換する手法が有効です。
これにより、一般的なAIでは不可能な、「自社独自のルール」に基づいた回答生成が可能になります。
# 学習用データのサンプル形式(JSONL形式が一般的)
[
  {
    "instruction": "次の用語の意味を初心者に分かりやすく説明してください。",
    "input": "インストラクションチューニング",
    "output": "インストラクションチューニングとは、AIが人間の命令を理解して、正しい形式で答えられるように練習させることです。たとえば、『料理の作り方を教えて』と言われたときに、ただ料理の名前を出すのではなく、具体的な手順を答えられるように教育するようなものです。"
  }
]
このような形式のデータを蓄積していくことが、高品質なモデル作成の第一歩となります。
まとめ
インストラクションチューニングは、LLMを「知的な辞書」から「有能なパートナー」へと変貌させるための不可欠なプロセスです。
人間の指示を理解し、文脈に応じた適切な回答を導き出す能力は、この微調整によってもたらされます。
この技術の核心は、単に計算パワーを投入することではなく、高品質で多様な学習データをいかに揃えるかという点にあります。
今後は、より効率的で、かつ副作用の少ないチューニング手法がさらに開発されていくことが期待されています。
また、企業が自社専用のAIを開発する際にも、インストラクションチューニングの理解は強力な武器となるでしょう。
データの質にこだわり、適切な手法を選択することで、私たちはAIの真の可能性を引き出し、より高度な知的作業の自動化を実現できるはずです。