現代のIT社会において、AI(人工知能)や自然言語処理のニュースを目にしない日はありません。
特にChatGPTに代表される大規模言語モデル(LLM)の急速な発展により、コンピュータが人間の言葉を理解する仕組みに注目が集まっています。
こうした技術の根幹を支えている非常に重要な要素の一つが「コーパス」です。
コーパスは、単なるテキストデータの集まりではなく、言語学や情報処理において不可欠な学術的・技術的な価値を持つ基盤です。
本記事では、コーパスの基本的な意味から、その種類、そして最新の自然言語処理においてどのような役割を果たしているのかを詳しく解説します。
コーパスとは何か
コーパス(Corpus)とは、言語学の研究や自然言語処理のために、実際に使われている言葉を大量に集めて構造化したデータセットを指します。
ラテン語で「体」や「集積」を意味する語源を持っており、日本語では「言語表現の集積」と訳されることもあります。
単にランダムな文章を詰め込んだだけではなく、検索や分析がしやすいように一定の規則に基づいて整理されていることが大きな特徴です。
言葉の定義と基本的な概念
学術的な定義におけるコーパスは、書き言葉や話し言葉をデジタル化し、品詞などの情報を付与したものを指します。
以前は紙ベースの資料が中心でしたが、現在ではコンピュータで高速に処理できるデジタルデータとしての形式が一般的です。
コーパスを構成するデータには、小説、新聞記事、ウェブサイトのテキスト、議事録、さらには日常会話の書き起こしなどが含まれます。
これらのデータは、その言語が実際にどのように使われているかを統計的に把握するための「標本」としての役割を担っています。
辞書や百科事典との違い
コーパスと混同されやすいものに「辞書」や「百科事典」がありますが、その目的は大きく異なります。
辞書は、単語の意味や読み方、正しい使い方を定義することを目的とした「正解集」のような存在です。
一方でコーパスは、言葉が実際にどのように使われているかという「実態」を記録したものです。
例えば、ある単語が流行語として誤った意味で広まっている場合、辞書にはまだ載っていなくても、コーパスにはその使用例が大量に蓄積されます。
言語学者はコーパスを分析することで、時代の変遷とともに変化する言葉の使われ方を客観的に観測できるのです。
コーパスの種類
コーパスには、その収集方法や用途、付与されている情報の種類によっていくつかの分類があります。
目的に応じた適切なコーパスを選択することが、自然言語処理の精度を左右する重要なポイントとなります。
言語による分類
一つ目の分類は、含まれる言語の種類によるものです。
単一の言語のみで構成されるものは「単一言語コーパス(Monolingual Corpus)」と呼ばれます。
これに対し、二つ以上の言語を対照させたものは「多言語コーパス(Multilingual Corpus)」と呼ばれます。
特に、ある言語の文章とその翻訳文が1対1で対応するように並べられたものは「パラレルコーパス(対訳コーパス)」と呼ばれ、機械翻訳の学習に欠かせません。
内容や用途による分類
二つ目の分類は、収録されている内容の専門性によるものです。
特定のジャンルに偏らず、言語全体をバランスよく網羅しようとするものは「均衡コーパス」と呼ばれます。
一方で、医療、法律、ITといった特定の専門分野に特化したものは「専門領域コーパス」と呼ばれます。
特定の目的、例えば「子供の言葉の発達」や「外国語学習者の誤用」だけを集めた学習者コーパスなども存在します。
アノテーションの有無による分類
三つ目の分類は、データに付随する情報の有無です。
収集したままの生のテキストデータは「生コーパス(Raw Corpus)」と呼ばれます。
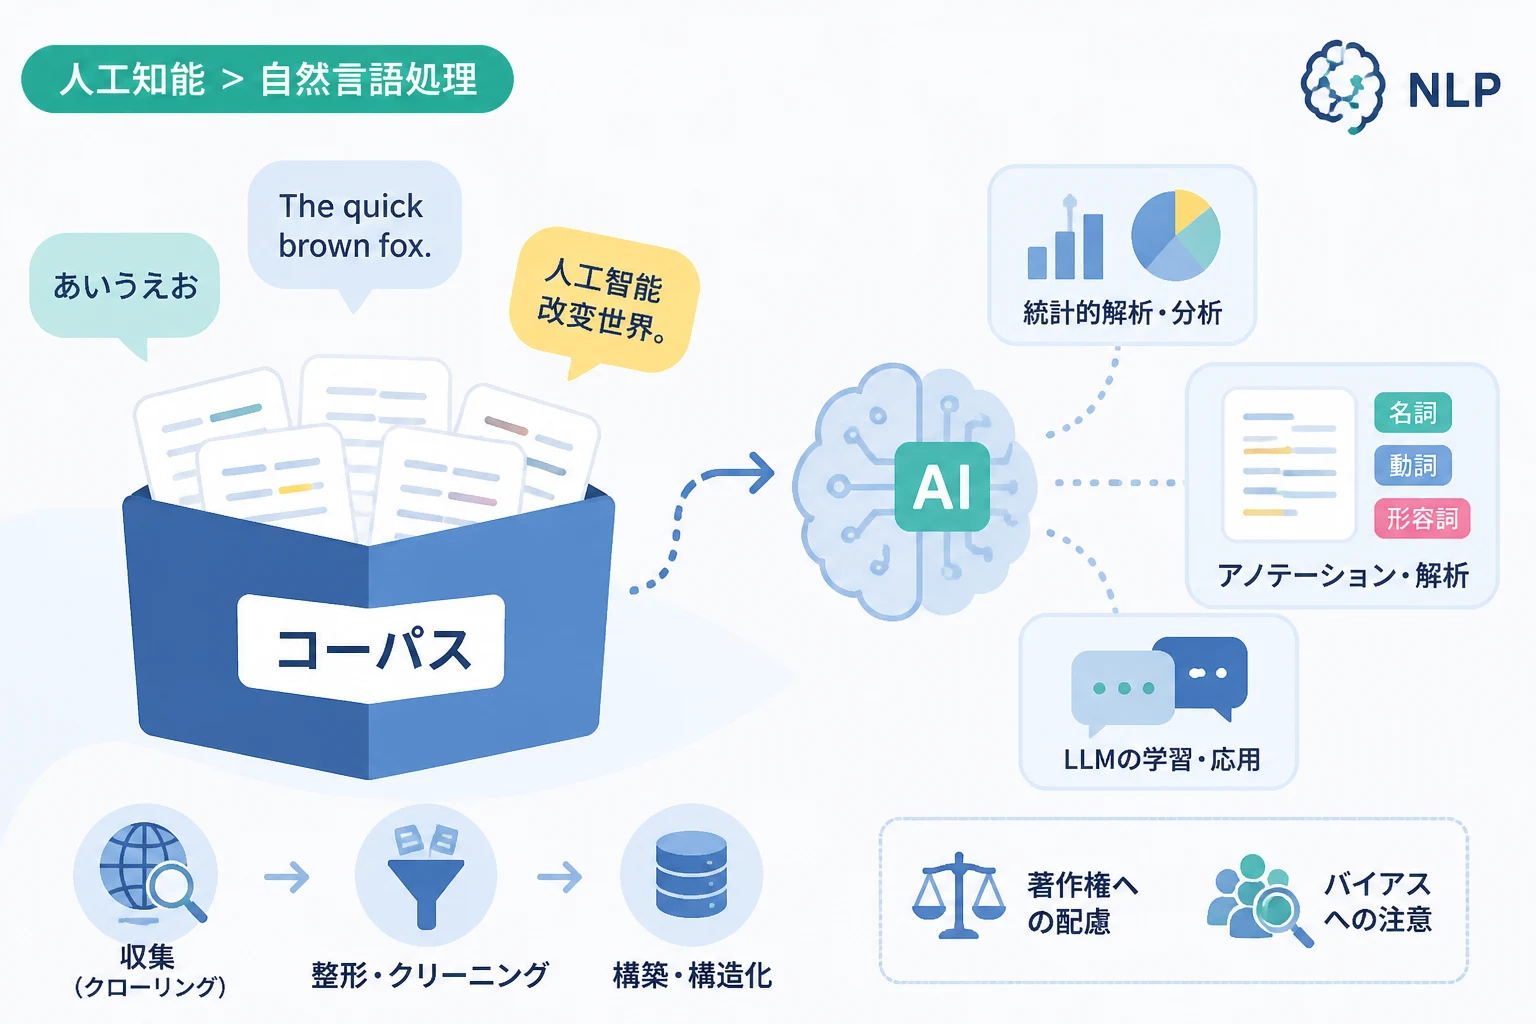
これに対し、各単語に品詞名、構文構造、意味的なカテゴリなどのメタ情報を付与したものを「アノテーション済みコーパス」と呼びます。
アノテーション(タグ付け)が行われていることで、コンピュータは「これは名詞である」「これは主語である」といった情報を正確に処理できるようになります。
| 分類軸 | 種類 | 特徴 |
|---|---|---|
| 言語構成 | パラレルコーパス | 原文と訳文が対になっており、機械翻訳に必須。 |
| 内容の幅 | 均衡コーパス | ジャンルの偏りなく、言語の全体像を把握できる。 |
| データの加工 | アノテーション済みコーパス | 品詞や構文などのメタ情報が付与されている。 |
自然言語処理におけるコーパスの役割
自然言語処理(NLP)の分野において、コーパスは「知能を育てるための教科書」と言える存在です。
コンピュータは人間のように経験から言葉を学ぶことができないため、膨大なコーパスを読み込ませることで言語のパターンを学習します。
機械学習・ディープラーニングの学習データ
現在の主流であるディープラーニングを用いたAIモデルは、学習のために天文学的な量のテキストデータを必要とします。
例えば、GPT-4などのモデルは、インターネット上の膨大なウェブサイトや書籍から構成される巨大なコーパスを学習に使用しています。
コーパスの中に含まれる単語の並び順や出現頻度を確率的に計算することで、AIは「次に続くもっともらしい言葉」を予測できるようになります。
統計的な言語解析
コーパスを利用することで、特定の単語がどのような文脈で使われやすいかを統計的に算出できます。
例えば「お茶」という言葉の近くには「飲む」「淹れる」「温かい」といった言葉が出現しやすいという傾向を数値化できます。
これを「共起表現(Collocation)」と呼び、検索エンジンの予測変換や変換精度の向上に役立てられています。
評価指標としての役割
開発したAIモデルがどれほど正確に言葉を理解できているかを測定するためにも、コーパスが使われます。
「テスト用コーパス」としてあらかじめ正解を用意しておき、AIの出力と照らし合わせることで、精度を客観的に評価します。
高い精度を持つAIを作るためには、学習用のコーパスだけでなく、評価用の高品質なコーパスを準備することも不可欠です。
コーパスの構築プロセス
質の高いコーパスを作るには、単に文字を集めるだけでは不十分であり、いくつかの段階を経る必要があります。
このプロセスは「コーパス・ビルディング」と呼ばれ、データエンジニアや言語学者の専門知識が投入されます。
1. 収集(クローリング・スクレイピング)
まずは、対象となるテキストデータを収集します。
ウェブサイトからデータを自動的に取得するクローリング技術が活用されることが多いです。
ただし、品質を担保するために、信頼できるニュースサイトや公的機関の文書、書籍データなどが選別されることもあります。
2. クリーニングと前処理
収集したデータには、HTMLタグや広告、文字化け、重複した文章などの「ノイズ」が多く含まれています。
これらを除去し、テキストを解析しやすい形に整える作業をクリーニングと呼びます。
この段階で、全角・半角の統一や、不要な記号の削除といった正規化処理も行われます。
3. アノテーション(タグ付け)
クリーニングされたテキストに対して、言語的な情報を付与していきます。
日本語の場合は、文を単語ごとに区切る「形態素解析」を行い、それぞれの単語に品詞を割り振ります。
さらに高度なアノテーションでは、代名詞が何を指しているかという参照関係や、文の感情(ポジティブ・ネガティブ)などを人間が手作業で付与することもあります。
# Pythonでの簡単な形態素解析の例(MeCabを使用)
import MeCab

# 形態素解析器の初期化
tagger = MeCab.Tagger()

# 解析対象のテキスト(コーパスの一部と想定)
text = "コーパスは自然言語処理の基礎です。"

# 解析結果の出力
print(tagger.parse(text))コーパス 名詞,一般,*,*,*,*,コーパス,コーパス,コーパス
は 助詞,係助詞,*,*,*,*,は,ハ,ワ
自然 名詞,形容動詞語幹,*,*,*,*,自然,シゼン,シゼン
言語 名詞,一般,*,*,*,*,言語,ゲンゴ,ゲンゴ
処理 名詞,サ変接続,*,*,*,*,処理,ショリ,ショリ
の 助詞,連体化,*,*,*,*,の,ノ,ノ
基礎 名詞,一般,*,*,*,*,基礎,キソ,キソ
です 助動詞,*,*,*,特殊・デス,基本形,です,デス,デス
。 記号,句点,*,*,*,*,。,。,。
EOS代表的なコーパスの例
世界中で様々なコーパスが公開されており、研究や開発に利用されています。
ここでは、特に有名なものをいくつか紹介します。
日本語の代表的なコーパス
日本語の研究において最も権威があるものの一つが、国立国語研究所が公開している「現代日本語書き言葉均衡コーパス(BCCWJ)」です。
書籍、雑誌、新聞、白書、ブログなど、幅広いジャンルから約1億語を収録しており、現代日本語のスタンダードな実態を知るために広く使われています。
また、日常会話を収録した「日本語話し言葉コーパス(CSJ)」なども、音声認識技術の向上に大きく貢献しています。
英語・グローバルの代表的なコーパス
英語圏では、歴史の長い「ブラウン・コーパス(Brown Corpus)」や、より大規模な「ブリティッシュ・ナショナル・コーパス(BNC)」が有名です。
最近では、Wikipediaの全記事データを集めたものや、Common Crawl(コモン・クロール)と呼ばれる、インターネット上の膨大なページをアーカイブした巨大なデータセットがLLMの学習に使われています。
コーパス利用時の注意点
コーパスは強力なツールですが、利用にあたっては技術面と法律面の両方で注意すべき点があります。
著作権と利用規約
コーパスに含まれる文章には、当然ながら著作者が存在します。
学術研究目的であれば著作権法による例外規定(第30条の4など)が適用される場合が多いですが、商用利用や再配布には厳格な制約があることが一般的です。
利用する際は、必ず各コーパスのライセンス情報を確認しなければなりません。
データの偏り(バイアス)の問題
コーパスはあくまで「過去に存在した言葉の集積」に過ぎません。
もし収集したデータに特定の偏見や差別的な表現が多く含まれていた場合、それを学習したAIも同様のバイアスを持つようになってしまいます。
これを「アルゴリズム・バイアス」と呼び、倫理的な観点から大きな課題となっています。
「データの質がAIの質を決める」という格言の通り、コーパスの選定には慎重な判断が求められます。
まとめ
コーパスは、私たちが日常的に使っている言葉をコンピュータが扱える形に変換した、いわば「言語のビッグデータ」です。
単なるテキストの集合体ではなく、構造化され、アノテーションが付与されることで、初めて自然言語処理の強力な基盤となります。
機械翻訳の精度向上や、ChatGPTのような高度な対話型AIの誕生も、先人たちが積み上げてきた膨大なコーパスなしには実現し得ませんでした。
今後、AIがより深く人間の意図を汲み取り、自然なコミュニケーションを実現するためには、より高品質で多様なコーパスの構築がますます重要になっていくでしょう。
IT技術に関わる方だけでなく、言葉に関心を持つすべての人にとって、コーパスの概念を理解することは現代のテクノロジーを読み解く大きなヒントとなるはずです。