現代のデジタル社会において、膨大なデータから必要な情報を瞬時に見つけ出す技術は欠かせないものとなっています。
ビッグデータの活用がビジネスの成否を分ける中で、多くの企業が導入を進めているのが、分散型検索・分析エンジンである「Elasticsearch」です。
Elasticsearchは、単なる検索エンジンにとどまらず、ログ解析やセキュリティ監視、リアルタイムのデータ分析など、幅広い用途で活用されています。
本記事では、Elasticsearchの基礎知識から、その独自の仕組み、主要な機能、そして具体的なビジネスシーンでの活用例までを詳しく解説します。
Elasticsearchとは
Elasticsearch(エラスティックサーチ)は、Apache Lucene(アパッチ・ルシーン)という全文検索ライブラリをベースに構築された、オープンソースの分散型検索・分析エンジンです。
オランダに本社を置くElastic社によって開発されており、Javaで記述されているのが特徴です。
大量のデータをほぼリアルタイムで検索・分析できる能力を持っており、数百万件、数億件という大規模なデータセットに対しても極めて高速なレスポンスを返します。
また、ElasticsearchはJSON形式のドキュメントを扱う「ドキュメント指向型」のデータベースとしての側面も持っています。
スキーマレス(データの定義を事前に厳密に決めなくて良い)な性質を持つため、非構造化データや半構造化データも柔軟に取り込むことが可能です。
Webサイトの検索窓の実装から、インフラの監視、ビジネスインテリジェンス(BI)ツールのバックエンドまで、その用途は多岐にわたります。
Elasticsearchの大きな特徴
Elasticsearchがこれほどまでに普及した背景には、従来のデータベースにはない優れた特徴がいくつか存在します。
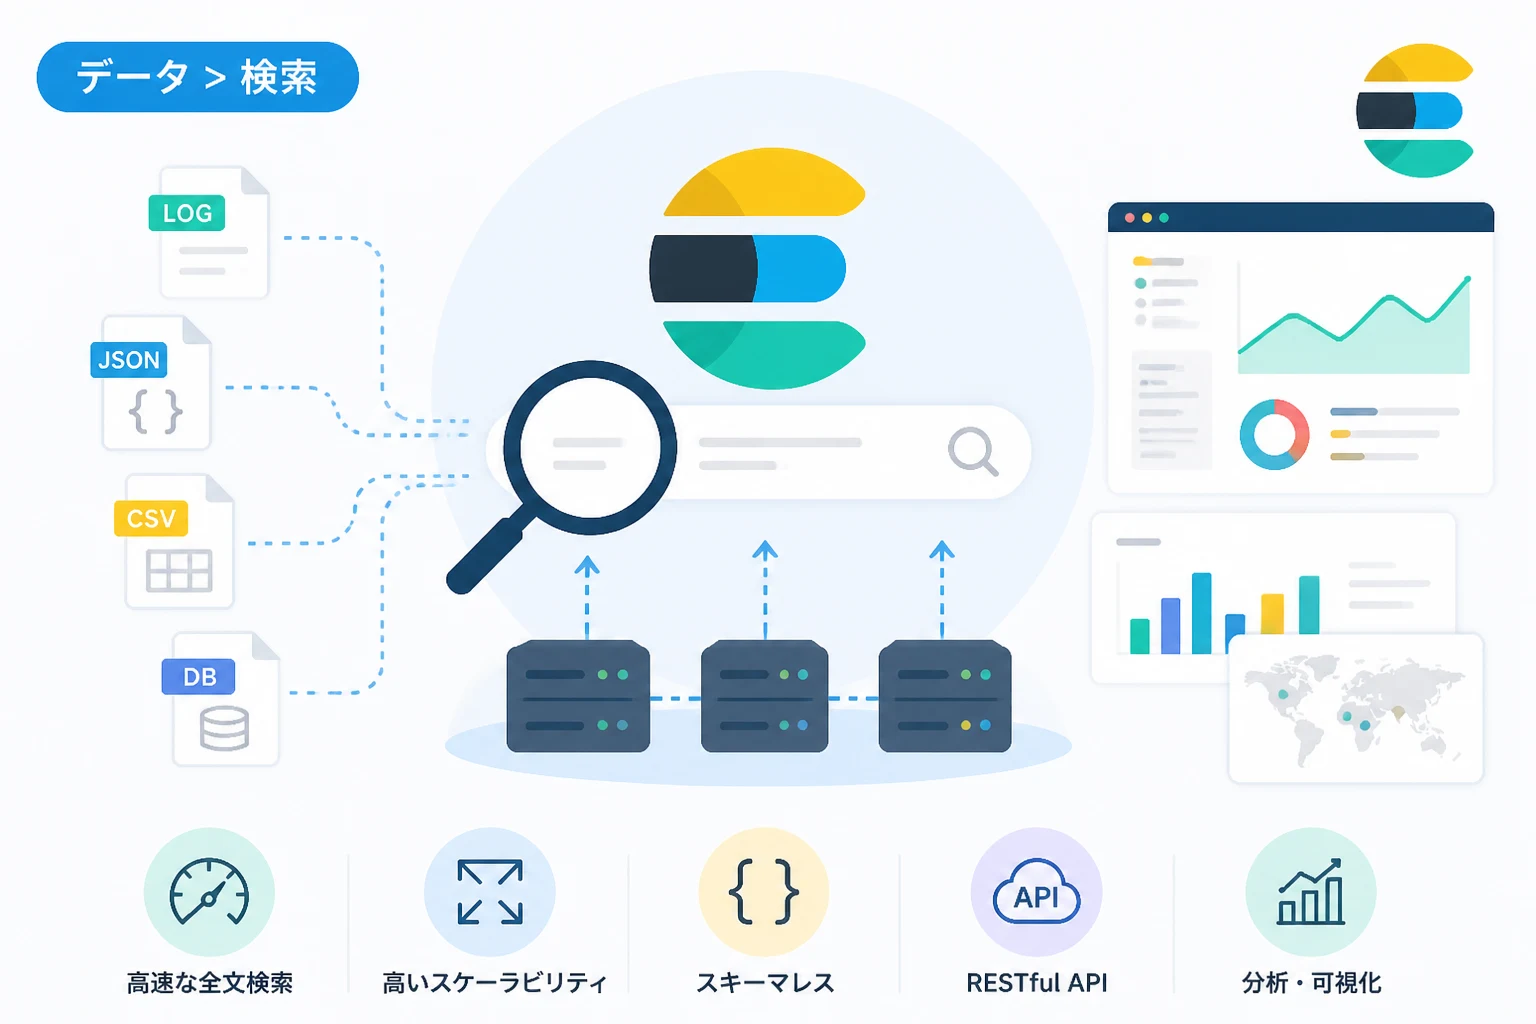
高速な全文検索能力
Elasticsearchの最大の強みは、その圧倒的な検索スピードにあります。
後述する「転置インデックス」という仕組みを用いることで、大量のテキストデータの中から特定のキーワードを含むドキュメントを瞬時に探し出すことができます。
このスピードは、数テラバイト規模のデータに対しても維持されるように設計されています。
優れたスケーラビリティ(拡張性)
Elasticsearchは「分散型」のシステムであり、複数のサーバーを組み合わせて一つの大きなシステム(クラスター)を構成します。
データ量やトラフィックが増加した場合には、サーバーを追加するだけで処理能力を向上させることが可能です。
この水平方向の拡張性(スケールアウト)により、スタートアップから大企業まで規模を問わず利用できます。
RESTful APIによる操作
Elasticsearchは、HTTPプロトコルをベースとしたRESTful APIを提供しています。
データの登録、検索、削除、設定の変更などのあらゆる操作を、標準的なHTTPメソッド(GET, POST, PUT, DELETE)を通じて実行できます。
これにより、Python、Java、JavaScript、Goなど、言語を問わずさまざまなアプリケーションから容易に連携できるのが利点です。
高い可用性と耐障害性
データは複数のノードにコピー(レプリカ)として分散保持されます。
仮に一部のサーバーに障害が発生して停止したとしても、他のノードに保存されたデータを使ってサービスを継続することが可能です。
この仕組みにより、ミッションクリティカルなビジネス環境でも安心して導入することができます。
Elasticsearchを支える仕組み
なぜElasticsearchはこれほどまでに高速で柔軟なのでしょうか。
その理由を理解するために、内部的なデータ保持の仕組みと構造について見ていきましょう。
転置インデックス(Inverted Index)
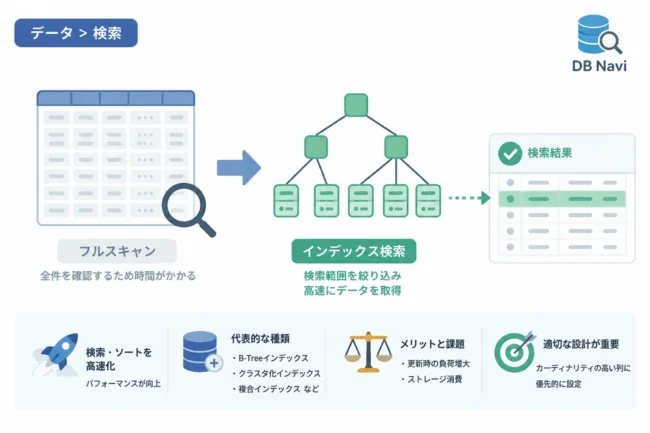
全文検索の高速化を実現している中核技術が「転置インデックス」です。
通常、本を最初から最後まで読んで特定の単語を探すのは時間がかかりますが、巻末の「索引(インデックス)」を使えばすぐに該当ページが見つかります。
転置インデックスは、まさにこの「索引」をデータ構造として持っているものです。
具体的には、「どの単語がどのドキュメントのどこに含まれているか」というリストをあらかじめ作成しておきます。
検索時にはこのリストを参照するだけで済むため、ドキュメント全体をスキャンする必要がなく、極めて高速な検索が可能になります。
ドキュメントとインデックスの構造
Elasticsearchのデータ構造は、一般的なリレーショナルデータベース(RDBMS)とは異なります。
各データの最小単位は「ドキュメント」と呼ばれ、JSON形式で表現されます。
そして、類似したドキュメントを集めた器を「インデックス」と呼びます。
RDBMSとの対応関係を簡略化すると以下のようになります。
| Elasticsearchの用語 | RDBMSでの概念 | 説明 |
|---|---|---|
| インデックス (Index) | データベース (Database) | ドキュメントの論理的な集まり |
| ドキュメント (Document) | 行 (Row) | 保存される1件のデータ(JSON形式) |
| フィールド (Field) | 列 (Column) | ドキュメントに含まれる個々の項目 |
| マッピング (Mapping) | スキーマ (Schema) | データの型や検索方法の定義 |
シャードとレプリカ
インデックスは、内部的に「シャード」と呼ばれる単位に分割されて複数のノードに分散配置されます。
これにより、一つの巨大なインデックスを複数のサーバーで並列に処理できるようになります。
また、シャードのコピーである「レプリカ」を作成することで、データの冗長性を確保しています。
Elastic Stack(ELK Stack)としての活用
Elasticsearchは単体でも強力ですが、周辺ツールと組み合わせることでさらに真価を発揮します。
これらは以前まで「ELK Stack」と呼ばれており、現在は「Elastic Stack」という名称で統合的に提供されています。
Kibana(キバナ)
Kibanaは、Elasticsearchに蓄積されたデータを可視化するためのダッシュボードツールです。
棒グラフ、円グラフ、マップ、タイムラインなど、多彩なチャートをブラウザ上で簡単に作成できます。
データの傾向をリアルタイムで監視したり、異常値を視覚的に検知したりする際に不可欠な存在です。
Logstash(ログスタッシュ)
Logstashは、さまざまなソースからデータを取り込み、加工・変換してElasticsearchなどの出力先に送信するデータパイプラインツールです。
サーバーログ、アプリケーションログ、データベースのレコードなど、形式がバラバラなデータを整形してElasticsearchに流し込む役割を担います。
Beats(ビーツ)
Beatsは、軽量なデータシッパー(転送機)群です。
サーバーやコンテナにインストールし、ログやメトリクスを直接ElasticsearchやLogstashへ送信します。
リソース消費が非常に少ないため、大量のサーバーを監視するエージェントとして広く利用されています。
Elasticsearchの具体的な活用シーン
実際にElasticsearchがどのような場面で利用されているのか、代表的な例を紹介します。
Webサイト・ECサイト内検索
最も一般的な用途は、サイト内の検索機能です。
ユーザーが入力したキーワードに対して、高速かつ関連度の高い順(スコアリング順)に結果を表示します。
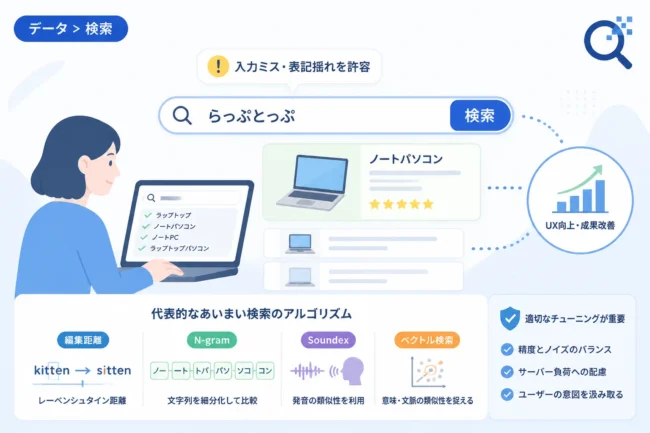
また、オートコンプリート(入力補完)や「もしかして(スペル修正)」などの高度な検索体験も提供できます。
ログ管理とトラブルシューティング
システムの稼働ログやエラーログを一箇所に集約し、リアルタイムに分析します。
エラーが発生した際に、どのサーバーで、いつ、どのようなメッセージが出力されたのかをミリ秒単位で検索できるため、障害復旧までの時間を劇的に短縮できます。
SIEM(セキュリティ情報イベント管理)
ネットワーク機器やOSのセキュリティログを監視し、サイバー攻撃の予兆や不正アクセスを検知する基盤として利用されます。
膨大な通信記録の中から特定のパターンを見つけ出す作業に、Elasticsearchの高速検索が非常に適しています。
ビジネス分析(BI)
売上データ、SNSの投稿、IoTデバイスのセンサーデータなどをリアルタイムに集計・分析します。
現在の売上推移やユーザーの行動を即座にダッシュボードに反映させることで、迅速な意思決定を支援します。
RDBMSとの使い分けについて
Elasticsearchは非常に多機能ですが、すべてのケースにおいてMySQLやPostgreSQLのようなRDBMSを置き換えるものではありません。
RDBMSは「厳密な一貫性」や「トランザクション管理」に優れており、銀行の残高管理や注文処理などの「正確さが絶対条件の処理」に向いています。
対してElasticsearchは、「大量データの高速検索」や「柔軟なデータ構造の維持」に特化しています。
そのため、マスターデータはRDBMSで管理し、検索用データをElasticsearchに同期させるという構成が一般的によく取られます。
Elasticsearchのクエリ例
Elasticsearchでの操作をイメージしていただくために、基本的なクエリの例を紹介します。
Elasticsearchでは、Query DSLと呼ばれるJSONベースのクエリ言語を使用します。
以下の例は、productsというインデックスから、商品名に「PC」が含まれ、かつ価格が100,000円以下の商品を検索するクエリです。
GET /products/_search
{
  "query": {
    "bool": {
      "must": [
        { "match": { "name": "PC" } }
      ],
      "filter": [
        { "range": { "price": { "lte": 100000 } } }
      ]
    }
  }
}
このリクエストを送信すると、Elasticsearchは以下のような結果を返します。
{
  "took": 5,
  "timed_out": false,
  "hits": {
    "total": { "value": 1, "relation": "eq" },
    "max_score": 1.2,
    "hits": [
      {
        "_index": "products",
        "_id": "101",
        "_score": 1.2,
        "_source": {
          "name": "High-spec Laptop PC",
          "price": 98000,
          "category": "Electronics"
        }
      }
    ]
  }
}
このように、直感的なJSON形式で複雑な検索条件を記述できるのが特徴です。
まとめ
Elasticsearchは、その圧倒的な検索速度とスケーラビリティにより、現代のデータ駆動型ビジネスにおいて不可欠なインフラとなっています。
「転置インデックス」による全文検索の効率化や、JSONによる柔軟なデータ保持、そしてRESTful APIによる開発のしやすさは、エンジニアにとって大きな魅力です。
また、KibanaやLogstashと組み合わせることで、データの収集から可視化までを一貫して行えるエコシステムが整っていることも、広く採用されている理由の一つです。
単なる「検索エンジン」の枠を超え、ログ分析やセキュリティ監視、リアルタイムBIなど、あらゆるシーンでその価値を発揮します。
今後、扱うデータ量がさらに増加していく中で、Elasticsearchの重要性はますます高まっていくことでしょう。
まずは小規模なプロジェクトから導入し、そのスピードと利便性を体感してみることをおすすめします。