現代のコンピューティングにおいて、プロセッサの処理能力向上に負けず劣らず重要なのが、データ伝送を支える「インターコネクト」技術です。
CPUやGPUがいかに高速に演算を行えたとしても、それらを結ぶ道路が渋滞していてはシステム全体の性能を十分に発揮することはできません。
本記事では、PCやサーバーの性能を左右する鍵となるインターコネクトの仕組みから、最新の技術動向までを詳しく解説します。
インターコネクトとは何か
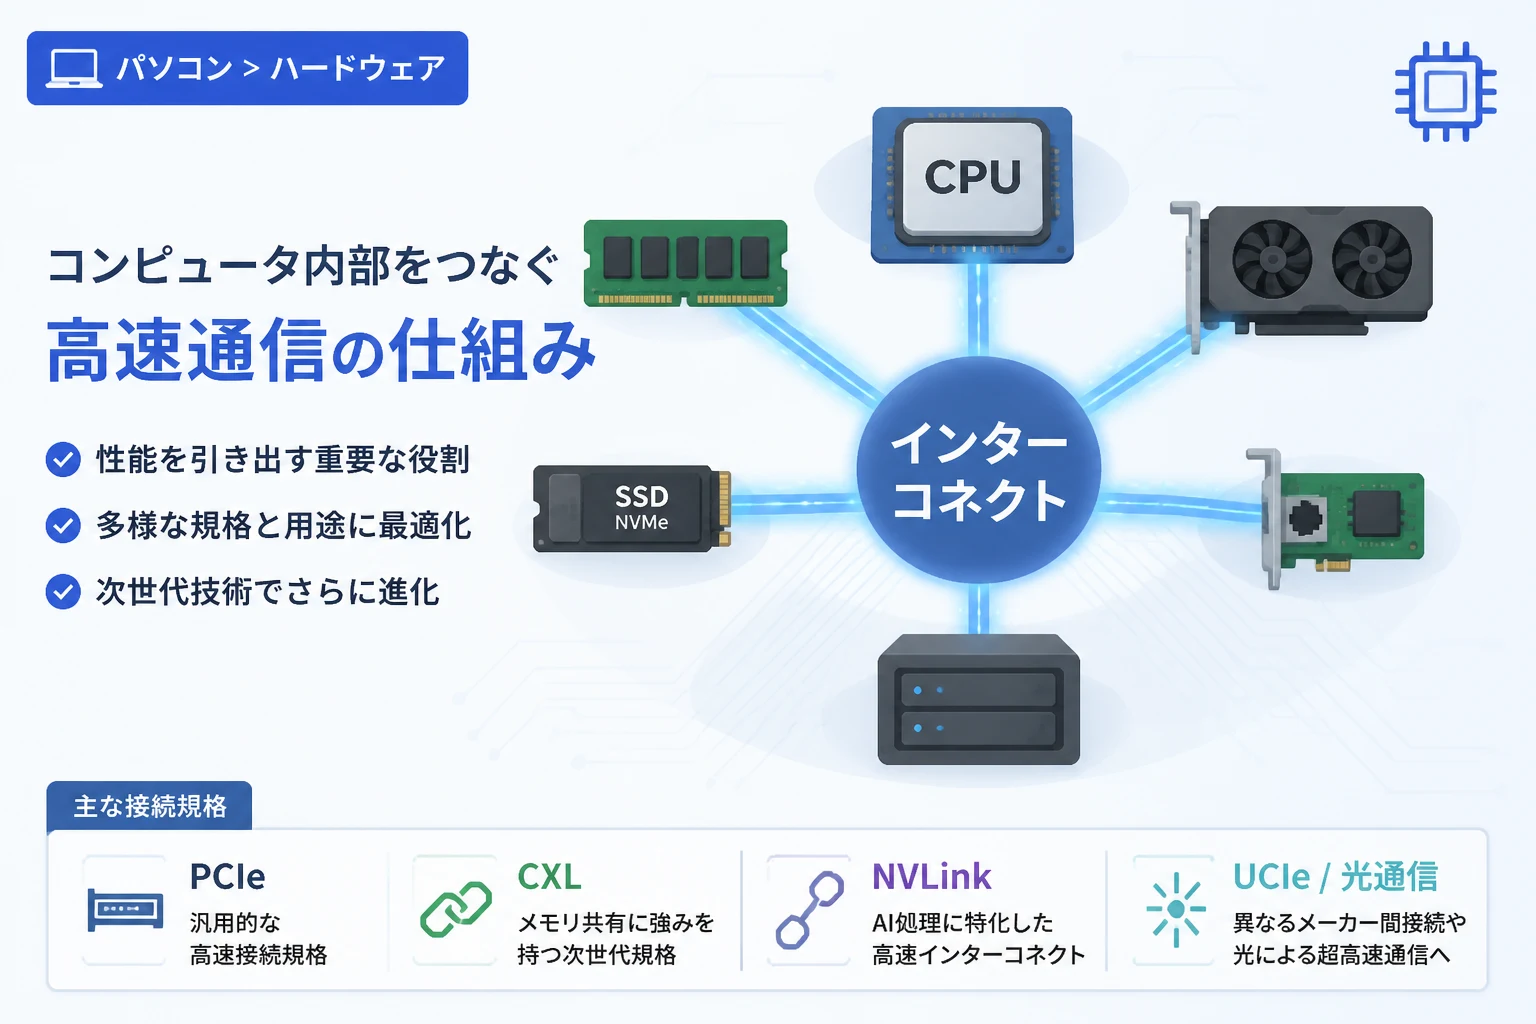
インターコネクトとは、コンピュータ内部の各コンポーネントを接続し、相互にデータをやり取りするための通信経路やその技術の総称です。
具体的には、CPUとメモリ、CPUとGPU、あるいは複数のプロセッサ間を結ぶ高速な物理層とプロトコルを指します。
かつては「バス」という言葉が同様の意味で使われていましたが、現在ではより高度なトポロジーや高速なシリアル伝送を用いたものをインターコネクトと呼ぶのが一般的です。
インターコネクトの役割は、単にデータを運ぶだけでなく、データの一貫性(コヒーレンシ)を維持したり、遅延(レイテンシ)を最小限に抑えたりすることにあります。
特に近年のAI学習やビッグデータ解析では、膨大なデータを複数のプロセッサで並列処理するため、インターコネクトの帯域幅がシステム全体のボトルネックとなることが増えています。
そのため、インターコネクト技術の進化は、次世代のコンピューティング性能を決定づける極めて重要な要素となっています。
バス技術からインターコネクトへの進化
初期のコンピュータでは、複数のデバイスが1本の通信路を共有する「共有バス」方式が採用されていました。
しかし、共有バスでは一度に1つのデバイスしか通信できず、接続台数が増えるほど待ち時間が発生するという欠点がありました。
これに対し、現代のインターコネクトは、デバイス間を1対1で結ぶ「ポイントツーポイント接続」が主流となっています。
これにより、複数のデバイスが同時に独立した通信を行うことが可能になり、スループットが劇的に向上しました。
さらに、パラレル伝送から高速シリアル伝送へと移行したことで、配線の簡素化とノイズの抑制を両立し、さらなる高クロック化を実現しています。
インターコネクトの重要性が高まっている理由
なぜ今、インターコネクトがこれほどまでに注目されているのでしょうか。
その最大の理由は、「フォン・ノイマン・ボトルネック」と呼ばれる、演算速度とデータ転送速度の乖離にあります。
ムーアの法則に従ってプロセッサの演算性能は飛躍的に伸びましたが、メモリやストレージとの間の通信速度はそれほどのスピードで向上してきませんでした。
この速度差を埋めるために、より高速で効率的なインターコネクトが必要とされているのです。
マルチコア化とヘテロジニアス・コンピューティング
現在のCPUは、1つのチップに多数のコアを搭載するマルチコア構成が当たり前となっています。
各コアがメモリにアクセスする際の競合を避け、効率よくデータを分配するためには、チップ内部のインターコネクト性能が不可欠です。
また、GPUや専用アクセラレータを併用する「ヘテロジニアス・コンピューティング」の普及も要因の一つです。
CPUとGPUの間で巨大なデータを頻繁にやり取りする場合、従来の汎用的な接続では速度が足りず、専用の高速インターコネクトが開発されるようになりました。
代表的なインターコネクト規格の種類と特徴
インターコネクトには、用途や接続されるコンポーネントに応じてさまざまな規格が存在します。
ここでは、PCからデータセンターまで幅広く利用されている主要な技術を紹介します。
PCI Express (PCIe)
PCI Expressは、現代のPCにおいて最も一般的で汎用性の高いインターコネクト規格です。
グラフィックボードやNVMe SSDなど、さまざまな拡張デバイスの接続に使用されています。
PCIeは世代を重ねるごとに帯域幅を倍増させており、現在はPCIe 5.0や6.0といった超高速な世代が登場しています。
下位互換性が高く、柔軟な拡張性を持っていることが最大の特徴です。
CXL (Compute Express Link)
CXLは、PCIe 5.0の物理層をベースにしつつ、プロセッサとデバイス間の通信効率を飛躍的に高めた新しいオープン規格です。
特に「メモリ・コヒーレンシ」をサポートしており、CPUとアクセラレータ間でメモリ空間を共有できるのが大きな強みです。
これにより、データのコピー(移動)に伴うオーバーヘッドを削減し、システム全体の効率を最適化できます。
次世代のサーバーやデータセンターにおいて、メモリの拡張や共有を実現する核心技術として期待されています。
NVLink
NVLinkは、NVIDIA社が開発した独自の高速インターコネクト技術です。
主にGPU同士、あるいは特定のCPUとGPUを接続するために使用されます。
PCIeと比較して圧倒的に高い帯域幅と低レイテンシを誇り、大規模なAI学習モデルの構築には欠かせない技術となっています。
複数のGPUを1つの仮想的な巨大GPUとして扱えるようにすることで、HPC(ハイパフォーマンス・コンピューティング)の性能を支えています。
Infinity Fabric
Infinity Fabricは、AMD社が採用しているチップ間・チップ内インターコネクト技術です。
CPUのコア(CCD)間や、CPUとGPU(Radeonシリーズ)の統合的な接続を担います。
AMDの「チップレット・デザイン」を支える基盤技術であり、異なるプロセスルールで製造されたダイを効率よく連携させることが可能です。
モジュール方式による柔軟な製品構成を可能にしたのは、このインターコネクトの功績と言えます。
インターコネクト規格の比較表
| 規格名 | 主な開発元・団体 | 主な用途 | 主な特徴 |
|---|---|---|---|
| PCIe | PCI-SIG | 汎用拡張カード、SSD | 高い汎用性と互換性 |
| CXL | CXL Consortium | サーバー、メモリ共有 | メモリコヒーレンシの実現 |
| NVLink | NVIDIA | GPU間接続、AIサーバー | 超広帯域、独自プロトコル |
| Infinity Fabric | AMD | CPU/GPU内部接続 | チップレット構成の最適化 |
データセンター向けのネットワーク・インターコネクト
1台の筐体(ノード)を超えて、数千台のサーバーを接続する場合、ネットワークレベルのインターコネクトが必要になります。
ここでは、スーパーコンピュータや大規模クラウド基盤で利用される技術を解説します。
InfiniBand
InfiniBandは、超低レイテンシと高スループットを特徴とする、HPC向けの標準的なインターコネクトです。
CPUの負荷を介さずにメモリ間で直接データを転送する「RDMA (Remote Direct Memory Access)」をネイティブでサポートしています。
この技術により、ネットワーク通信に伴うプロセッサのオーバーヘッドを極限まで排除しています。
AIサーバーのクラスタリングにおいては、デファクトスタンダードとしての地位を確立しています。
Ethernet (RoCE)
広く普及しているEthernetをベースに、InfiniBandのようなRDMA機能を追加したのが「RoCE (RDMA over Converged Ethernet)」です。
既存のネットワークインフラを活用しつつ、高速なデータ転送を実現できるため、コストパフォーマンスに優れています。
近年では、400Gbpsや800Gbpsといった超高速なEthernetスイッチが登場しており、InfiniBandの強力な競合となっています。
インターコネクトがもたらすパフォーマンス向上
インターコネクトの性能向上は、ユーザーにとって具体的にどのようなメリットをもたらすのでしょうか。
最も顕著なのは、「アプリケーションの応答速度」と「スケーラビリティ」の向上です。
ゲーミング性能への影響
PCゲームにおいて、PCIeの帯域幅はグラフィック処理のボトルネックを解消します。
特にDirectStorageのような、GPUがストレージから直接データを読み込む技術では、高速なインターコネクトがロード時間の短縮に直結します。
ビデオメモリ(VRAM)が不足した際のシステムメモリへのアクセスも、インターコネクトが速ければパフォーマンスの低下を最小限に抑えられます。
クリエイティブワークとAI処理
4Kや8Kの動画編集、3Dレンダリングでは、膨大なデータをストレージ、メモリ、GPU間で循環させます。
インターコネクトの帯域が広いほど、データの待ち時間が減り、プレビューの滑らかさや書き出し速度が改善されます。
生成AIの分野では、モデルのパラメータをGPUにロードする速度や、推論時のレイテンシにおいて、インターコネクトの品質が作業効率を大きく左右します。
次世代のインターコネクト技術:UCIeと光通信
インターコネクトの進化は止まることがありません。
現在、さらなる高速化を目指した新しい取り組みが進んでいます。
UCIe (Universal Chiplet Interconnect Express)
UCIeは、異なるメーカーのチップレットを同一パッケージ内で接続するためのオープンな標準規格です。
インテル、AMD、Arm、TSMC、サムスンといった主要企業が賛同し、策定が進められています。
これにより、ベンダーの垣根を超えて最適なチップパーツを組み合わせる「チップレット・エコシステム」が実現しようとしています。
設計の自由度が高まるだけでなく、製造コストの抑制と性能の最大化を両立する画期的な技術です。
光インターコネクト (Silicon Photonics)
従来の銅線(電気信号)による伝送は、高速化に伴う信号の減衰や発熱の問題に直面しています。
そこで注目されているのが、シリコン基板上に光学素子を統合する「シリコンフォトニクス」技術です。
電気信号の代わりに光信号を用いることで、低消費電力でありながら、電気を遥かに凌駕する帯域幅と長距離伝送が可能になります。
将来的なデータセンターでは、ラック内の接続まで光通信が浸透し、通信の限界が突破されると予想されています。
インターコネクト選びの注意点
PCを自作したり、サーバーを選定したりする際には、インターコネクトの仕様を確認することが重要です。
例えば、最新のGPUを購入しても、マザーボードのPCIeスロットが旧世代であれば、その性能を100%引き出すことはできません。
また、レーン数(x4, x8, x16など)の制約によって、複数のデバイスを装着した際に帯域が分割されてしまうケースもあります。
高性能なシステムを構築する際は、「どのデバイスが、どの規格で、何レーンで接続されているか」を把握することが、失敗しないパーツ選びのコツです。
まとめ
インターコネクトは、現代のコンピューティングシステムにおける「影の主役」とも言える重要な技術です。
プロセッサの処理能力が限界に近づく中で、システム全体のパフォーマンスを向上させるための鍵は、コンポーネント間のデータ転送効率に集約されています。
PCIeの高速化やCXLの登場、さらには光通信の導入など、インターコネクトは今まさに大きな変革期を迎えています。
AIやビッグデータの活用が当たり前となるこれからの時代、インターコネクトの仕組みを理解しておくことは、最適なIT環境を構築する上で非常に役立つでしょう。
今後も、この「データの通り道」がどのように進化していくのか、その動向に注目が集まります。