ベクトルコンピュータとは、大量のデータを一度に処理することに特化した、科学技術計算向けのコンピュータアーキテクチャの一種です。
私たちが普段使っているパソコンのCPUは、一つひとつのデータを順番に処理する「スカラ演算」を得意としていますが、ベクトルコンピュータは大量の数値データを一括で処理する「ベクトル演算」に最適化されています。
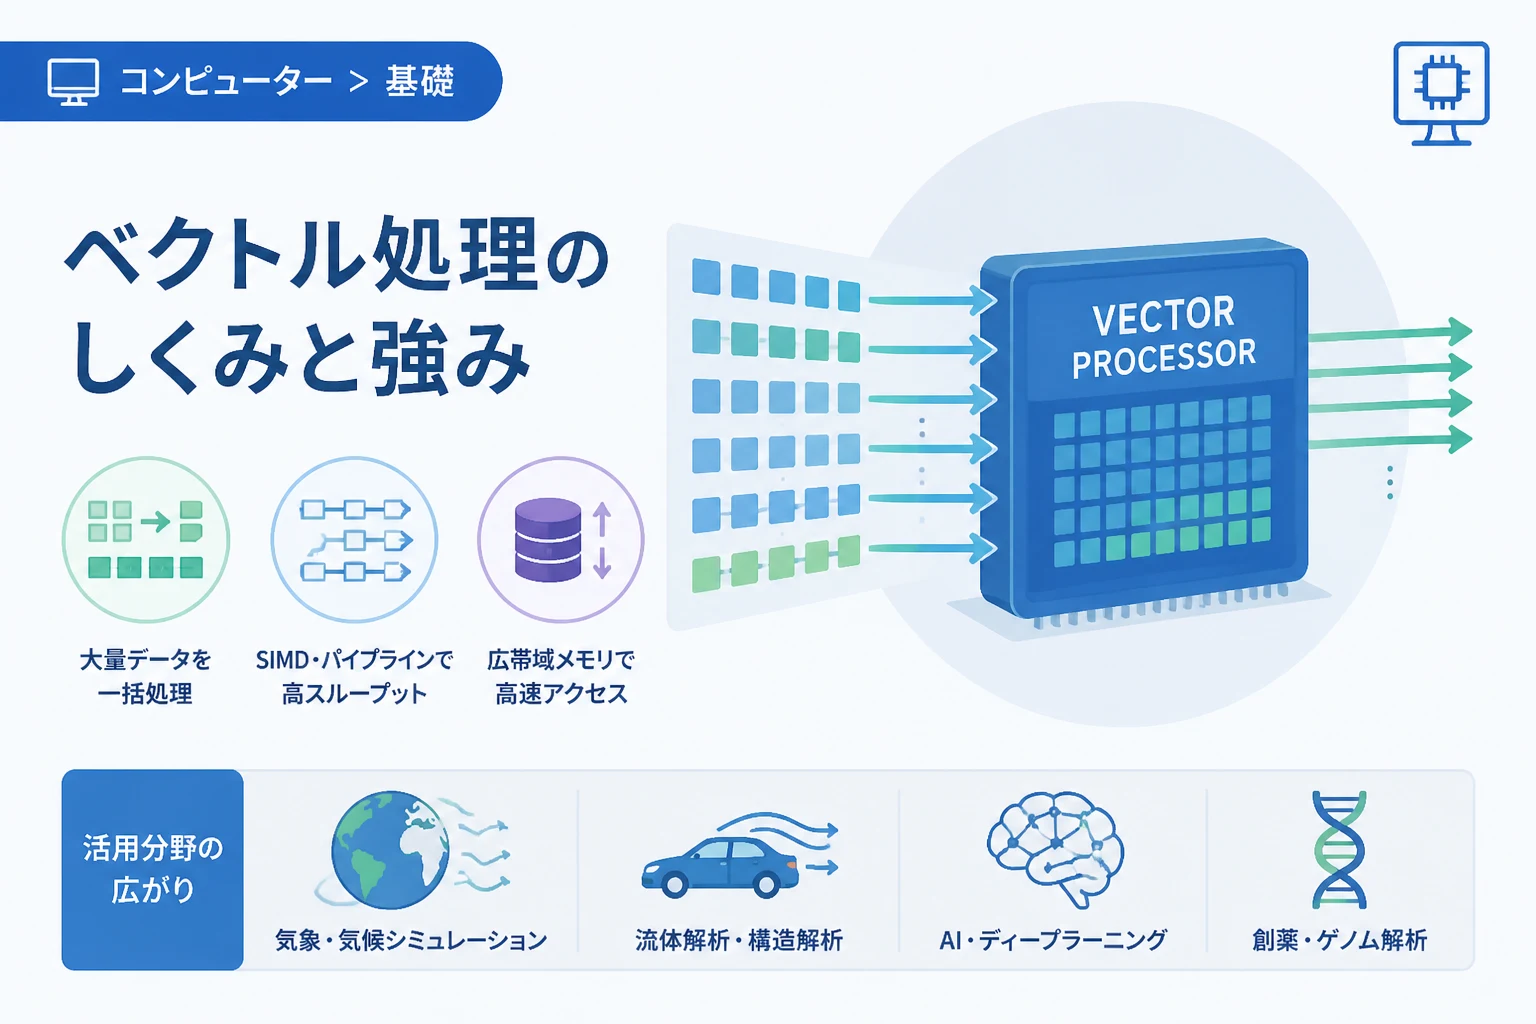
気象予報や流体解析、構造計算といった高度なシミュレーションでは、膨大な配列データに対して同じ操作を繰り返す必要があるため、ベクトルコンピュータの性能が非常に重要視されてきました。
本記事では、ベクトルコンピュータの基本的な仕組みから、最新のスーパーコンピュータでの活用事例、そして現代のAI技術との関連性までを詳しく解説します。
そもそもベクトルコンピュータ(ベクトルプロセッサ)とは何か
ベクトルコンピュータとは、ひとつの命令で複数のデータを同時に処理する「SIMD(Single Instruction, Multiple Data)」という方式を採用したコンピュータを指します。
一般的なプロセッサが数値をひとつずつ扱うのに対し、ベクトルプロセッサは「ベクトル」と呼ばれるデータの並びを、一つの命令でまとめて計算ユニットに流し込みます。
このアプローチは、1970年代にクレイ(Cray)社の「Cray-1」によって確立され、その後長らくスーパーコンピュータの主流として君臨しました。
現在では、純粋なベクトルコンピュータだけでなく、汎用CPUの中にベクトル演算機能を取り込んだものや、GPUのようなアクセラレータも広く普及しています。
ベクトルコンピュータは、特にメモリとプロセッサ間の通信帯域(メモリ帯域)が非常に広く設計されているという特徴があります。
これは、演算速度が速くてもデータ供給が追いつかなければ意味がない、というボトルネックを解消するための伝統的な設計思想に基づいています。
ベクトルプロセッサの仕組み:スカラ型との違い
コンピュータの演算方式には、大きく分けて「スカラ演算」と「ベクトル演算」の2つのスタイルが存在します。
これら二つの違いを理解することが、ベクトルコンピュータの本質を理解する近道となります。
スカラ演算とベクトル演算の比較
スカラ演算とは、1+1や5×10のように、単一の数値データ同士をひとつずつ処理する方式です。
もし1,000個のデータに対して足し算を行いたい場合、スカラ演算では1,000回分の命令を発行し、1,000回計算を繰り返さなければなりません。
一方、ベクトル演算では、1,000個のデータをひとつの「ベクトル」として定義し、1回の命令で全てのデータを加算処理するイメージで動作します。
これにより、命令の解釈にかかるオーバーヘッドを劇的に削減し、演算器を常にフル稼働させることが可能になります。
パイプライン処理による高速化
ベクトルコンピュータの高速性を支える核心技術のひとつが、「パイプライン処理」です。
パイプライン処理とは、工場におけるベルトコンベア式の組み立て作業のように、計算工程を細分化して並列に実行する仕組みです。
ベクトルプロセッサでは、長いベクトルデータがこのパイプラインを次々と流れていくため、途切れることなく結果が出力され続けます。
スカラプロセッサにもパイプラインは存在しますが、ベクトルプロセッサはより大規模で深いパイプラインを効率的に埋めることができるため、スループットが圧倒的に高くなります。
ベクトルレジスタの役割
ベクトルプロセッサの内部には、「ベクトルレジスタ」と呼ばれる高速な専用記憶領域が備わっています。
これは、一度メモリから読み込んだ大量のデータをプロセッサのすぐ近くに保持しておくための場所です。
ベクトルレジスタにデータを格納しておくことで、低速なメインメモリへアクセスする頻度を減らし、演算器へ絶え間なくデータを供給することが可能になります。
レジスタのサイズや本数は、そのコンピュータが一度に処理できる「ベクトル長」を決定する重要な要素となります。
ベクトルコンピュータの主な特徴とメリット
ベクトルコンピュータが特定の分野で圧倒的な支持を得ている理由は、その独自の設計思想にあります。
ここでは、代表的な3つのメリットについて詳しく見ていきましょう。
1. 圧倒的な実行効率(スループット)
ベクトルコンピュータは、規則正しいループ処理において極めて高い実行効率を誇ります。
科学技術計算のプログラムは、その多くが巨大な多次元配列に対するループ演算で構成されています。
ベクトルプロセッサはこのような構造に最適化されているため、理論上の最大性能に近い実効性能を引き出しやすいという特徴があります。
2. 高いメモリ帯域幅
多くの計算機が「メモリの壁(演算速度に対してメモリの供給速度が遅い問題)」に直面する中、ベクトルコンピュータはこの問題を設計段階で克服しようとしています。
メモリシステムを多数のバンクに分割し、同時に複数のデータを読み書きする技術が導入されています。
これにより、大規模なデータを一度にロードし、演算器を遊ばせることなく処理を継続できます。
3. プログラミングの簡潔さ(ベクトル化)
ベクトルコンピュータ向けのプログラムは、コンパイラの「自動ベクトル化機能」によって最適化されることが多いです。
開発者が複雑な並列化コードを手書きしなくても、標準的なループ構造を記述すれば、コンパイラが自動的にベクトル命令に変換してくれます。
もちろん、性能を限界まで引き出すには工夫が必要ですが、並列処理の記述負荷が他のアーキテクチャに比べて低い点は大きな利点です。
歴史と日本における展開(地球シミュレータから富岳まで)
ベクトルコンピュータの歴史において、日本は世界をリードする技術力を示してきました。
1980年代から1990年代にかけて、NEC、富士通、日立製作所といった国内メーカーは、独自のベクトル型スーパーコンピュータを次々と開発しました。
特に世界に衝撃を与えたのが、2002年に稼働を開始したNECの「地球シミュレータ」です。
地球シミュレータは、当時世界最速の性能を記録し、気象予報や気候変動予測の精度を飛躍的に向上させました。
その後、スパコンの主流は安価な汎用プロセッサを大量に並べる「スカラ型(クラスタ型)」へと移り変わりましたが、ベクトル型の思想は死に絶えてはいません。
2010年代に登場した富士通の「京」や、その後の後継機である「富岳(Fugaku)」は、スカラ型の構成をベースにしつつも、強力なベクトル演算機能(SVE: Scalable Vector Extension)を取り入れています。
このように、純粋なベクトル型専用機から、スカラ型とベクトル型の長所を融合させた「ハイブリッドな設計」へと進化を遂げているのです。
現代における重要性とAI・ディープラーニングへの応用
一時期は「過去の技術」と思われがちだったベクトル演算ですが、近年のAI(人工知能)ブームによって再び脚光を浴びています。
ディープラーニングの本質は、巨大な行列同士の積和演算であり、これはまさにベクトルコンピュータが得意としてきた領域そのものです。
現在のAI処理を支えるGPU(Graphics Processing Unit)も、実はベクトル演算の概念を極限まで並列化したものと言えます。
GPUは数千個の小さな演算コアを用いてベクトルデータを処理しますが、一方でNECの「SX-Aurora TSUBASA」のように、伝統的なベクトルプロセッサをPCI Expressカードに凝縮した製品も登場しています。
これらの製品は、消費電力あたりの性能や、メモリ帯域を重視する特定のAIモデル、ビッグデータ解析において非常に高い競争力を持っています。
大規模な言語モデルや物理シミュレーションを統合したデジタルツインの構築においても、ベクトル処理能力は欠かせない要素となっています。
スカラ・ベクトル・GPUの比較表
それぞれのアーキテクチャには得意・不得意があります。
以下の表で、主要な特徴を整理しました。
| 特徴 | スカラコンピュータ (一般的なCPU) | ベクトルコンピュータ (専用プロセッサ) | GPU (グラフィックスプロセッサ) |
|---|---|---|---|
| 得意な処理 | 複雑な分岐、単一タスクの高速化 | 規則的な連続データ、物理シミュレーション | 膨大な単純計算、画像処理、AI学習 |
| 並列処理方式 | マルチコア、マルチスレッド | SIMD(ベクトル命令) | SIMT(超多並列スレッド) |
| メモリ帯域 | 並程度(キャッシュに依存) | 極めて広い(高スループット) | 非常に広い(HBMなどを使用) |
| プログラミング | 容易(C, C++, Javaなど) | 比較的容易(自動ベクトル化) | やや複雑(CUDA, OpenCLなど) |
ベクトル化プログラミングの要点
ベクトルコンピュータの性能を最大限に引き出すためには、プログラムを「ベクトル化可能」な形式で記述する必要があります。
ここでは、C言語を用いた簡単な例で、どのようにベクトル化が行われるかをイメージしてみましょう。
// スカラ演算的な考え方のループ
// 逐次処理されるが、コンパイラがこれをベクトル化する
void add_arrays(int n, float *a, float *b, float *c) {
    for (int i = 0; i < n; i++) {
        // 各要素を独立して計算
        // コンパイラはこれを一括処理するベクトル命令に置き換える
        c[i] = a[i] + b[i];
    }
}
上記のコードにおいて、変数 i のループ内で、他の要素への依存関係がないことが重要です。
例えば、a[i] の計算に a[i-1] の結果が必要な場合、前の計算が終わるまで次の計算ができないため、ベクトル化が阻害されます。
このような「データの依存関係」を排除し、並列に計算できる構造を維持することが、ベクトルプログラミングの要諦です。
現代のコンパイラは非常に優秀であり、コードに特別なヒント(ディレクティブ)を与えるだけで、複雑な計算もベクトル化してくれるようになっています。
まとめ
ベクトルコンピュータは、大量のデータを一括で処理する「ベクトル演算」を極めた計算機アーキテクチャです。
1970年代からスーパーコンピュータの代名詞として君臨し、気象予報や航空宇宙などの科学技術計算を支え続けてきました。
一度は汎用CPUを用いたスカラ型コンピュータの台頭により主役の座を譲ったかに見えましたが、その思想は進化し続けています。
現代ではGPUや最新のCPU、そしてAI専用チップの中にも、ベクトル演算の技術が深く根付いています。
膨大なデータをリアルタイムで解析する必要がある現代社会において、高帯域なメモリと強力な演算性能を両立させるベクトルコンピュータの重要性は、今後さらに高まっていくでしょう。
「大量のデータをいかに速く、効率よく捌くか」という課題に対する究極の答えのひとつが、ベクトルコンピュータなのです。