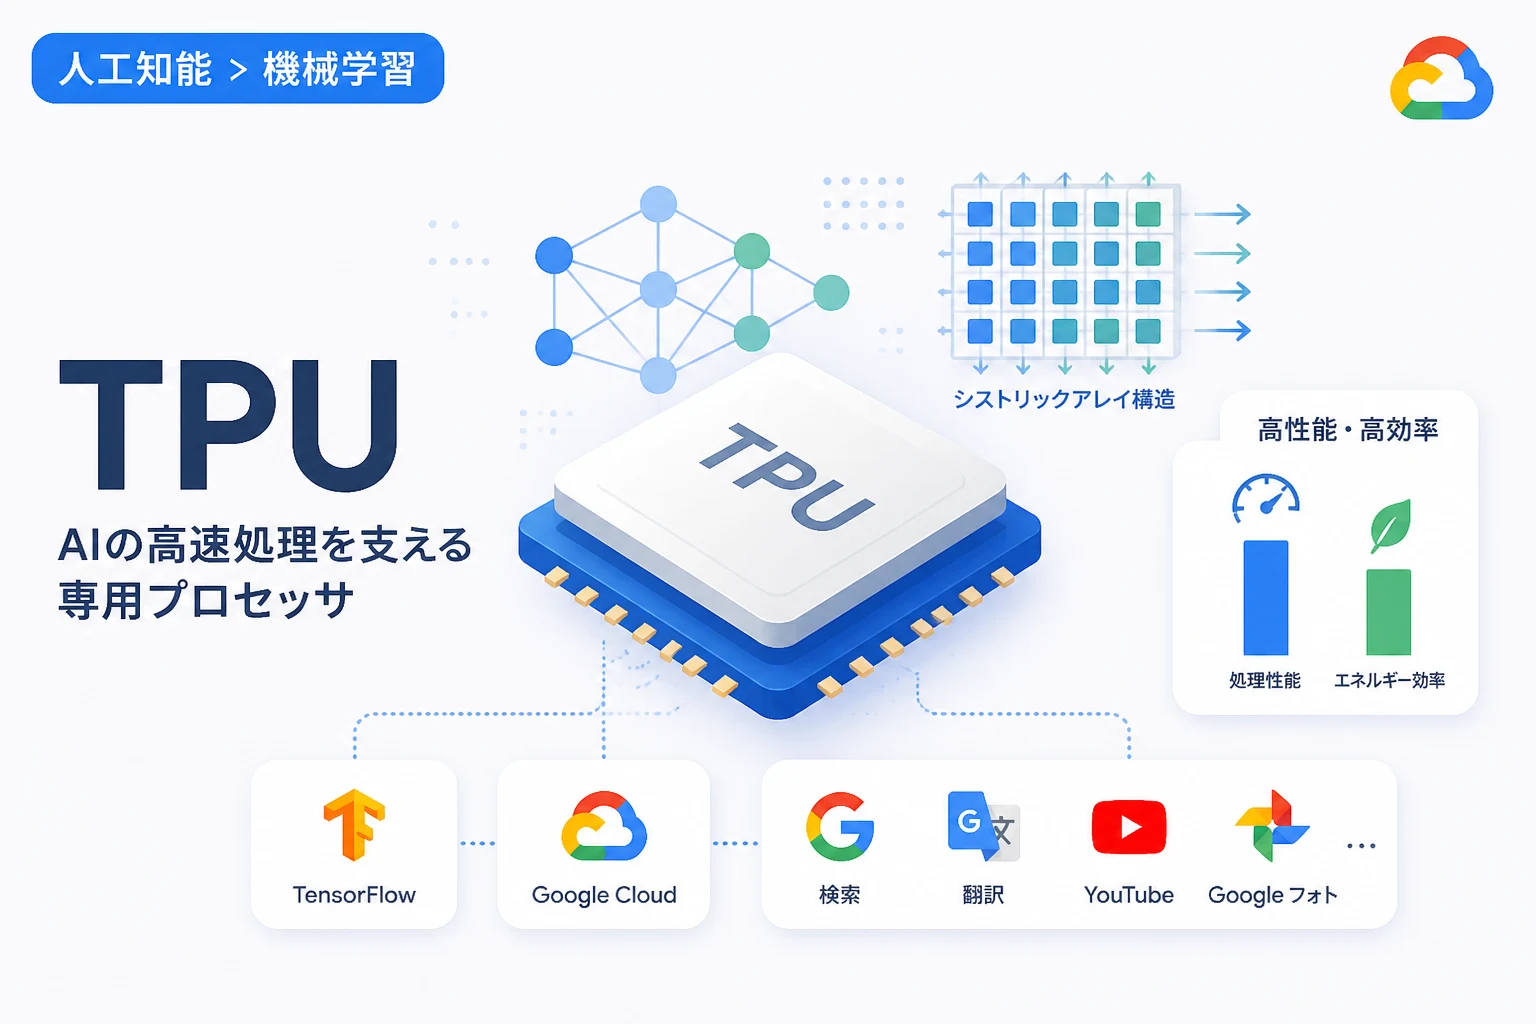
人工知能(AI)の進化を支えるハードウェアとして、Googleが独自に開発したTPU(Tensor Processing Unit)に注目が集まっています。
これは、機械学習のワークロードに特化して設計された半導体チップであり、一般的なCPUやGPUとは異なる設計思想を持っています。
本記事では、このTPUの仕組みや特長について、技術的な背景を踏まえながら詳しく解説していきます。
TPUの概要
TPUとは何か
TPUとは「Tensor Processing Unit」の略称で、Googleが2016年に発表したAI専用プロセッサです。
テンソル(多次元配列)演算を効率的に処理するために最適化されており、特にディープラーニングの学習と推論において高いパフォーマンスを発揮します。
CPUが逐次処理を得意とし、GPUが並列グラフィックス処理に適しているのに対し、TPUはテンソル演算そのものをアーキテクチャの中心に据えている点が最大の特徴です。
TPUの開発背景
GoogleがTPUを開発した背景には、自社サービスで膨大な機械学習処理が必要になったという事情があります。
たとえば、検索エンジン、音声認識、画像認識、翻訳といったサービスでは、ディープニューラルネットワークが多用されており、その計算量は年々増大していました。
既存の汎用チップでは電力効率や処理速度に限界があったため、専用ASIC(Application-Specific Integrated Circuit)としてTPUが設計されたのです。
TPUのアーキテクチャと仕組み
シストリックアレイ
TPUの心臓部とも言えるのが、シストリックアレイ(Systolic Array)と呼ばれる行列演算エンジンです。
これは、データをリズム良く流しながら、複数の演算ユニットでパイプライン処理を行う方式を指します。
このアーキテクチャにより、行列積の計算を極めて効率的に実行でき、メモリアクセスのオーバーヘッドも大幅に削減されます。
具体的には、重み行列をアレイ内に保持したまま、入力データを順番に流し込むことで、ひとクロックサイクルで複数の積和演算を同時に実行できます。
低精度演算の活用
ディープラーニングでは、計算精度を多少犠牲にしても処理速度が求められる場面が多くあります。
TPUはこれを踏まえ、bfloat16やINT8といった低精度の数値フォーマットをサポートしています。
bfloat16は、従来の32ビット浮動小数点と同等の指数部を持ちながら、仮数部を短くすることで、メモリ使用量と計算コストを半分に抑えられる形式です。
これにより、学習時のスループット向上と消費電力の削減を両立しています。
TPUの特長
高速な機械学習処理
TPUは、特定の行列演算に特化しているため、同世代のGPUと比較しても高い処理能力を示す場合があります。
たとえば、BERTやResNetといった代表的なモデルの学習において、大規模クラスタ構成を組めば、トレーニング時間を劇的に短縮できます。
これは、シストリックアレイと専用のインターコネクトが密結合しているため、ノード間のデータ転送がボトルネックになりにくいからです。
エネルギー効率の高さ
専用ASICであるTPUは、不要な命令や回路を省いているため、1ワットあたりの演算性能が極めて高いという利点があります。
大規模データセンターでは、消費電力と冷却コストが運用上の大きな課題です。
TPUを導入することで、同じ処理量をより少ない電力でこなせるため、Googleのサービス全体のエネルギー効率改善につながっています。
TensorFlowとの親和性
TPUは当初から、Googleが開発した機械学習フレームワーク「TensorFlow」と密接に統合されてきました。
ユーザーは、既存のTensorFlowコードに対して、わずかな修正を加えるだけでTPUでの分散学習を実行できます。
このシームレスな開発体験は、研究者やエンジニアがハードウェアの詳細を意識せずに、大規模モデルの実験に集中できる環境を提供しています。
TPUとGPUの違い
| 項目 | TPU | GPU |
|---|---|---|
| 開発元 | NVIDIA、AMDなど | |
| 設計思想 | 機械学習特化のASIC | 汎用並列プロセッサ(元はグラフィックス用) |
| 主要演算ユニット | シストリックアレイ | CUDAコア、Tensorコア |
| 得意な処理 | テンソル積、行列演算 | 多様な並列計算、グラフィックス処理 |
| フレームワーク | TensorFlow、PyTorch(一部) | 多様なフレームワークに対応 |
| 入手方法 | Google Cloud経由で利用 | 市販品として購入可能 |
得意とする処理の違い
GPUは多数の演算コアを汎用的に利用できるため、画像処理や物理シミュレーションなど、幅広い分野で実績があります。
一方で、TPUはあくまでテンソル演算に特化しており、汎用性ではGPUに劣る面もあります。
しかし、Transformer系モデルやCNNのような機械学習ワークロードに限れば、TPUが優位に立つケースが多く見られます。
プログラミングモデル
GPUでは、CUDAやOpenCLといった低レベルAPIを使ってカーネルを記述できますが、TPUはより抽象度の高いグラフベースの処理が基本です。
そのため、細かい並列制御をしたい場合はGPUの方が柔軟性が高いと言えます。
しかし、一般的な機械学習の実装においては、TPUの抽象化レイヤーが開発効率の向上につながっています。
TPUの活用事例
Googleのサービス
TPUは、Google検索のランキングアルゴリズム、YouTubeの動画推薦、Gmailのスマートリプライ、Google翻訳など、数多くのGoogleサービスで実際に運用されています。
これらのサービスでは、高精度な推論をリアルタイムで実行する必要があるため、TPUの低遅延・高スループット特性が活かされています。
クラウドTPU
Google Cloud Platformでは、外部の開発者や企業向けに「Cloud TPU」として、TPUリソースを時間単位でレンタル提供しています。
最新世代のTPU v5pでは、単一のPodで数千のチップを連結した超大規模並列学習が可能となりました。
スタートアップから大企業まで、このクラウドインフラを活用することで、自前で高価な計算機を購入することなく、最先端のAI研究を進められます。
まとめ
TPUは、テンソル演算に特化したシストリックアレイ構造と低精度演算を武器に、AI処理において圧倒的な効率性を実現するプロセッサです。
汎用性ではGPUに一歩譲るものの、大規模な機械学習の学習・推論においては、速度と消費電力の面で大きなメリットがあります。
クラウド経由で誰でも利用できるようになった今、TPUはAI開発のインフラストラクチャとして不可欠な存在になりつつあります。
今後の世代進化にも注目しながら、自社のワークロードに適したアクセラレータを選定していくとよいでしょう。