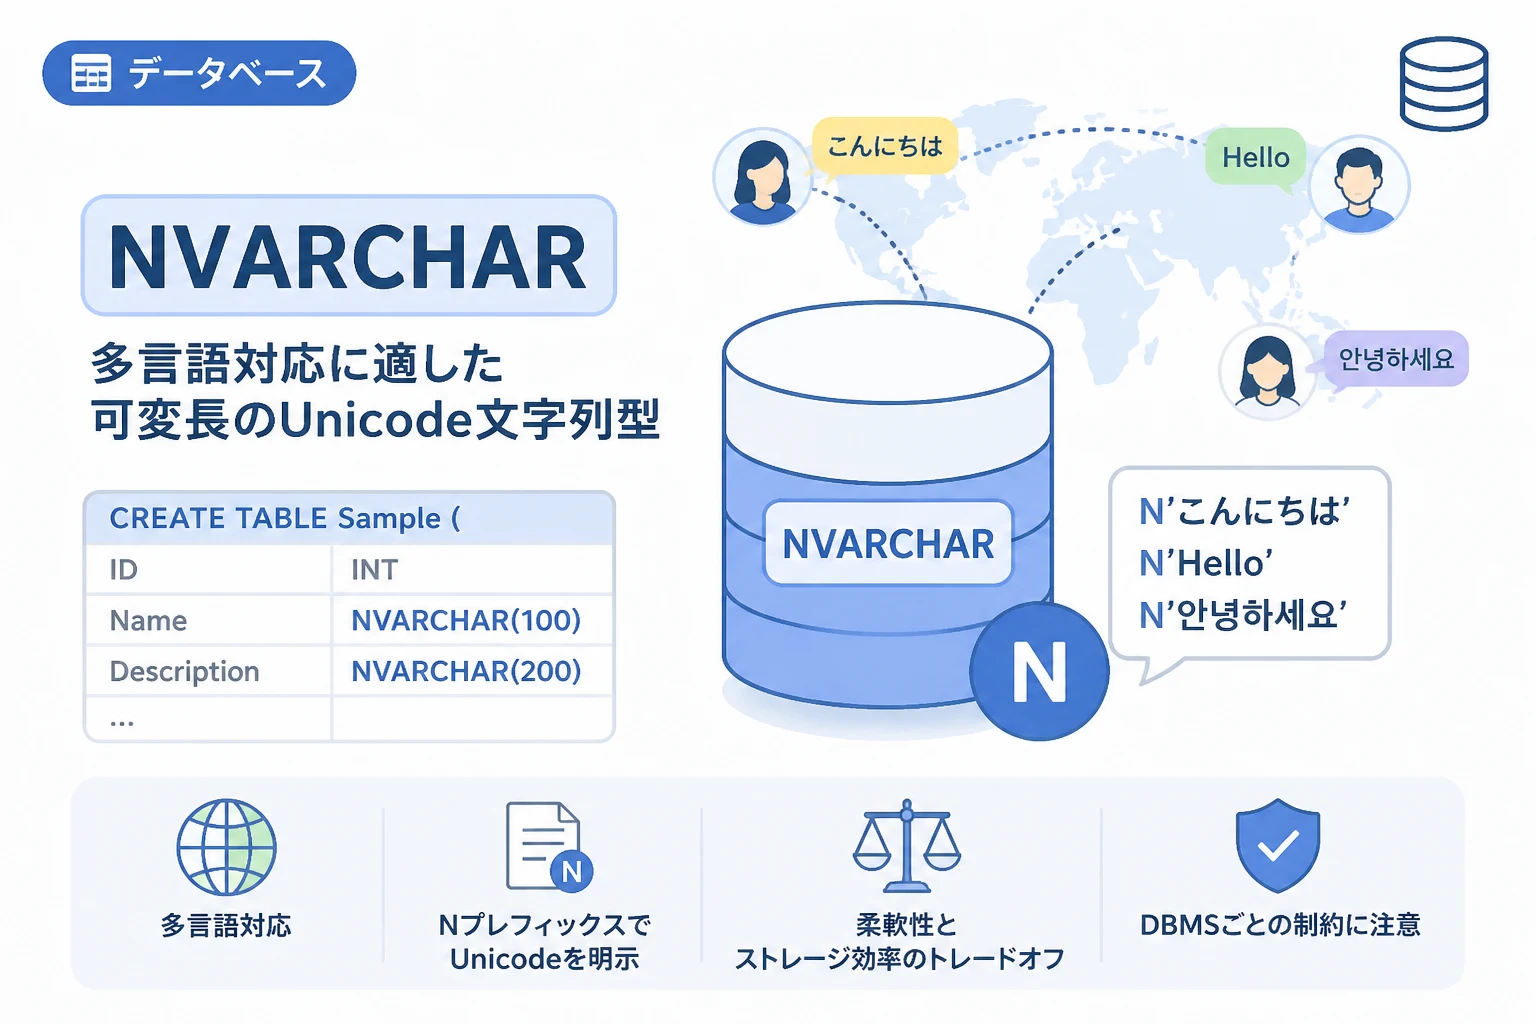
NVARCHAR(エヌバーキャラ)は、データベースで文字列を格納するためのデータ型のひとつです。
特に、日本語や中国語などマルチバイト文字を含む多言語データを扱う場合に欠かせない存在となっています。
この記事では、NVARCHARの基本的な定義からVARCHARとの違い、具体的な使い方までをわかりやすく解説します。
NVARCHARの基本
データ型の定義
NVARCHARは「National Character Varying」の略で、可変長のUnicode文字列を格納するためのデータ型です。
データベース管理システム(DBMS)によって挙動は若干異なりますが、多くの製品で1文字あたり2バイト(UTF-16)を使用します。
これにより、ほぼすべての言語の文字を統一された方法で保存・処理できるようになります。
VARCHARとの違い
NVARCHARとよく比較されるのがVARCHAR型です。
VARCHARは非Unicodeの文字列を扱い、格納できる文字はデータベースの照合順序(Collation)に依存します。
一方、NVARCHARはUnicode対応であるため、特定のコードページに縛られず複数言語を混在させられます。
この違いを表にまとめました。
| 項目 | NVARCHAR | VARCHAR |
|---|---|---|
| 文字エンコーディング | Unicode(通常UTF-16) | 非Unicode(コードページ依存) |
| 1文字あたりのバイト数 | 2バイト(サロゲートペアは4バイト) | 1バイトまたはマルチバイト(照合順序による) |
| 主な用途 | 多言語対応、グローバルアプリケーション | 単一言語、英数字中心のシステム |
| ストレージ効率 | 英数字でも2バイト消費するため非効率な場合あり | 言語に最適化されたバイト数で保存 |
主な特徴
NVARCHARは宣言時に最大文字数を(n)で指定します。
たとえばNVARCHAR(100)と定義した場合、最大100文字までの文字列を格納できます。
実際に消費するストレージは、格納された文字数に比例して変動する可変長です。
これは効率的なデータ管理に寄与しますが、頻繁な更新によって断片化が発生する可能性もあります。
NVARCHARの使い方
テーブル定義での使用例
実際にSQL Serverでテーブルを作成するケースを見てみましょう。
次の例では、顧客名と住所をNVARCHARで定義しています。
CREATE TABLE Customers (
    CustomerID INT PRIMARY KEY,
    CustomerName NVARCHAR(100) NOT NULL,
    Address NVARCHAR(200),
    Country NVARCHAR(50) DEFAULT N'日本'
);
データの挿入と検索
文字列リテラルの先頭にNを付与することで、Unicode文字列として明示的に扱います。
これにより、日本語や特殊文字が正しく解釈されます。
-- データの挿入
INSERT INTO Customers (CustomerID, CustomerName, Address, Country)
VALUES (1, N'山田 太郎', N'東京都新宿区1-2-3', N'日本');

-- データの検索
SELECT CustomerName
FROM Customers
WHERE Country = N'日本';上記のWHERE句でもN'日本'と指定している点に注目してください。
サイズ指定の注意点
NVARCHARの最大サイズはDBMSによって異なり、SQL ServerではNVARCHAR(MAX)で最大2GBまで格納可能です。
ただし、インデックスを作成できるのはNVARCHAR(4000)未満の列に限られるため、設計時には注意が必要です。
また、使用するエディションや設定によっては行サイズの制限を超える場合もあります。
NVARCHARを採用するべきケース
グローバル向けのWebアプリケーションや、ユーザーが任意の言語でデータを入力するシステムではNVARCHARが必須です。
たとえば、SNSの投稿内容や氏名、住所など、将来的に多言語対応が見込まれるカラムには最初からNVARCHARを選択しておくべきです。
後からVARCHARからNVARCHARへ変更する場合、データ移行やアプリケーション側の改修に大きなコストがかかります。
そのため、国際化対応の可能性が少しでもあるなら、積極的にNVARCHARの採用を検討してください。
NVARCHAR使用時の注意点
NVARCHARは便利な反面、ストレージ消費量がVARCHARより大きくなりやすいというデメリットがあります。
例えば、半角英数字だけを格納する列にNVARCHARを使用すると、必要以上に容量を消費します。
また、照合順序の設定によってはパフォーマンスに影響が出るため、適切なインデックス設計が重要です。
データベース全体の文字セットをUTF-8に対応させた環境では、VARCHARでもUnicodeを扱えるケースが増えています。
利用しているDBMSのバージョンと機能を確認し、適切なデータ型を選択するよう心がけましょう。
まとめ
NVARCHARは、多言語データを安全かつ柔軟に扱うためのデータ型です。
VARCHARとの違いを理解し、要件に応じて使い分けることが、効率的なデータベース設計につながります。
この記事で紹介した特徴や使用例を参考に、ぜひ実際のテーブル設計に役立ててください。