現代のインターネット社会において、私たちが検索エンジンやアプリケーションで瞬時に目的の情報を見つけられるのは、背後で「インデックス」という仕組みが機能しているからです。
膨大なデータの中から特定の情報を探し出す作業は、図書館の数万冊の本の中から一冊を特定する作業に似ています。
もし索引や整理された棚がなければ、私たちは一冊ずつ本を確認しなければならず、途方もない時間がかかってしまうでしょう。
IT分野、特にデータベースや検索エンジンの文脈におけるインデックスは、まさにこの「索引」の役割を果たす重要な技術です。
本記事では、インデックスの基本的な概念から、データ検索を高速化する具体的な仕組み、そして導入する際のメリットと注意点について詳しく解説します。
インデックスとは何か?
インデックスとは、データベースなどのストレージに保存されたデータを効率的に検索するための「索引データ」のことです。
データベースの実体データは、通常、書き込まれた順序や物理的な位置に従って保存されています。
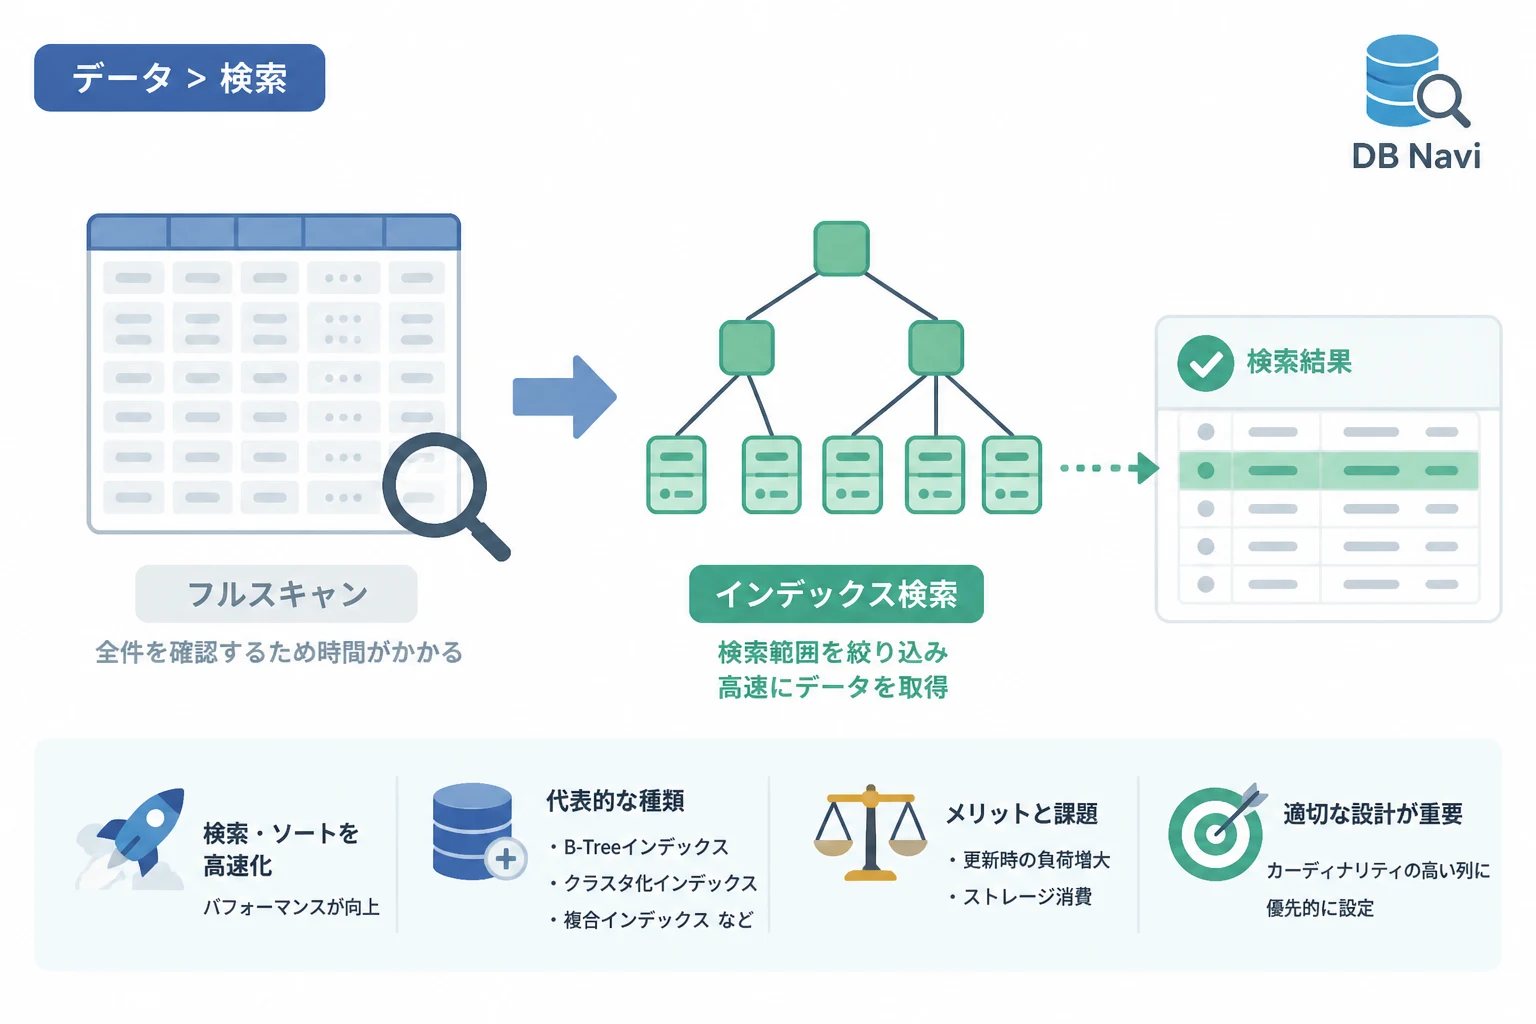
インデックスを作成しない状態では、特定のデータを検索するために「フルスキャン(全件走査)」と呼ばれる、全データを先頭から順番に確認する作業が必要になります。
データ量が数千件程度であればフルスキャンでも問題ありませんが、これが数百万件、数億件となると、検索結果が返ってくるまでに数秒から数分を要することもあります。
インデックスは、特定の列(カラム)のデータとその値が保存されている場所(ポインタ)をセットにして、検索しやすい形式で別に保存しておく仕組みです。
これにより、データベースはデータ本体をすべて見ることなく、インデックスを参照するだけで目的のデータの所在を突き止めることができます。
インデックスの身近な例
インデックスの仕組みを理解するためには、辞書や書籍の索引をイメージするのが最も分かりやすいでしょう。
例えば、国語辞典で「インデックス」という言葉を調べたいとき、最初のページから1語ずつ読んでいく人はいないはずです。
「あいうえお順」に並んでいる特性を活かし、まずは「あ行」のページを開き、次に「い」のセクションへと絞り込んでいくはずです。
この「あいうえお順に並んでいる」という構造そのものが、一種のインデックスとして機能しています。
データベースにおけるインデックスも、これと同様に特定のキーに基づいてデータを整理しておくことで、高速なアクセスを可能にしています。
インデックスがデータを高速化する仕組み
インデックスがなぜこれほどまでに高速なのか、その技術的な裏側には「データ構造」の工夫があります。
多くのリレーショナルデータベース(RDBMS)では、「B-Tree(ビー・ツリー)」と呼ばれる階層構造が採用されています。
B-Tree構造による探索の効率化
B-Treeは、データを木のような構造で管理するアルゴリズムです。
最上部には「ルートノード(根)」があり、その下に複数の「ブランチノード(節)」、最下部に「リーフノード(葉)」が配置されます。
各ノードにはデータの範囲情報が含まれており、検索条件に応じて「次は右の枝、次は左の枝」というように、探索範囲を劇的に絞り込むことができます。
この構造の優れた点は、データの総数がどれほど増えても、目的のデータにたどり着くまでのステップ数が非常に少なく済む点にあります。
例えば、100万件のデータがあっても、B-Tree構造を使えばわずか数回から十数回の参照で目的のデータを見つけることが可能です。
フルスキャンとインデックススキャンの比較
ここで、全データを探索するフルスキャンと、インデックスを利用したスキャンの違いを表にまとめてみましょう。
| 比較項目 | フルスキャン(Full Scan) | インデックススキャン(Index Scan) |
|---|---|---|
| 検索方法 | 全てのレコードを上から順に確認する。 | インデックスを参照してデータの所在を特定する。 |
| データ量の影響 | データ量が増えるほど処理時間が比例して増大する。 | データ量が増えても処理時間の増加が非常に緩やか。 |
| 得意なケース | 全データの大部分を抽出する場合や小規模な表。 | 膨大なデータから特定の1件や少数を探す場合。 |
| 負荷(I/O) | ストレージへの読み込み負荷が非常に高い。 | 必要な部分のみ読み込むため負荷が低い。 |
主要なインデックスの種類
データベースで利用されるインデックスには、用途や制約に応じていくつかの種類が存在します。
適切なインデックスを選択することは、システム設計において非常に重要です。
1. クラスタ化インデックス(Clustered Index)
クラスタ化インデックスは、テーブル内の物理的なデータの並び順そのものをインデックスの順序と一致させるものです。
基本的には、テーブルの「主キー(プライマリキー)」に自動的に設定されることが多いインデックスです。
物理的な並びが整列しているため、範囲検索(例:IDが100から200の間)において圧倒的なパフォーマンスを発揮します。
ただし、物理的な並び順を変更する必要があるため、1つのテーブルに1つしか作成できません。
2. 非クラスタ化インデックス(Non-Clustered Index)
非クラスタ化インデックスは、データ本体とは別に「索引リスト」を作成する形式です。
本の巻末にある索引のように、「キーワード」と「それが掲載されているページ番号(ポインタ)」のみを管理します。
データ本体の物理的な並び順には影響を与えないため、1つのテーブルに対して複数のインデックスを作成することが可能です。
特定の名前や日付など、主キー以外の列で検索を行う際によく利用されます。
3. 一意インデックス(Unique Index)
インデックスが設定された列において、重複した値を許可しない制約を持つインデックスです。
メールアドレスやユーザーIDなど、システム内で一意(ユニーク)である必要がある項目に設定されます。
検索の高速化だけでなく、データの整合性を担保する役割も果たします。
4. 複合インデックス(Composite Index)
複数の列を組み合わせて1つのインデックスとする仕組みです。
例えば、「名字」と「名前」の両方を使って検索する場合、それぞれ個別にインデックスを作るよりも、2つの列を組み合わせた複合インデックスの方が効率的です。
ただし、複合インデックスには「定義した列の順番」が検索パフォーマンスに大きく影響するという性質があります。
インデックスを導入するメリット
インデックスを適切に設計・導入することで、システムには多くの恩恵がもたらされます。
検索処理の劇的な高速化
最大のメリットは、何といっても検索(SELECT文)の実行速度が向上することです。
ユーザー数やデータ量が増加しても、インデックスが適切であれば応答時間を一定の低水準に保つことができます。
これは、Webサービスのユーザー体験(UX)を向上させるために不可欠な要素です。
サーバー負荷の軽減
インデックスを利用すると、CPUやメモリの消費、およびストレージからのディスクI/Oが削減されます。
フルスキャンのように大量のデータをメモリに読み込む必要がなくなるため、同じサーバーリソースでより多くの同時リクエストを処理できるようになります。
ソートや結合の効率化
インデックスはデータがソートされた状態で管理されているため、ORDER BYによる並び替え処理や、複数のテーブルを結合するJOIN処理も高速化されます。
集計処理など、重いクエリのチューニングにおいてもインデックスは強力な武器となります。
インデックスのデメリットと注意点
インデックスは「魔法の杖」ではありません。
導入にはトレードオフが存在します。
誤ったインデックス設計は、逆にシステムのパフォーマンスを低下させる原因となります。
書き込み処理(INSERT/UPDATE/DELETE)の遅延
データが追加・更新・削除されるたびに、データベースは「インデックス情報の更新」も同時に行わなければなりません。
インデックスが多いほど、書き込み時のオーバーヘッドが増大し、処理時間が長くなります。
頻繁に大量の更新が発生するテーブルに過剰なインデックスを設定することは避けるべきです。
ストレージ容量の消費
インデックスはデータ本体とは別の領域に保存されるため、追加のディスク容量を必要とします。
大規模なデータベースにおいて多くの列にインデックスを貼ると、インデックスのサイズがデータ本体を超えることも珍しくありません。
メンテナンスコストの増大
データの追加や削除を繰り返すと、インデックスの内部構造が断片化(フラグメンテーション)し、徐々に効率が低下することがあります。
定期的なインデックスの再構築やメンテナンスが必要になる場合があり、運用の手間が増える可能性があります。
インデックス運用のベストプラクティス
インデックスの恩恵を最大化し、デメリットを最小限に抑えるためには、戦略的な設計が求められます。
カーディナリティを意識する
インデックスを作成する際に最も重要な指標が「カーディナリティ(値の種類の多さ)」です。
カーディナリティが高い(値の種類が多い)列、例えば「社員番号」や「メールアドレス」などは、インデックスの効果が非常に高いです。
一方で、カーディナリティが低い(値の種類が少ない)列、例えば「性別」や「フラグ(0か1)」などは、インデックスを貼っても検索範囲を絞り込めず、効果が薄いどころか逆効果になることもあります。
実行計画(EXPLAIN)を確認する
作成したインデックスが実際に使われているかどうかは、SQLの「実行計画」を確認することで判断できます。
多くのデータベースではEXPLAINコマンドを使用することで、どのインデックスが使用され、何件のデータがスキャンされたかを確認可能です。
以下に、MySQLにおける実行計画の確認例を示します。
-- 実行計画を確認する例
EXPLAIN SELECT * FROM users WHERE email = 'example@test.com';id: 1
select_type: SIMPLE
table: users
partitions: NULL
type: const
possible_keys: idx_email
key: idx_email
key_len: 255
ref: const
rows: 1
filtered: 100.00
Extra: NULL上記の出力結果でkeyの項目に作成したインデックス名が表示されていれば、インデックスが有効に機能していることがわかります。
不要なインデックスは削除する
「とりあえず全部の列に貼っておこう」という考え方は非常に危険です。
使用されていないインデックスは、単に更新処理を遅くし、ストレージを浪費するだけの存在です。
定期的に利用状況をモニタリングし、不要になったインデックスは積極的に削除するようにしましょう。
まとめ
インデックスは、データベースのパフォーマンスを最大限に引き出し、ユーザーに快適なレスポンスを提供するために欠かせない技術です。
特定のキーでデータを整理し、B-Treeなどの効率的な構造で管理することで、数億件のデータからでも瞬時に情報を抽出することを可能にします。
しかし、インデックスは検索を速くする一方で、データの更新を遅くし、ストレージ容量を消費するという側面も持っています。
システムの特性を考慮し、カーディナリティの高い列を優先的に選定するなど、バランスの取れたインデックス設計が重要です。
データ構造の基本を理解し、適切に運用することで、スケーラブルで堅牢なシステムの基盤を築くことができるでしょう。
まずは自分の扱っているシステムで、どのクエリに時間がかかっているかを調査し、効果的なインデックスの導入を検討してみてはいかがでしょうか。