現代のデジタル社会において、私たちは当たり前のようにインターネットで情報を検索し、AIと対話をしています。
これらのテクノロジーの裏側で、人間の言葉をコンピュータに理解させるための基盤技術として活躍しているのが「形態素解析」です。
日本語のように単語と単語の間に空白がない言語において、テキストを意味のある最小単位に分割するこの技術は、自然言語処理の第一歩と言えます。
本記事では、形態素解析の基礎知識から具体的な仕組み、そして最新の自然言語処理における重要な役割までを詳しく解説します。
形態素解析とは何か
形態素解析とは、文章を「形態素」と呼ばれる意味を持つ最小の単位に分割し、それぞれの品詞や内容を判別する技術のことです。
英語などの言語では単語がスペースで区切られていますが、日本語は「わかち書き」がなされていないため、どこからどこまでが一つの単語なのかを判別する工程が不可欠です。
形態素の定義
形態素とは、言語学においてこれ以上分解すると意味をなさなくなる最小の単位を指します。
例えば、「食べなかった」という言葉を形態素解析すると、「食べ(動詞語幹)」「なかっ(助動詞)」「た(助動詞)」の3つに分解されます。
単語よりもさらに細かい単位で分析を行うことで、文章の構造をより正確に把握することが可能になります。
日本語における形態素解析の重要性
日本語は、名詞や動詞が連続して記述される「膠着語(こうちゃくご)」という特徴を持っています。
「今日は学校へ行く」という文をコンピュータが処理する場合、まず「今日/は/学校/へ/行く」と正しく分割できなければ、内容を理解することはできません。
そのため、日本語の自然言語処理において、形態素解析は全ての解析処理の入り口として極めて重要な位置を占めています。
形態素解析の仕組み
形態素解析は、主に「辞書」と「解析アルゴリズム」の組み合わせによって実行されます。
コンピュータは、あらかじめ用意された膨大な単語データが格納された辞書を参照しながら、入力された文章を照合していきます。
辞書ベースの解析
最も基本的な仕組みは、システム内に保持している辞書データと文章をマッチングさせる方法です。
辞書には単語の表記だけでなく、品詞情報や活用形、読み方などが登録されています。
しかし、単に辞書にある言葉を抜き出すだけでは、「すもももももももものうち」のような複雑な文を正しく分割することは困難です。
コスト計算とビタビアルゴリズム
現代の形態素解析エンジンでは、複数の分割候補の中から「最も自然なつながり」を選択するために、コスト計算という手法が用いられます。
各単語には「出現頻度(単語コスト)」が設定され、さらに単語と単語のつながりには「接続コスト」が割り振られています。
例えば、「私(名詞)」の後に「は(助詞)」が来る確率は高いですが、「私(名詞)」の後に「を(助詞)」がいきなり来る確率は相対的に低くなります。
解析エンジンは、文全体の合計コストが最小(最も自然)になる経路を「ビタビアルゴリズム」などの計算手法を用いて探し出します。
形態素解析の主要なプロセス
形態素解析は、一般的に以下の3つのステップを経て完了します。
1. 分かち書き(セグメンテーション)
連続した文字列を、意味のある単位(単語)ごとに区切る作業です。
これが正確に行われないと、その後の解析が全て誤ったものになってしまいます。
2. 品詞付与(POS Tagging)
分割された各単語に対して、名詞、動詞、形容詞、助詞などの品詞情報を割り当てます。
同じ表記でも文脈によって品詞が異なる場合(例:橋、箸、端)があるため、統計的な確率を用いて判断されます。
3. 原形復元(レンマタイゼーション)
動詞や形容詞のように活用する言葉を、辞書に載っている「基本形(終止形)」に戻す作業です。
「走った」「走れば」「走ろう」を全て「走る」という一つの原形として扱うことで、単語の出現頻度などを正しく集計できるようになります。
主要な形態素解析エンジンとツール
開発現場でよく利用される、代表的な形態素解析ライブラリを紹介します。
| ツール名 | 特徴 | 主な開発言語 |
|---|---|---|
| MeCab (メカブ) | 高速で汎用性が高く、最も普及しているエンジンの一つ。 | C++ (各種言語バインディングあり) |
| Janome (ジャノメ) | Pythonのみで記述されており、インストールが非常に簡単。 | Python |
| Sudachi (スダチ) | 商用利用を意識し、表記揺れへの対応や複数の分割単位をサポート。 | Java / Python |
| Kuromoji (クロモジ) | Javaで実装されており、全文検索エンジンElasticsearchなどで標準利用。 | Java |
ここでは、Pythonで手軽に利用できるJanomeを用いた簡単なコード例を紹介します。
from janome.tokenizer import Tokenizer

# 形態素解析器の初期化
t = Tokenizer()

# 解析したいテキスト
text = "私は美味しいリンゴを食べた。"

# 形態素解析の実行
for token in t.tokenize(text):
    # 表層形、品詞、原形などを出力
print(f"表層形: {token.surface}, 品詞: {token.part_of_speech}, 原形: {token.base_form}")表層形: 私, 品詞: 名詞,代名詞,一般,*, 原形: 私
表層形: は, 品詞: 助詞,係助詞,*,*, 原形: は
表層形: 美味しい, 品詞: 形容詞,自立,*,*, 原形: 美味しい
表層形: リンゴ, 品詞: 名詞,一般,*,*, 原形: リンゴ
表層形: を, 品詞: 助詞,格助詞,一般,*, 原形: を
表層形: 食べ, 品詞: 動詞,自立,*,*, 原形: 食べる
表層形: た, 品詞: 助動詞,*,*,*, 原形: た
表層形: 。, 品詞: 記号,句点,*,*, 原形: 。自然言語処理における役割と活用例
形態素解析は、単独で使われるよりも、より高度なシステムの「前処理」として利用されることが一般的です。
検索エンジンの高度化
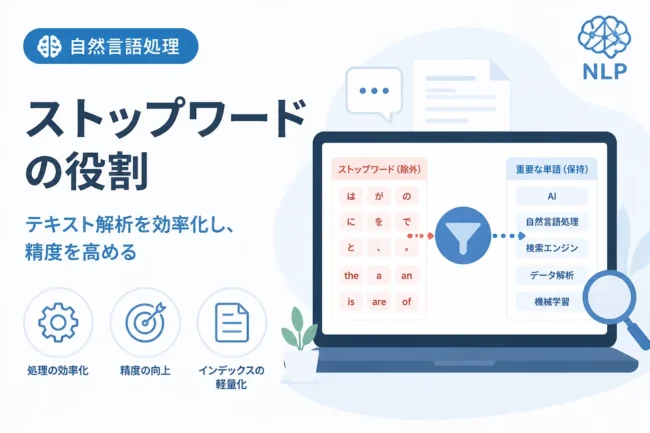
Googleなどの検索エンジンでは、ユーザーが入力したキーワードを形態素解析することで、無関係な助詞などを除外し、重要な単語だけを抽出します。
また、Webサイト上の膨大な文書もあらかじめ形態素解析してインデックス化することで、高速な全文検索を実現しています。
テキストマイニングと感情分析
SNSの投稿やアンケート結果を分析する「テキストマイニング」において、形態素解析は必須です。
文章から出現頻度の高い名詞を抽出してトレンドを把握したり、ポジティブ・ネガティブな意味を持つ形容詞を抽出して感情分析(センチメント分析)を行ったりします。
チャットボットと対話型AI
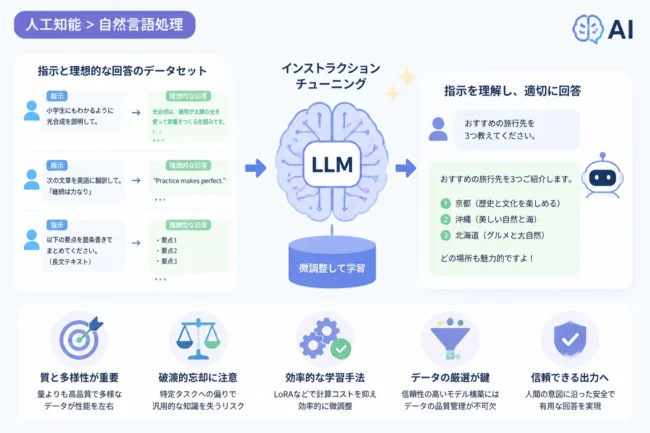
ChatGPTなどの大規模言語モデル(LLM)においても、形態素解析の考え方は「トークナイズ」という形で応用されています。
ユーザーの入力を意味のある断片に分解し、コンピュータが理解できる数値ベクトルに変換する過程で、形態素解析の知見が活かされています。
機械翻訳
翻訳元の文章の構造を解析するために形態素解析が利用されます。
主語はどれか、動詞の活用はどうなっているかを正しく把握することで、自然な訳文を生成する基礎データを作成します。
形態素解析の課題と注意点
非常に便利な形態素解析ですが、万能ではなくいくつかの課題も存在します。
未知語と新造語への対応
辞書に登録されていない新しい言葉や、流行語、ネットスラングなどは正しく解析できません。
例えば「バズる」や「推し活」といった新しい単語は、辞書を更新し続けない限り、「バズ(名詞)/る(動詞末尾)」のように誤って分割されてしまいます。
これを防ぐためには、「UniDic」や「NEologd」といった頻繁に更新されるユーザー辞書を併用することが推奨されます。
文脈による意味の判定
形態素解析は基本的に「単語の並び」を統計的に処理するため、文全体の深い意味までを理解しているわけではありません。
同音異義語の選択や、皮肉表現、複雑な構文においては、解析ミスが発生することがあります。
こうした課題を解決するために、近年では形態素解析の後に「構文解析」や「意味解析」を組み合わせる手法が一般的です。
まとめ
形態素解析は、日本語という複雑な言語をコンピュータに橋渡しするための最も基本的かつ重要な技術です。
私たちが日常的に利用している検索エンジン、AIチャット、翻訳ツールの多くは、この形態素解析の精度に支えられています。
自然言語処理の分野は、ディープラーニングや大規模言語モデルの登場により急速に進化していますが、テキストを最小単位で捉える形態素解析の概念は、今後も変わることのない基盤であり続けるでしょう。
これからデータ分析やプログラミングを学ぶ方は、まず形態素解析の仕組みを理解することから始めてみてはいかがでしょうか。
正確な言葉の分解が、より高度なAI活用への第一歩となります。