私たちが日常生活で何気なく使っている言葉は、コンピュータの世界では「自然言語」と呼ばれています。
スマートフォンでの音声操作や、インターネットでの翻訳サービス、さらには最新の対話型AIまで、私たちの身の回りには自然言語処理の技術が溢れています。
しかし、コンピュータがどのようにして曖昧な人間の言葉を理解し、適切な応答を返しているのか、その仕組みを正確に理解している方は少ないかもしれません。
本記事では、自然言語処理(NLP)の基礎知識から、複雑な解析の仕組み、そして最新の活用事例までを網羅的に解説します。
ITの専門知識がない方でも、読み進めるうちに自然言語処理の本質が理解できるような構成となっています。
自然言語処理(NLP)とは?
自然言語処理とは、英語で「Natural Language Processing」、略して「NLP」と呼ばれる人工知能(AI)の一分野です。
これは、人間が日常的にコミュニケーションに使用している「自然言語」を、コンピュータに処理・理解させるための技術を指します。
自然言語には、日本語や英語、中国語など、人類の歴史の中で自然に発生し、進化してきたあらゆる言語が含まれます。
一方で、コンピュータが動作するために人間が記述するプログラミング言語は、論理構造が厳密に定義された人工的な言語です。
自然言語はプログラミング言語とは異なり、文脈によって意味が変わったり、文法的に不完全な表現が含まれたりするという特徴があります。
そのため、論理的な処理を得意とするコンピュータにとって、自然言語を正しく理解することは長年の大きな課題でした。
自然言語処理の究極の目標は、人間とコンピュータが、まるで人間同士であるかのようにスムーズに会話できる環境を実現することにあります。
自然言語とプログラミング言語の決定的な違い
自然言語とプログラミング言語には、コンピュータが処理する上で無視できない決定的な違いがいくつか存在します。
以下の表に、それぞれの主な特徴と違いをまとめました。
| 比較項目 | 自然言語(日本語・英語など) | プログラミング言語(C, Pythonなど) |
|---|---|---|
| 目的 | 人間同士の意思疎通や情報の記録 | コンピュータへの命令と実行 |
| 文法 | 柔軟であり、例外や変化が多い | 厳密に定義され、1文字のミスも許されない |
| 意味の解釈 | 文脈やトーンにより多義的に変化する | 一意に定まり、常に同じ結果を返す |
| 進化 | 時代の流れとともに自然に変化する | 仕様策定者によって意図的にアップデートされる |
このように、自然言語には「曖昧さ」が含まれる点が、コンピュータ処理における最大の障壁となります。
例えば、「すもももももももものうち」という一文を、コンピュータが即座に意味のある単語の並びとして認識するのは、事前の処理なしでは困難です。
この曖昧さを解消し、論理的なデータへと変換する一連の工程こそが、自然言語処理の本質であると言えます。
自然言語処理が進化してきた歴史
自然言語処理の歴史は古く、1950年代の機械翻訳の試みから始まったとされています。
当時は、人間が言語のルールを一つずつ教え込む「ルールベース」という手法が主流でした。
しかし、言語の例外をすべて網羅することは不可能であり、翻訳の精度には限界がありました。
その後、1990年代に入ると、大量の文書データを統計的に分析する「統計的自然言語処理」が登場しました。
これにより、特定の単語がどの程度の確率で隣り合うかを計算し、より自然な文章の生成が可能になりました。
2010年代には、ディープラーニング(深層学習)の技術が導入され、精度は飛躍的に向上しました。
特に「ニューラルネットワーク」を用いたモデルは、言語の複雑な特徴を自動で学習できるようになりました。
そして現在では、「Transformer」と呼ばれる革新的なモデルの登場により、大規模言語モデル(LLM)が誕生しました。
これにより、ChatGPTのような高度な対話が可能なAIが、私たちの生活に身近な存在となったのです。
自然言語処理の仕組み:4つの解析ステップ
コンピュータが文章を理解するまでには、主に4つのステップを経て解析が行われます。
それぞれの工程で何が行われているのか、順を追って詳しく見ていきましょう。
1. 形態素解析(けいたいそかいせき)
形態素解析は、文章を「形態素」と呼ばれる意味を持つ最小単位に分割する作業です。
日本語のように単語の区切りに空白がない言語では、この工程が非常に重要になります。
例えば、「私は学校に行く」という文章は、「私」「は」「学校」「に」「行く」という要素に分解されます。
単に分割するだけでなく、それぞれの単語が「名詞」なのか「動詞」なのかといった品詞の情報も付与されます。
Pythonでよく使われる形態素解析ライブラリの一つに MeCab があります。
import MeCab

# MeCabの初期化
tagger = MeCab.Tagger()

# 解析するテキスト
text = "自然言語処理を学ぶ。"

# 形態素解析の実行
print(tagger.parse(text))
上記のプログラムを実行すると、以下のような結果が得られます。
自然	名詞,一般,*,*,*,*,自然,シゼン,シゼン
言語	名詞,一般,*,*,*,*,言語,ゲンゴ,ゲンゴ
処理	名詞,サ変接続,*,*,*,*,処理,ショリ,ショリ
を	助詞,格助詞,一般,*,*,*,を,ヲ,ヲ
学ぶ	動詞,自立,*,*,五段・バ行,基本形,学ぶ,マナブ,マナブ
。	記号,句点,*,*,*,*,。,。,。
EOS
このように、品詞や読み方、基本形などの情報が詳しく抽出されます。
2. 構文解析(こうぶんかいせき)
形態素解析でバラバラにされた単語同士が、どのような関係性にあるかを調べるのが構文解析です。
主に、主語と述語の関係や、どの言葉がどの言葉を修飾しているのかという「係り受け関係」を分析します。
「美味しいリンゴを食べる」という文において、「美味しい」が「リンゴ」を修飾していることを正しく認識するのがこのフェーズです。
これにより、文章の基本的な構造が木構造(ツリー構造)として表現されます。
3. 意味解析(いみかいせき)
構文解析でわかった文章の構造に基づき、その文がどのような「意味」を持っているかを判断するのが意味解析です。
同じ「橋」という言葉でも、文脈によって「渡る橋」なのか「食べる箸」なのかを判別しなければなりません。
辞書データなどを参照しながら、単語同士の組み合わせから正しい意味を特定します。
しかし、皮肉や比喩などの高度な表現を理解するのは、この段階でも依然として難しい課題とされています。
4. 文脈解析(ぶんみゃくかいせき)
複数の文章にまたがって、話の流れや指示代名詞の内容を理解するのが文脈解析です。
例えば、「彼は鞄を買った。それはとても高価だった。」という二つの文がある場合、「それ」が「鞄」を指していることを突き止めます。
この「照応解析」と呼ばれる処理を行うことで、コンピュータは人間と同じように文全体の流れを把握できるようになります。
文脈解析は自然言語処理において最も高度な技術の一つであり、現在のAIはこの分野で驚異的な進化を遂げています。
現代の自然言語処理を支える重要技術
近年の自然言語処理が爆発的に進化を遂げた背景には、いくつかの画期的な技術が存在します。
特に重要なキーワードをいくつか解説します。
Word2Vec(単語のベクトル化)
コンピュータは数字しか扱えないため、単語を数値のリスト(ベクトル)に変換する必要があります。
Word2Vecという技術は、単語の意味を多次元の空間上の座標として表現することを可能にしました。
これにより、「王様 – 男性 + 女性 = 女王」といった、単語間の意味的な計算が行えるようになったのです。
TransformerとAttention機構
2017年に発表された論文「Attention Is All You Need」で提唱された「Transformer」は、現在のNLPのデファクトスタンダードとなっています。
その中心となるのが「Attention(注意)」という仕組みです。
文章の中の特定の単語に「注目」して処理を行うことで、長い文章でも文脈を壊さずに並列処理が可能になりました。
この技術がベースとなって、BERTやGPTシリーズといった、これまでの常識を覆す精度を持つモデルが登場しました。
自然言語処理の身近な活用事例
自然言語処理はすでに私たちの生活のあらゆる場面に溶け込んでいます。
具体的にどのような場所で使われているのか、代表的な事例を紹介します。
- 検索エンジン:Googleなどの検索窓に入力したキーワードの意図を汲み取り、最適なWebページを表示します。
- 機械翻訳:Google翻訳やDeepLなどのサービスは、NLPの進化によって非常に自然な翻訳を実現しています。
- 音声アシスタント:SiriやAlexaなどは、音声をテキスト化し、その意図を自然言語処理で解釈して動作します。
- チャットボット・AIカスタマーサポート:企業の問い合わせ窓口で、人間の代わりにAIが24時間体制で対応を行います。
- テキスト要約:長いニュース記事や会議の議事録を、重要なポイントを絞って短くまとめます。
- 感情分析:SNSの投稿や商品レビューから、ユーザーがポジティブな感情を持っているか、ネガティブな感情を持っているかを判別します。
これらの技術はビジネスの効率化だけでなく、アクセシビリティの向上にも大きく貢献しています。
自然言語処理が抱える課題と今後の展望
驚異的な進化を続ける自然言語処理ですが、まだ解決すべき課題も残されています。
その一つが、「ハルシネーション(幻覚)」と呼ばれる問題です。
AIがもっともらしい嘘をついたり、事実に基づかない情報を生成したりすることがあり、信頼性の確保が急務となっています。
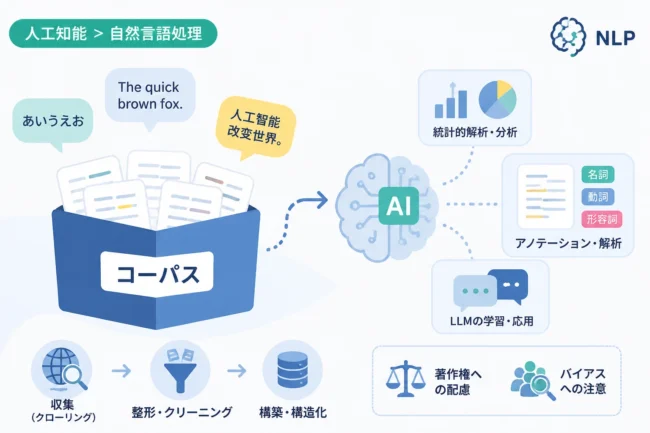
また、学習データに含まれる偏見や差別的な表現をAIが学習してしまう「バイアス」の問題も深刻です。
公平で倫理的なAIの開発は、技術的な進歩と同じくらい重要なテーマとなっています。
今後は、テキストだけでなく画像や音声、動画なども同時に処理する「マルチモーダルAI」との統合がさらに進むでしょう。
言葉の理解を超えて、人間の意図や感情をより深く汲み取れるパートナーへと進化していくことが期待されています。
まとめ
自然言語処理(NLP)は、人間とコンピュータの距離を縮めるための架け橋となる重要な技術です。
形態素解析から始まり、最新のTransformer技術に至るまで、その歩みは言語という複雑な対象をいかに数値化し、理解させるかの歴史でもありました。
現在、私たちはAIが自然な言葉で答えを返してくれるという、かつてのSF映画のような世界に生きています。
自然言語処理を正しく理解し、活用することは、これからのデジタル社会を生き抜くための大きな武器となるでしょう。
今後も進化を続けるこの分野の動向に、ぜひ注目してみてください。