β-VAEは、ディープラーニングを用いた生成モデルの一種であり、データの持つ本質的な特徴を独立して学習させることに特化したニューラルネットワークの手法です。
従来のVAE(Variational Autoencoder:変分オートエンコーダー)を拡張したモデルであり、データの背景にある潜在的な要因をより解釈しやすい形で抽出できる点が大きな特徴です。
近年では、画像生成や特徴抽出、さらにはロボティクスや異常検知など、データの背後にある構造を理解する必要がある幅広い分野で注目を集めています。
この記事では、β-VAEの基本的な仕組みから、重要概念である「もつれ解消(Disentanglement)」、そして実用上のメリットや注意点について詳しく解説します。
β-VAEの基本概念とVAEとの違い
β-VAE(ベータ・ブイエーイー)を理解するためには、まずその基礎となっているVAE(Variational Autoencoder)の仕組みを知る必要があります。
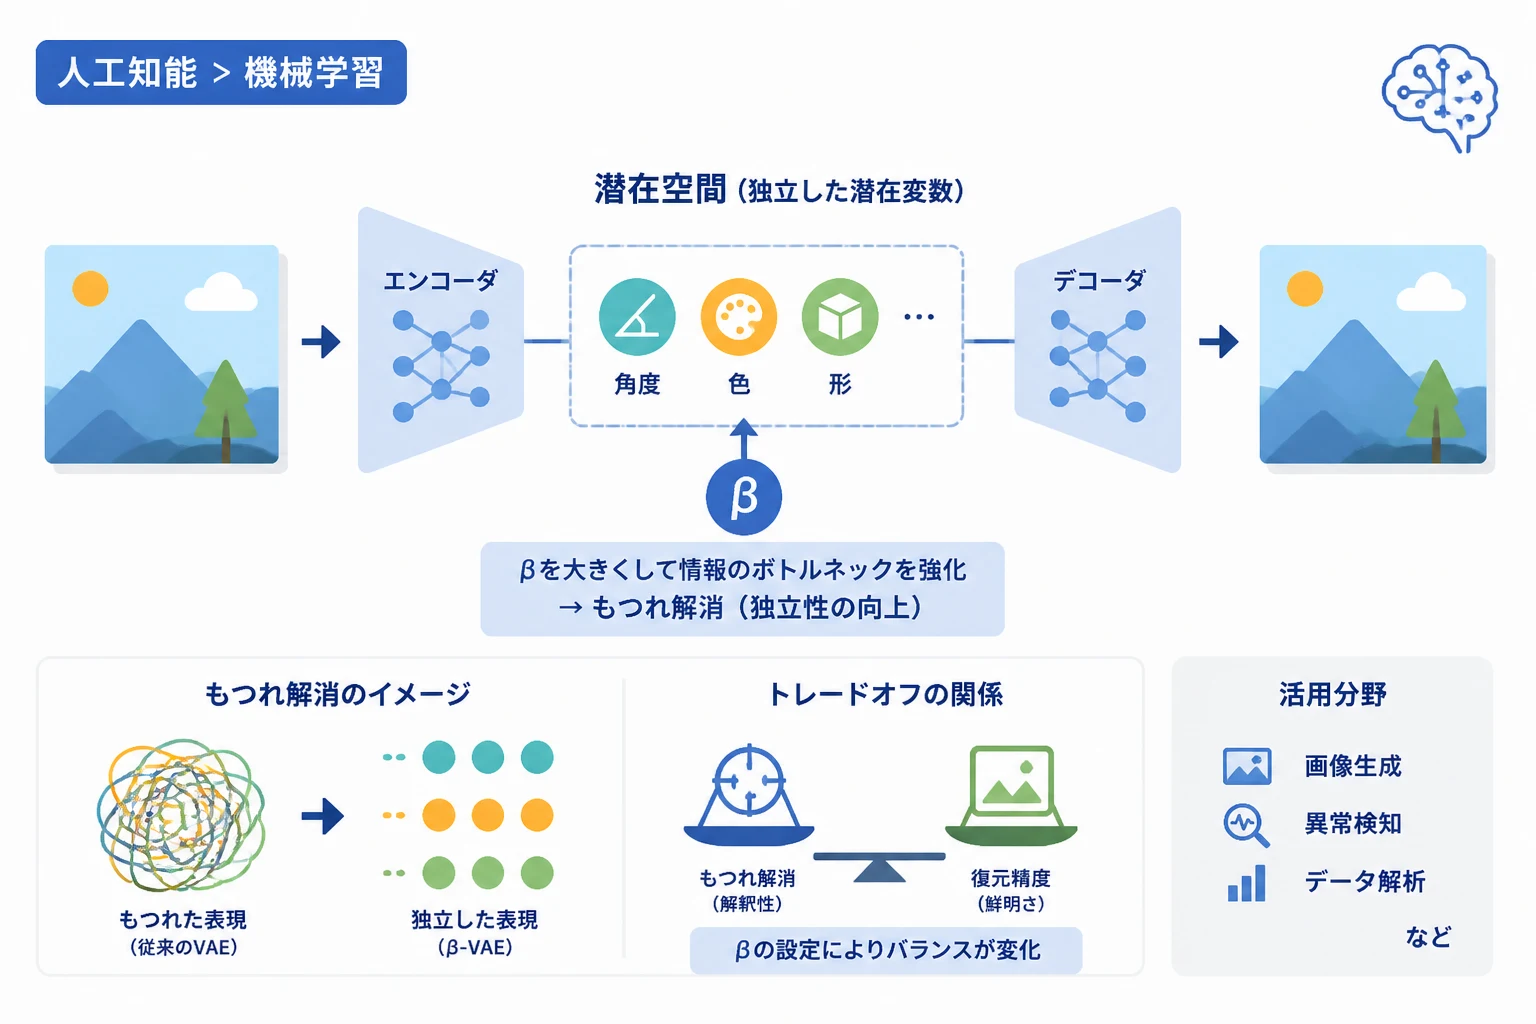
VAEは、入力を潜在空間と呼ばれる低次元の領域に圧縮する「エンコーダー」と、その潜在変数から元のデータを復元する「デコーダー」で構成される生成モデルです。
VAEの学習過程では、入力データを正確に再現することと、潜在変数の分布を標準正規分布(扱いやすい統計モデル)に近づけることの2点が重視されます。
しかし、標準的なVAEでは、複数の特徴量が複雑に絡み合った状態で潜在変数に格納されてしまうことが課題となっていました。
この「特徴の混ざり合い」を解消し、一つひとつの潜在変数が独立した意味を持つように改良されたのがβ-VAEです。
β-VAEの最大の特徴は、損失関数に含まれる「KLダイバージェンス(正規分布への近さを表す項)」に対して、「β」というハイパーパラメータを導入したことにあります。
このβの値を調整することで、モデルがどれだけ潜在変数の独立性を優先するかを制御できるようになります。
もつれ解消(Disentangled Representation)とは
β-VAEを語る上で欠かせないキーワードが「もつれ解消(Disentanglement)」という概念です。
現実世界のデータ、例えば「顔の画像」には、角度、笑顔の度合い、肌の色、髪の長さなど、多様な特徴量が含まれています。
通常、AIがこれらのデータを学習すると、一つの変数の中に「角度と笑顔」の両方の情報が混ざってしまうことが珍しくありません。
もつれが解消された状態とは、潜在変数の「次元1」が角度だけを司り、「次元2」が笑顔の度合いだけを司るというように、各変数が独立した意味を持つ状態を指します。
このように特徴が分離されることで、人間にとってAIの学習結果が非常に解釈しやすくなるという利点があります。
β-VAEは、このもつれ解消表現を自動的に獲得することを目的に設計されたアルゴリズムなのです。
β-VAEの数理的背景と仕組み
β-VAEの目的関数(学習において最小化すべき指標)は、以下の要素で構成されています。
| 要素 | 役割 |
|---|---|
| 再現誤差(Reconstruction Loss) | 入力データをどれだけ正確に復元できているかを測定する。 |
| KLダイバージェンス項 | 潜在変数の分布を標準正規分布に近づける正則化の役割を果たす。 |
| ハイパーパラメータ β | KLダイバージェンス項の重みを調整し、情報圧縮の強度を決める。 |
標準的なVAEではこのβの値が「1」に固定されていますが、β-VAEでは通常βを1よりも大きな値に設定します。
βの値を大きくすると、潜在空間における各変数の独立性が強まり、データの情報の「ボトルネック(通り道)」がより狭められます。
この強い制約(情報量ボトルネック)がかかることにより、ネットワークはデータの最も効率的かつ本質的な要素から優先的に学習しようとします。
その結果、複数の特徴が混ざり合う余裕がなくなり、各変数がそれぞれ独立したデータ生成要因を捉えるようになるのです。
この数理的な工夫こそが、複雑なデータから意味のある構造を抜き出すための鍵となっています。
潜在空間の正規化と独立性
KLダイバージェンス項は、各潜在変数が互いに無相関な標準正規分布に従うように強制する働きをします。
βを大きく設定することは、この「独立した正規分布であれ」という命令をより強く意識させることを意味します。
これにより、ある変数の値を変えても他の変数には影響が及ばない、直交した特徴空間が形成されます。
この性質を利用することで、画像生成などのタスクにおいて、特定の要素だけを自由に変更することが可能になります。
β-VAEを導入するメリット
β-VAEを利用することで、開発者やデータサイエンティストは以下のような多くのメリットを享受できます。
1. 潜在変数の高い解釈性
従来のブラックボックスになりがちなディープラーニングモデルに比べ、どの変数が何の意味を持っているのかを特定しやすいのが大きな魅力です。
例えば、車の3Dモデルを学習させた場合、ある変数をスライドさせると車の向きだけが変わり、別の変数を変えると色だけが変わるといった挙動が期待できます。
2. 特徴抽出器としての高性能さ
もつれが解消された特徴量は、後続のタスク(分類や回帰など)においても非常に有用な入力データとなります。
不要な情報の混じり込みが少ないため、少量の教師ありデータでも効率的に学習を進められる場合があります。
3. データ生成の自由度向上
生成AIとしての側面で見ると、特定の属性だけを指定してデータを生成する「条件付き生成」に近い操作を、明示的なラベルなしで行えるようになります。
β-VAEの課題とデメリット
非常に強力なβ-VAEですが、運用にあたってはいくつかのトレードオフを理解しておく必要があります。
最大の問題は、「もつれ解消」と「復元精度」がトレードオフの関係にあることです。
βの値を大きくしすぎると、情報のボトルネックが厳しくなりすぎてしまい、入力データの細かな詳細情報が削ぎ落とされてしまいます。
その結果、生成される画像がぼやけたり、細部のディテールが失われたりすることが一般的です。
また、どの変数がどの意味に対応するかは学習後に人間が確認する必要があり、完全に自動で名前付けがなされるわけではありません。
さらに、データの性質によっては、適切なβの値を見つけるためのチューニングに多大な試行錯誤を要する場合もあります。
β-VAEの主な活用事例
β-VAEはその特性を活かし、学術研究だけでなく産業界の様々な場面で活用が試みられています。
画像編集・生成
写真から「年齢」「表情」「照明」などの要素を独立して操作するためのツール開発に利用されています。
ユーザーがスライダーを動かすだけで、顔の向きだけを微調整するといった直感的な編集インターフェースが実現可能です。
医療画像解析
レントゲンやMRI画像において、病変の有無と患者の個体差(骨格や臓器の形状)を分離して抽出するために研究されています。
特定の疾患に関連する特徴だけを抜き出すことで、診断支援AIの信頼性を高める効果が期待されています。
ロボティクスの状態把握
ロボットが周囲の環境を認識する際、物体の「位置」と「種類」を分けて理解するために使われます。
複雑な視覚情報をシンプルな独立成分に分解することで、ロボットの制御アルゴリズムが安定しやすくなります。
異常検知
製造ラインなどでのデータから、「正常なバリエーション」と「異常な変化」を分離して学習させることが可能です。
正常時のもつれ解消表現から大きく外れるデータを検知することで、精度の高い異常検知システムを構築できます。
β-VAEの実装イメージ
Pythonの深層学習ライブラリであるPyTorchを用いた、β-VAEの損失関数の実装例を簡潔に示します。
import torch
import torch.nn.functional as F

def loss_function(recon_x, x, mu, logvar, beta):
    # データの再現度を測るための再現誤差(バイナリエントロピーなど)
    recon_loss = F.binary_cross_entropy(recon_x, x, reduction='sum')

    # 潜在分布を標準正規分布に近づけるためのKLダイバージェンス
    # ここでbetaを掛け合わせるのがβ-VAEの核心
    kl_loss = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp())

    # 全体の損失 = 再現誤差 + beta * KLダイバージェンス
    return recon_loss + beta * kl_loss

# パラメータの例
# beta > 1.0 に設定することで、もつれ解消を促進
beta_value = 4.0
# 出力例:loss = loss_function(output, input, mu, logvar, beta_value)
このコードからもわかる通り、実装自体は標準的なVAEに対して係数「beta」を一行加えるだけの非常にシンプルなものです。
しかし、この一つの係数がもたらす情報の圧縮効果は、学習される潜在空間の構造を劇的に変化させます。
β-VAEの派生モデルと発展
β-VAEの登場以降、その弱点を克服するための様々な派生モデルも提案されています。
例えば「Burgess et al. (2018)」によって提案された手法では、学習の進行に合わせてボトルネックの容量を徐々に増やしていくアプローチが取られています。
これにより、もつれを解消しつつも、復元画像の鮮明さを保つという高度な両立が図られています。
また、データの連続的な特徴だけでなく、離散的な特徴(カテゴリー情報など)も同時に扱える「Joint β-VAE」などの進化形も存在します。
これらの手法は、実世界のより複雑で多様なデータ構造を捉えるために、日々改良が進められています。
まとめ
β-VAEは、VAEという優れた枠組みに「β」というシンプルな制御因子を加えることで、潜在変数の独立性を飛躍的に高めた革新的なモデルです。
「もつれ解消」という概念を実現することで、AIがどのようにデータを理解しているかを人間が把握しやすくなり、信頼性の高いシステム構築に貢献します。
再現精度とのトレードオフという課題はあるものの、ハイパーパラメータの調整や派生モデルの活用によって、その応用範囲は広がり続けています。
データの背後にある本質的な構造を見抜き、解釈性の高いAIモデルを構築したい場合には、β-VAEは非常に強力な選択肢となるでしょう。
生成AIの進化とともに、この「意味を分離して理解する」技術は、今後さらに重要性を増していくと考えられます。