ストップワードという言葉は、Web制作やデータ分析、あるいは検索エンジンの仕組みを理解する上で非常に重要な概念です。
一般的には、検索エンジンや自然言語処理のプログラムが文章を処理する際に、あえて無視するように設定された単語のことを指します。
日常的に使われる助詞や冠詞などは、文章の構造を支える一方で、その文章が「何について書かれているか」という主題を特定する情報としては不十分な場合が多いからです。
本記事では、ストップワードが具体的にどのような役割を果たし、SEOやAIの分野でどのように扱われているのかを詳しく解説します。
ストップワードとは?
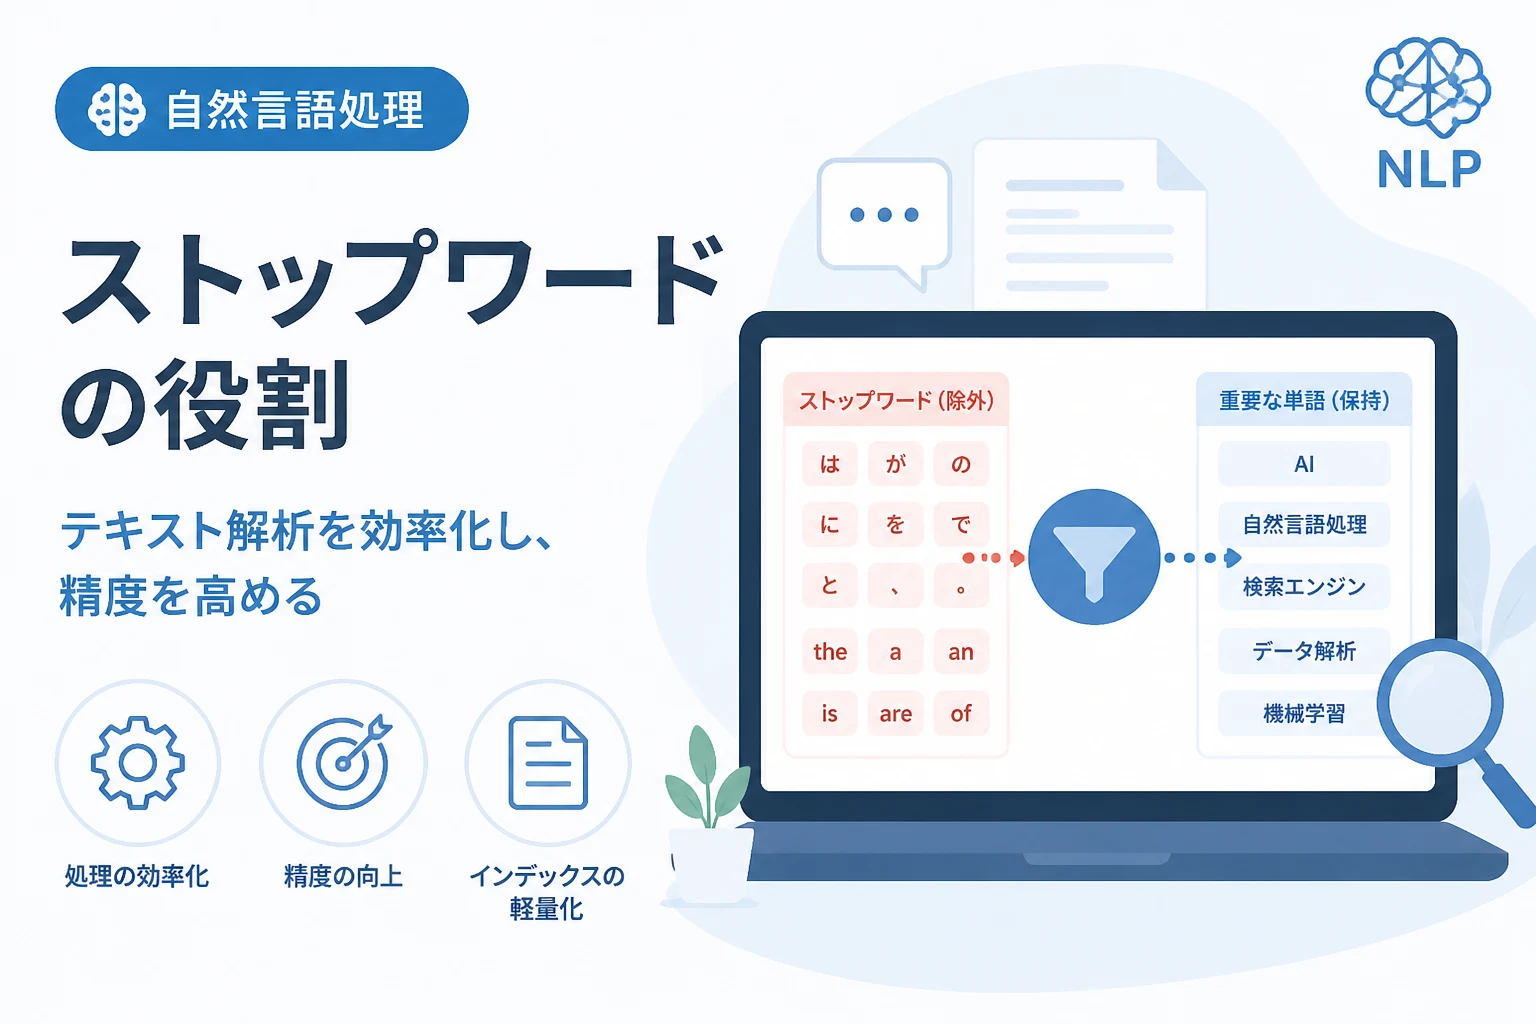
ストップワードとは、検索エンジンや自然言語処理システムがテキストデータを解析する際に、処理の対象から除外される頻出語のことです。
これらの単語は、文章の中で出現頻度が非常に高いものの、単体では特別な意味を持たない、あるいは文脈を特定する力が弱いという特徴があります。
例えば、英語では「a」「an」「the」「in」「on」といった冠詞や前置詞が代表的なストップワードとして扱われます。
日本語においては、「は」「が」「の」「に」といった助詞や、「する」「ある」といった動詞の一部がこれに該当します。
ストップワードが定義される目的
システムがすべての単語を一律に処理しようとすると、膨大な計算リソースが必要になります。
特に大規模なデータベースやウェブ上の膨大なテキストを扱う場合、意味の薄い単語をあらかじめ除外しておくことで、データ処理の効率を劇的に向上させることができます。
また、ストップワードを除去することで、その文章を象徴する「特徴的なキーワード」が浮き彫りになりやすくなります。
これにより、検索精度の向上やテキストマイニングの精度向上が期待できるのです。
自然言語処理(NLP)におけるストップワードの役割
AIや機械学習を用いた自然言語処理において、ストップワードの除去は「前処理」と呼ばれる重要な工程の一つです。
コンピュータは文章をそのまま理解するのではなく、単語を数値化(ベクトル化)して処理を行います。
この際、出現頻度が極端に高いストップワードが含まれていると、計算結果がそれらの単語に引きずられ、分析の精度が低下する恐れがあります。
テキストクレンジングとノイズの削減
テキストデータから不要な情報を削ぎ落とす作業を「テキストクレンジング」と呼びます。
ストップワードは、分析において「ノイズ(雑音)」と見なされることが多いため、真っ先に除去の対象となります。
ノイズを減らすことで、アルゴリズムは「機械学習」や「AI」といった、文章の本質に関わる単語に集中して学習を行うことが可能になります。
処理速度とストレージ容量への影響
ストップワードを除外することは、計算コストの削減だけでなく、インデックス(索引)のサイズを小さくすることにも寄与します。
数百万件、数億件という文書を扱うシステムにおいて、ストップワードを除去するかどうかで、必要なストレージ容量や検索応答速度に大きな差が生じます。
現代のコンピュータスペックでは無視できるケースも増えていますが、極めて大規模なデータを扱う際には依然として有効な手法です。
Pythonを用いたストップワード削除の例
実際にプログラム上でどのようにストップワードが扱われるか、Pythonの代表的な自然言語処理ライブラリ「NLTK」を用いた例を見てみましょう。
import nltk
from nltk.corpus import stopwords

# ストップワードのリストをダウンロード(初回のみ)
nltk.download('stopwords')

# 英語のストップワードセットを取得
stop_words = set(stopwords.words('english'))

# サンプル文章
text = "This is a simple example showing how stop words work in a system."
words = text.lower().split()

# ストップワードに含まれない単語のみを抽出
filtered_words = [word for word in words if word not in stop_words]

print(f"元の単語数: {len(words)}")
print(f"除去後の単語: {filtered_words}")
print(f"除去後の単語数: {len(filtered_words)}")
上記のコードを実行すると、以下のような結果が得られます。
元の単語数: 13
除去後の単語: ['simple', 'example', 'showing', 'stop', 'words', 'work', 'system.']
除去後の単語数: 7
このように、「This」「is」「a」「how」「in」といった単語が除去され、文章の意味を構成する主要な単語だけが残っていることがわかります。
SEOにおけるストップワードの影響
検索エンジン最適化(SEO)の観点からも、ストップワードの概念を理解しておくことは有益です。
かつての検索エンジンは、ストップワードを完全に無視してインデックスを作成していましたが、現在のGoogleなどの高度な検索エンジンは、文脈を理解するためにこれらの単語を柔軟に扱っています。
検索エンジンの進化と文脈理解
以前は「ストップワードはSEOに悪影響を与えるので削除すべき」と言われた時代もありました。
しかし、現在の検索エンジンは「BERT」などのAI技術を活用し、単語同士のつながりやニュアンスを読み取るようになっています。
そのため、無理にストップワードを排除して不自然な文章にする必要はありません。
むしろ、読者にとって読みやすく、自然な文脈を維持することが現在のSEOでは最も重要視されます。
URL(パーマリンク)設計における活用
記事のURLを決定する際、英語のタイトルをベースにする場合はストップワードを意識することが推奨されます。
URLが長すぎると、SNSでの共有時や検索結果画面で見づらくなる可能性があるからです。
例えば、「How to optimize your website for search engines」というタイトルであれば、URLは「optimize-website-search-engines」のように、意味を持つ単語に絞るのが一般的です。
このようにストップワードを削ることで、URLが短く、かつ内容が伝わりやすいものになります。
キーワード密度とストップワードの関係
一昔前のSEOでは、特定のキーワードの含有率(キーワード密度)が重要視されていました。
ストップワードが多すぎると相対的にキーワード密度が下がると考えられていましたが、現在のアルゴリズムでは、そのような単純な計算は行われていません。
Googleは、ページ全体のトピックや網羅性を評価しているため、ストップワードの多寡を気にするよりも、コンテンツの質を高めることに注力すべきです。
代表的なストップワードの具体例
ストップワードは、言語や使用するツールによってリストが異なります。
ここでは、代表的な日本語と英語のストップワードの例を比較してみましょう。
| 言語 | 分類 | 具体的なストップワードの例 |
|---|---|---|
| 日本語 | 助詞・助動詞 | は、が、の、に、を、と、も、た、です、ます |
| 日本語 | 頻出動詞・名詞 | する、ある、こと、もの、これ、それ |
| 英語 | 冠詞・代名詞 | a, an, the, I, you, he, she, it, they |
| 英語 | 前置詞・接続詞 | in, on, at, by, for, and, but, or |
| 共通 | 記号・数字 | !, ?, ., ,, 0, 1, 2, 3 |
日本語におけるストップワードの難しさ
日本語は英語と異なり、単語の間にスペースが入らない「膠着語(こうちゃくご)」という特徴を持っています。
そのため、ストップワードを除去する前に「形態素解析」を行い、文章を単語単位に分割する必要があります。
日本語の解析ツールである「MeCab」や「Janome」では、品詞情報に基づいて特定の助詞を一括で除外するといった処理が一般的です。
ストップワードを扱う際の注意点
ストップワードの除去は便利ですが、機械的に行いすぎると問題が生じる場合もあります。
場合によっては、ストップワードそのものが重要な意味を持つケースがあるからです。
文脈やニュアンスの喪失
有名なシェイクスピアの台詞「To be, or not to be」からストップワードを除去すると、ほとんど何も残らなくなってしまいます。
「To」「be」「or」「not」はすべて典型的なストップワードですが、これらを除くとこのフレーズの哲学的な意味が完全に失われます。
また、「Apple and Orange」と「Apple or Orange」では、意味が正反対になりますが、「and」や「or」を除去してしまうと区別がつきません。
特定の業界用語や固有名詞
一般的なストップワードリストに含まれている単語が、特定の業界では重要なキーワードであることもあります。
例えば、プログラミング分野における「Go」や「R」といった言葉は、一般的な文章ではストップワードになり得ますが、技術解説記事では欠かせない主役となります。
そのため、解析を行う対象のドメイン(分野)に合わせて、独自のストップワードリストを作成することが求められる場面も少なくありません。
ストップワードを最適に管理する方法
ストップワードの処理を最適化するには、標準的なリストをベースに、独自のカスタマイズを加えるのがベストです。
最近の検索エンジンやAI技術では、単語を単体で見るのではなく、周囲の単語との関係性を捉える「コンテキスト解析」が主流になっています。
最新のNLPモデルとストップワード
近年の「Transformer」をベースとした言語モデル(GPTシリーズなど)では、あえてストップワードを除去せずに学習を行うことが増えています。
これは、ストップワードが持つ微細なニュアンスも、AIが文章の意図を汲み取るために役立つからです。
一方で、従来の全文検索エンジン(Elasticsearchなど)で高速な検索を実現したい場合には、依然としてストップワード設定のチューニングが効果を発揮します。
ユーザー体験(UX)を優先したライティング
SEOの観点でも、AIの観点でも、最終的に重要視されるのは「人間にとっての分かりやすさ」です。
特定の単語がストップワードだからといって無理に削ったり、逆にキーワードを詰め込みすぎたりするのは得策ではありません。
自然な日本語として成立しており、読者の悩みや疑問を解決できるコンテンツであれば、ストップワードの有無が検索順位に致命的な悪影響を与えることはありません。
まとめ
ストップワードは、コンピュータが効率的に文章を処理するために定義された、いわば「裏方の単語たち」です。
自然言語処理の分野では、データの軽量化やノイズ削減に大きく貢献しており、欠かせない工程の一つとなっています。
一方で、SEOの文脈では、検索エンジンの進化によって「ストップワードを極端に排除する」必要性は薄れてきました。
しかし、URLのデザインや大規模データの解析など、専門的な分野では今でも非常に重要な概念です。
ストップワードの特性を正しく理解し、文脈を損なわない程度に適切に制御することが、技術的な最適化とユーザーフレンドリーな情報発信を両立させる鍵となります。