近年のAI(人工知能)技術、特にコンピュータビジョンの分野において、画像内の物体を精緻に認識する技術は飛躍的な進化を遂げています。
私たちが日常的に利用しているスマートフォンのカメラアプリや、自動運転技術、製造業における検品作業など、その応用範囲は枚挙にいとまがありません。
こうした画像認識技術の中でも、現在最も注目を集めている高度な手法の一つが「インスタンスセグメンテーション」です。
本記事では、インスタンスセグメンテーションの基本的な定義から、類似技術であるセマンティックセグメンテーションとの違い、さらには代表的なアルゴリズムや具体的な活用事例までを詳しく解説します。
画像認識の導入を検討されている方や、ディープラーニングの基礎知識を深めたい方にとって、有益な情報をお届けします。
インスタンスセグメンテーションとは何か
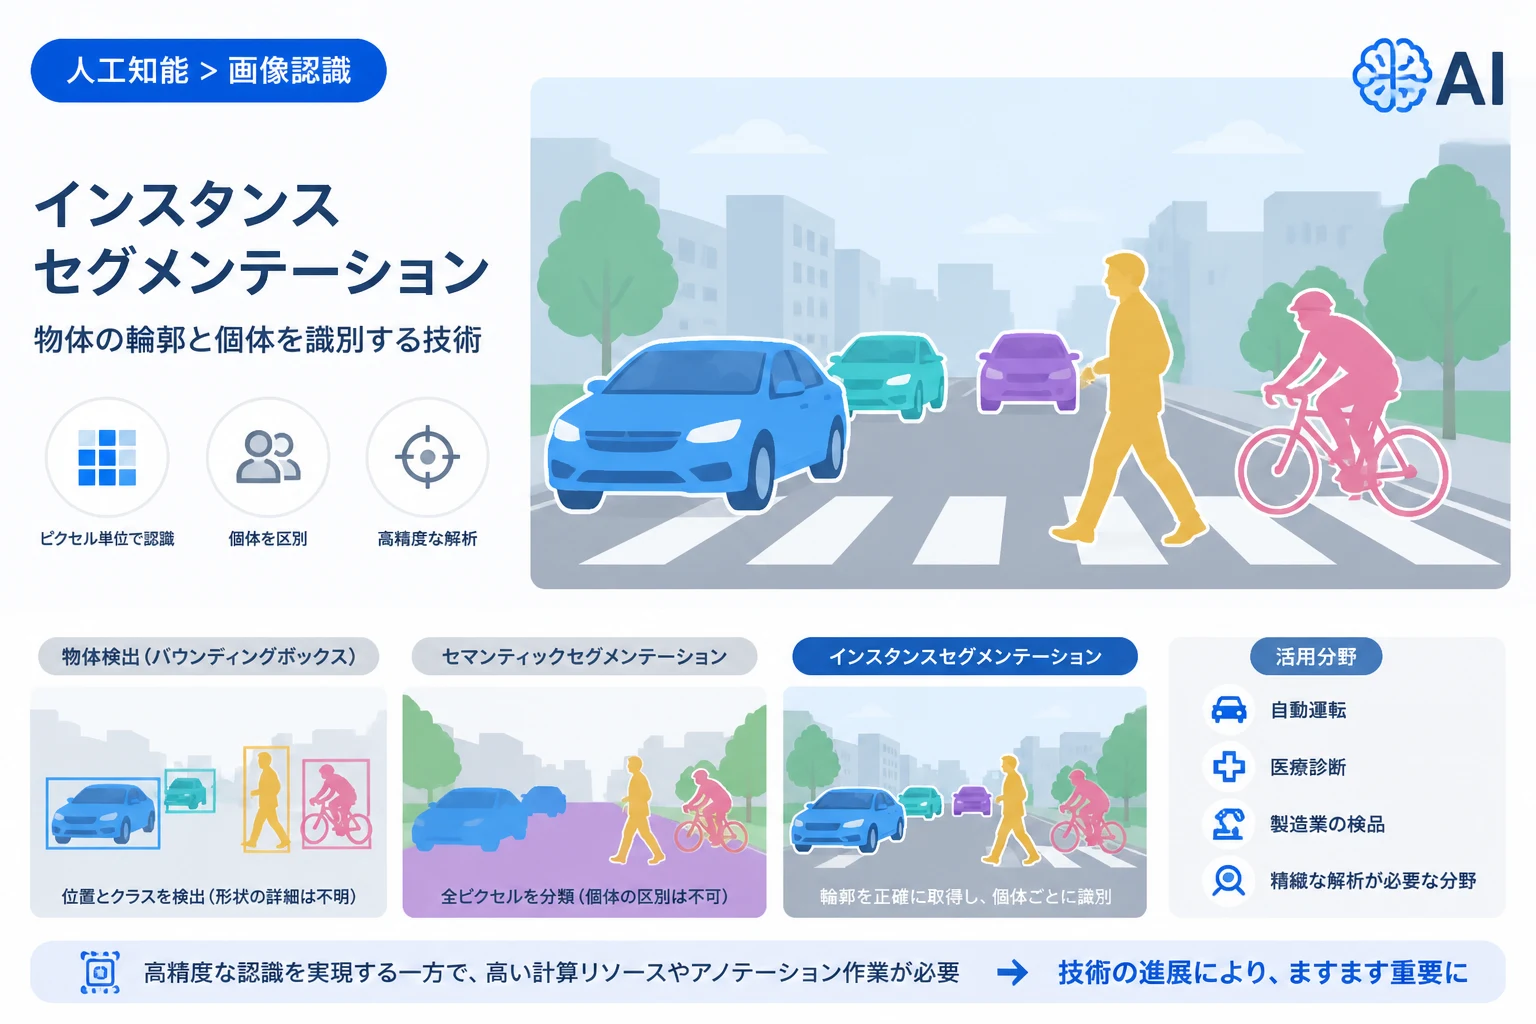
インスタンスセグメンテーション(Instance Segmentation)とは、画像に含まれる個々の物体(インスタンス)を検出し、かつピクセル単位で領域を特定する技術を指します。
この技術は、物体が「どこにあるか」を特定する物体検出と、画像内の全ピクセルが「何に属するか」を分類するセマンティックセグメンテーションの両方の特徴を併せ持っています。
従来の物体検出では、物体を四角い枠(バウンディングボックス)で囲むことで位置を示してきましたが、これでは物体の正確な形状までは把握できませんでした。
一方で、インスタンスセグメンテーションは、物体の複雑な輪郭を正確にトレースすることができるため、より高度な解析が可能となります。
例えば、複数の人物が重なり合って写っている画像において、一人ひとりの境界線を明確に区別して認識できるのがこの技術の最大の特徴です。
「個別の個体を識別しつつ、その形を細密に切り出す」という難易度の高いタスクを実現しているのが、インスタンスセグメンテーションなのです。
セマンティックセグメンテーションや物体検出との違い
インスタンスセグメンテーションを正しく理解するためには、混同されやすい他の画像認識手法との違いを明確にする必要があります。
主要な手法である「物体検出」「セマンティックセグメンテーション」、そして今回のテーマである「インスタンスセグメンテーション」の3つの違いについて解説します。
物体検出(Object Detection)
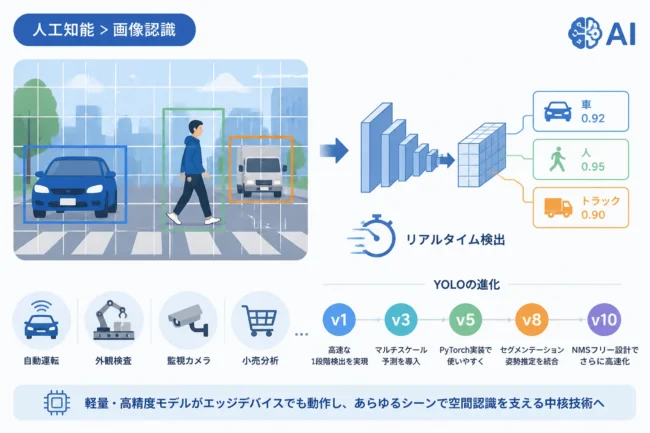
物体検出は、画像の中に「何が」「どこに」あるかを特定する技術です。
対象物をバウンディングボックスと呼ばれる矩形で囲み、その中身が「犬」や「車」であるといったクラスラベルを付与します。
実装が比較的容易で処理速度も速いというメリットがありますが、物体が斜めを向いていたり、複雑な形をしていたりする場合でも四角い枠でしか捉えられないという限界があります。
セマンティックセグメンテーション(Semantic Segmentation)
セマンティックセグメンテーションは、画像の全ピクセルに対して「どのカテゴリーに属するか」をラベル付けする手法です。
例えば、道路の風景画像があれば、「道路」「空」「建物」「歩行者」といった具合にピクセル単位で色分けを行います。
しかし、セマンティックセグメンテーションには、「同じ種類の物体を区別できない」という特性があります。
複数の歩行者が重なっていても、それらはすべて一つの「歩行者」という塊として処理されてしまいます。
インスタンスセグメンテーション(Instance Segmentation)
インスタンスセグメンテーションは、前述の2つの手法の「いいとこ取り」をした技術と言えます。
ピクセル単位での分類を行いながら、個々の物体(インスタンス)を別々の個体として識別します。
これにより、同じ「車」であっても「車A」「車B」「車C」と個別に分離して認識することが可能になります。
| 手法名 | 認識の単位 | 個体の識別 | 形状の把握 |
|---|---|---|---|
| 物体検出 | 矩形(四角枠) | 可能 | 不可(大まか) |
| セマンティックセグメンテーション | ピクセル | 不可 | 可能(精緻) |
| インスタンスセグメンテーション | ピクセル | 可能 | 可能(精緻) |
インスタンスセグメンテーションを支える主要なアルゴリズム
インスタンスセグメンテーションを実現するためには、高度なディープラーニングモデルが必要です。
ここでは、研究や実務で広く利用されている代表的なアルゴリズムを紹介します。
Mask R-CNN
Mask R-CNNは、インスタンスセグメンテーションの代表的な手法であり、物体検出の傑作モデルであるFaster R-CNNを拡張したものです。
物体を検出するネットワークに、「マスクブランチ」と呼ばれる各ピクセルを分類する経路を追加した構造を持っています。
「RoIAlign」という技術を導入することで、特徴マップと元の画像の微細な位置ずれを解消し、非常に精度の高いセグメンテーションを実現しました。
現在でも多くのプロジェクトでベースラインとして採用される、信頼性の高いモデルです。
YOLACT (You Only Look At CoefficienTs)
YOLACTは、リアルタイム性を重視したインスタンスセグメンテーションの手法です。
従来のMask R-CNNなどは処理が重く、動画に対してリアルタイムで適用することが困難でした。
YOLACTは、画像を一度だけネットワークに通すことで結果を得るシングルショット形式を採用しており、高いフレームレート(FPS)での動作が可能です。
精度と速度のバランスが優れているため、監視カメラの映像解析やロボットの視覚システムなどに適しています。
SOLO (Segmenting Objects by Locations)
SOLOは、物体の「位置」と「サイズ」に基づいて直接インスタンスを割り当てる、比較的新しいアプローチのアルゴリズムです。
従来の多くの手法がバウンディングボックスを前提としていたのに対し、SOLOはボックスを使わずにセグメンテーションを行う点が特徴です。
パイプラインが非常にシンプルになるため、実装が容易であり、将来性が期待されているモデルの一つです。
インスタンスセグメンテーションの具体的な活用事例
この技術は、物体の形状を精緻に捉え、かつ個体を識別できるという特性から、多岐にわたる産業分野で活用されています。
自動運転・高度運転支援システム
自動運転において、インスタンスセグメンテーションは欠かせない技術です。
車両の前方にいる「歩行者」が一人なのか二人なのか、あるいは自転車がどの方向を向いているのかを正確に把握する必要があります。
単なる物体検出よりも詳細に周囲の状況を把握することで、安全な回避ルートの策定や、ブレーキタイミングの最適化が可能になります。
医療画像診断
医療分野では、MRIやCTスキャンの画像から腫瘍の形状を特定したり、個々の細胞をカウントしたりするために利用されます。
セマンティックセグメンテーションでは、隣接する細胞が一つに繋がって見えてしまうことがありますが、インスタンスセグメンテーションなら個別に分離して解析できます。
これにより、病変の進行具合をピクセル単位の体積として算出し、より正確な診断をサポートすることができます。
製造業における外観検査とピッキング
工場の生産ラインでは、製品の傷や汚れを検知する外観検査に導入されています。
また、バラ積みされた部品をロボットアームで掴み上げる「ランダムピッキング」においても、この技術が威力を発揮します。
重なり合った部品の中から、今どの個体を掴むべきか、その端点はどこにあるかを正確に指示することができるためです。
農業技術(スマート農業)
農業分野では、農作物の収穫時期の判定や、害虫の個体数調査に活用されています。
例えば、果樹園で実っているリンゴの数とそれぞれの大きさを瞬時に測定し、収穫量を予測することが可能です。
個体ごとの形状を把握することで、品質のばらつきを自動でランク分けするシステムも開発されています。
インスタンスセグメンテーションを導入する際の課題
非常に強力なインスタンスセグメンテーションですが、導入にあたってはいくつかのハードルが存在します。
アノテーションコストの増大
AIモデルを学習させるためには、教師データと呼ばれる正解ラベル付きの画像が大量に必要です。
インスタンスセグメンテーションの場合、画像内のすべての対象物の輪郭をピクセル単位でなぞる「ポリゴンアノテーション」を行わなければなりません。
これは四角い枠で囲むだけの物体検出用アノテーションに比べ、数倍から数十倍の作業時間を要します。
高品質なデータセットを作成するための人件費や外注費が、プロジェクト全体のコストを押し上げる要因となります。
高い計算リソース(GPU)の要求
ピクセル単位での計算を行うため、推論時および学習時の負荷が非常に高くなります。
リアルタイムで動作させるためには、高性能なGPU(画像処理装置)を搭載したサーバーやエッジデバイスが必要です。
ハードウェアのコストや、消費電力の問題を考慮したシステム設計が求められます。
小さな物体や重なりの激しい物体の認識
技術が進化しているとはいえ、極端に小さな物体や、物体の大部分が他の物体に隠れている(オクルージョン)場合の認識精度は依然として課題です。
こうしたケースでは、モデルのチューニングや、撮影環境(照明やカメラの角度)の工夫が必要になることがあります。
インスタンスセグメンテーションの学習を始めるには
実際にインスタンスセグメンテーションを体験・実装してみたい場合、まずはPythonと言語に対応したライブラリを利用するのが一般的です。
Googleが提供する「Colaboratory」などのクラウド環境を使えば、高価なGPUを持っていなくても試すことができます。
以下は、代表的なライブラリであるDetectron2を使用してモデルをロードする際のイメージコードです。
# Detectron2を用いたインスタンスセグメンテーションのセットアップ例
import detectron2
from detectron2.utils.logger import setup_logger
setup_logger()

# 必要なモジュールのインポート
from detectron2 import model_zoo
from detectron2.engine import DefaultPredictor
from detectron2.config import get_cfg

# 設定の構成
cfg = get_cfg()
# 学習済みモデル(Mask R-CNN)の指定
cfg.merge_from_file(model_zoo.get_config_file("COCO-InstanceSegmentation/mask_rcnn_R_50_FPN_3x.yaml"))
cfg.MODEL.ROI_HEADS.SCORE_THRESH_TEST = 0.5  # 検出のしきい値
cfg.MODEL.WEIGHTS = model_zoo.get_checkpoint_url("COCO-InstanceSegmentation/mask_rcnn_R_50_FPN_3x.yaml")
cfg.MODEL.DEVICE = "cuda" # GPUを使用

# 推論器の作成
predictor = DefaultPredictor(cfg)
このように、現在は高度なモデルがオープンソースとして公開されているため、比較的短期間でプロトタイプを作成することが可能です。
まずは公開されているデータセット(COCOデータセットなど)を使って、どのような出力が得られるかを確認することから始めると良いでしょう。
まとめ
インスタンスセグメンテーションは、画像内の個々の物体をピクセル単位で正確に識別し、切り出すことができる非常に高度な技術です。
セマンティックセグメンテーションでは不可能だった「個体の区別」を可能にすることで、自動運転、医療、製造業といった多岐にわたる分野でイノベーションを起こしています。
導入には、膨大なアノテーションコストや高い計算リソースが必要という課題もありますが、モデルの軽量化や自動アノテーションツールの進化により、そのハードルは年々下がりつつあります。
「何が、どこに、どのような形で、いくつあるのか」を完璧に把握したい場合、インスタンスセグメンテーションは最良の選択肢となるでしょう。
今後、エッジAIの普及やアルゴリズムのさらなる洗練により、私たちの身の回りのあらゆるデバイスにこの技術が組み込まれていくことは間違いありません。
この機会に、画像認識技術の可能性を広げるインスタンスセグメンテーションの活用を検討してみてはいかがでしょうか。