YOLO(You Only Look Once)は、画像や動画に映る物体を、その位置と種類とともにリアルタイムで識別する物体検出アルゴリズムです。
従来の手法が画像を複数回にわたって解析するのに対し、YOLOは名前のとおり、画像を一度だけ見て瞬時に判断する点が画期的でした。
この唯一無二のアプローチにより、監視カメラや自動運転といった、遅延が許されない領域での実用化が急速に進んでいます。
YOLOの基本的な仕組みと特徴
「一度だけ見る」という革新的な発想
物体検出の初期の方法では、画像の中を小さな窓(スライディングウィンドウ)で走査し、その領域に物体があるかどうかを分類器で判定していました。
しかし、この方法では画像のあらゆる位置と大きさを網羅的に調べる必要があり、計算量が爆発的に増加してしまいます。
そこに登場したYOLOは、物体検出を単一の回帰問題として定式化しました。
つまり、入力画像から、物体のバウンディングボックス(領域)とクラス(種類)を同時に、かつ一度のネットワーク通過で予測するのです。
グリッド分割と予測のメカニズム
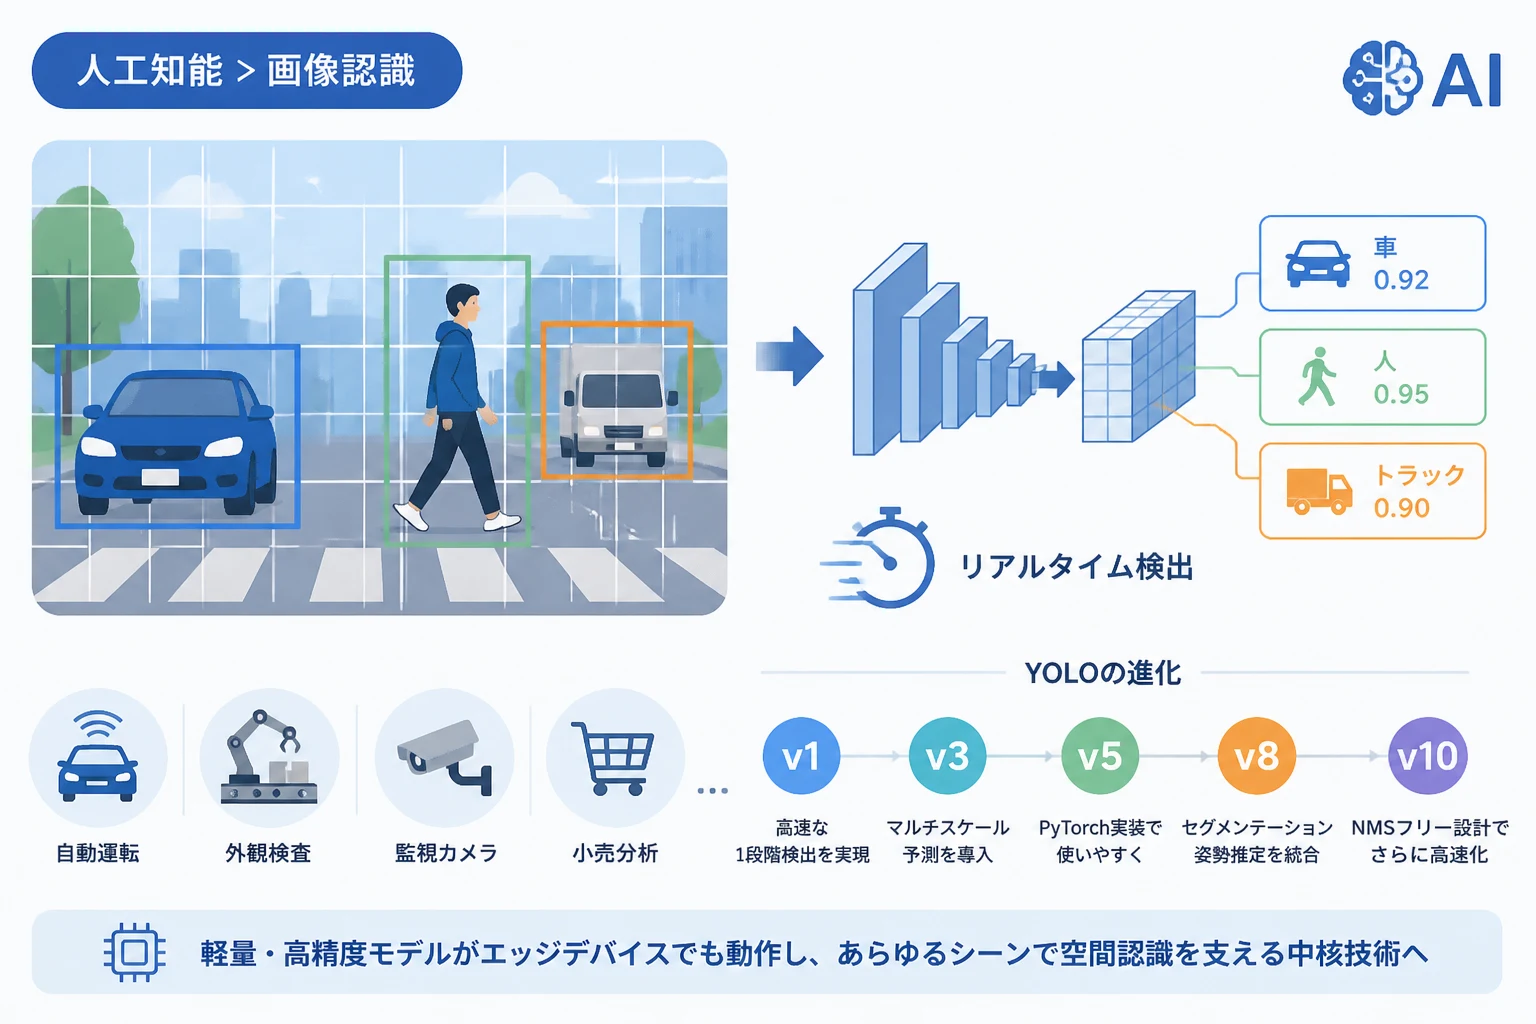
YOLOはまず、入力画像をあらかじめ決められた数のグリッド(例えば7×7のマス目)に分割します。
それぞれのグリッドセルは、物体の中心がそのセル内にある場合、その物体の検出を担当します。
各グリッドセルは、担当領域から複数のバウンディングボックスの座標(x, y, width, height)と、そこに物体が存在する確信度を予測します。
同時に、そのグリッドセルが「車」や「人」など、どのクラスの物体を捉えているかの条件付き確率も出力します。
最終的な検出結果は、これらの「確信度」と「クラス確率」を掛け合わせることで算出されます。
従来のR-CNNファミリーとの決定的な違い
- 2段階検出器(R-CNNシリーズ): まず物体がありそうな領域候補(Region Proposal)を抽出し、次にその領域だけを分類機にかけます。精度は高いものの、構造上、推論に時間がかかります。
- 1段階検出器(YOLO): 領域候補の抽出を省略し、位置特定と分類を一気に行います。そのため、フレームレートが格段に高く、動画のリアルタイム処理に最適です。
YOLOは背景を物体と誤認するケースが少ない点も利点です。
なぜなら、小さな領域だけでなく、画像全体のコンテキスト(文脈)を見ながら学習するため、背景を物体の一部と誤解しにくいからです。
YOLOの進化とバージョンごとの改善点
YOLOは2015年の初登場以来、現在に至るまで改良が重ねられ、物体検出の最前線を走り続けています。
YOLOv1からv3: アーキテクチャの原点と精度の飛躍
最も初期のYOLOv1は、リアルタイム性こそ革命的でしたが、小さな物体や密集した物体を検出する精度に限界がありました。
続くYOLOv2では、Batch Normalizationやアンカーボックスの概念を導入し、物体の形状のバリエーションに対する予測の柔軟性が格段に向上しています。
YOLOv3では、Darknet-53というより深いネットワークと、異なるスケールの特徴マップから予測を行うFeature Pyramid Networkのような仕組みを採用し、大小さまざまなサイズの物体検出精度を大幅に改善しました。
YOLOv4からv7: 多様化する派生モデルと最適化
YOLOv4以降、開発の方向性はより多様化し、さまざまな派生モデルが生まれました。
YOLOv4は、CSPDarknetやPANet、Mish活性化関数などの先端技術を統合し、単一のGPUで学習可能な範囲で最高の性能を追求しています。
YOLOv5はUltralytics社によってリリースされ、PyTorchで実装された手軽さからコミュニティで爆発的に普及しました。
YOLOv6やYOLOv7では、モデルの再パラメータ化や効率的な学習戦略を通じて、産業応用に耐えうるさらなる高速化と高精度化が実現されています。
YOLOv8から最新バージョン: 統合フレームワークへの進化
現在、YOLOは単なる物体検出モデルから、マルチタスクAIフレームワークへと進化しています。
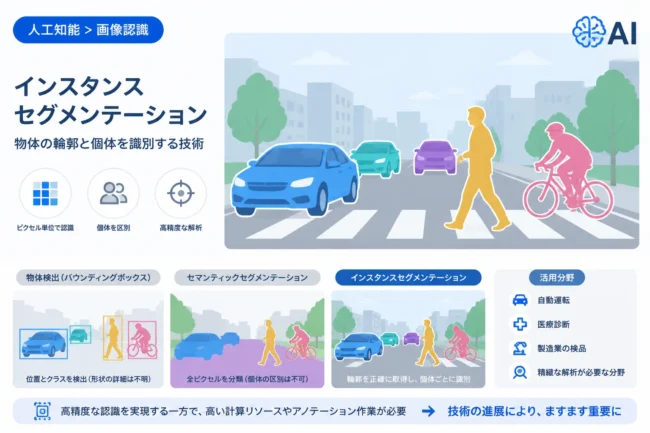
Ultralytics YOLOv8は、物体検出だけでなく、インスタンスセグメンテーションや姿勢推定、分類までを統一されたAPIで実行できます。
直近のYOLOv9は、深層ネットワーク内の情報損失を防ぐProgrammable Gradient Information (PGI) を提案し、軽量モデルでも高い情報保持能力を示しました。
最新のYOLOv10は、NMS(非最大抑制)を必要としない新しいラベル割り当て戦略を導入し、ポストプロセスにかかっていたオーバーヘッドを劇的に削減しています。
| モデル名 | リリース年(概算) | 主な貢献・特徴 |
|---|---|---|
| YOLOv1 | 2015 | 物体検出の単一ネットワーク回帰への定式化、リアルタイム性の実証 |
| YOLOv2 | 2016 | Batch Normalization、アンカーボックス、解像度の柔軟な変更 |
| YOLOv3 | 2018 | Darknet-53、マルチスケール予測による小さな物体の精度向上 |
| YOLOv4 | 2020 | CSPDarknet、Mish活性化関数、データ拡張のバッグ・オブ・フリービー |
| YOLOv5 | 2020 | PyTorch実装による開発者体験の向上、広範なコミュニティ流入 |
| YOLOv7 | 2022 | E-ELAN等の拡張効率的層集約ネットワーク、学習効率の最適化 |
| YOLOv8 | 2023 | アンカーフリー機構、セグメンテーション/姿勢推定の統合API |
| YOLOv9 | 2024 | Programmable Gradient Information (PGI) とGELANによる情報損失回避 |
| YOLOv10 | 2024 | NMSフリー設計によるエンドツーエンド推論のさらなる高速化 |
YOLOの実践的な応用例
YOLOの高速かつ正確な特性は、現代社会のさまざまな領域で不可欠な要素となっています。
自動運転と高度運転支援システム
走行中、クルマは歩行者、信号、他車両、標識を瞬時に見分けなければなりません。
YOLOは、一瞬の判断遅延が重大な事故につながるこの領域で、ミリ秒単位の推論を実現します。
事実、多くの自動車メーカーや研究機関が、カメラ映像からの周辺環境認識モジュールにYOLOベースのモデルを採用しています。
製造業における外観検査
工場の生産ラインでは、高速で流れる製品の微小な傷や異物混入を目視でチェックするのは困難です。
YOLOは高解像度カメラからのフィードに対し、リアルタイムで異常箇所を検出します。
これにより、人的ミスを減らすとともに、全ての製品を均一な基準で検査できるようになります。
スマートリテールと人流解析
店舗に設置したカメラ映像から、YOLOを用いて顧客の動線を分析することで、商品配置の最適化や混雑状況の可視化が可能です。
商品棚を撮影した画像からは、どの商品が売り切れそうなのか(欠品検知)をリアルタイムに把握し、機会損失を防ぐことにも役立っています。
このような活用において、個人を特定できる顔情報ではなく、身体全体を物体として匿名で検出できる点も、プライバシー配慮の観点から重要です。
セキュリティと監視カメラ
監視カメラの映像から不審物や危険行為、侵入者を即座に検知するためにYOLOは最適です。
従来のモーション検知と異なり、動いていない放置物や、特定の形状を持つ物体(たとえばナイフ)を静止画のフレーム単位で発見できます。
これにより、セキュリティ担当者の負担を大幅に軽減し、プロアクティブな警備を実現します。
まとめ
YOLOは、「物体検出をいかにシンプルかつ高速にするか」という問いに対し、たった一度の推論で答えることで、コンピュータビジョンの現実世界への応用を加速させました。
初代モデルの登場から、姿勢推定やセグメンテーションまでこなすマルチタスクモデルへと至るその進化は、学術研究の進歩とオープンソースコミュニティの熱意が結実した好例といえます。
NMSフリー設計やエッジデバイスへの最適化といった技術動向が示すとおり、YOLOは今後もAIによるリアルタイム空間認識の中核技術として、進化を続けていくことは間違いありません。