インデックスレジスタ(指標レジスタ)は、コンピュータのCPU(中央演算処理装置)内部に存在する、メモリアドレスの計算を補助するための非常に重要なレジスタです。
現代の計算機アーキテクチャにおいて、効率的なデータ処理を実現するためには、メモリ上のデータへいかに素早くアクセスできるかが鍵となります。
このインデックスレジスタを活用することで、プログラムは配列のような連続したデータ構造に対して、柔軟かつ高速なアクセスを行うことが可能になります。
本記事では、インデックスレジスタの基本的な概念から、実際の計算の仕組み、さらにはプログラミングにおける役割までを詳しく解説していきます。
インデックスレジスタ(指標レジスタ)の定義と基本概念
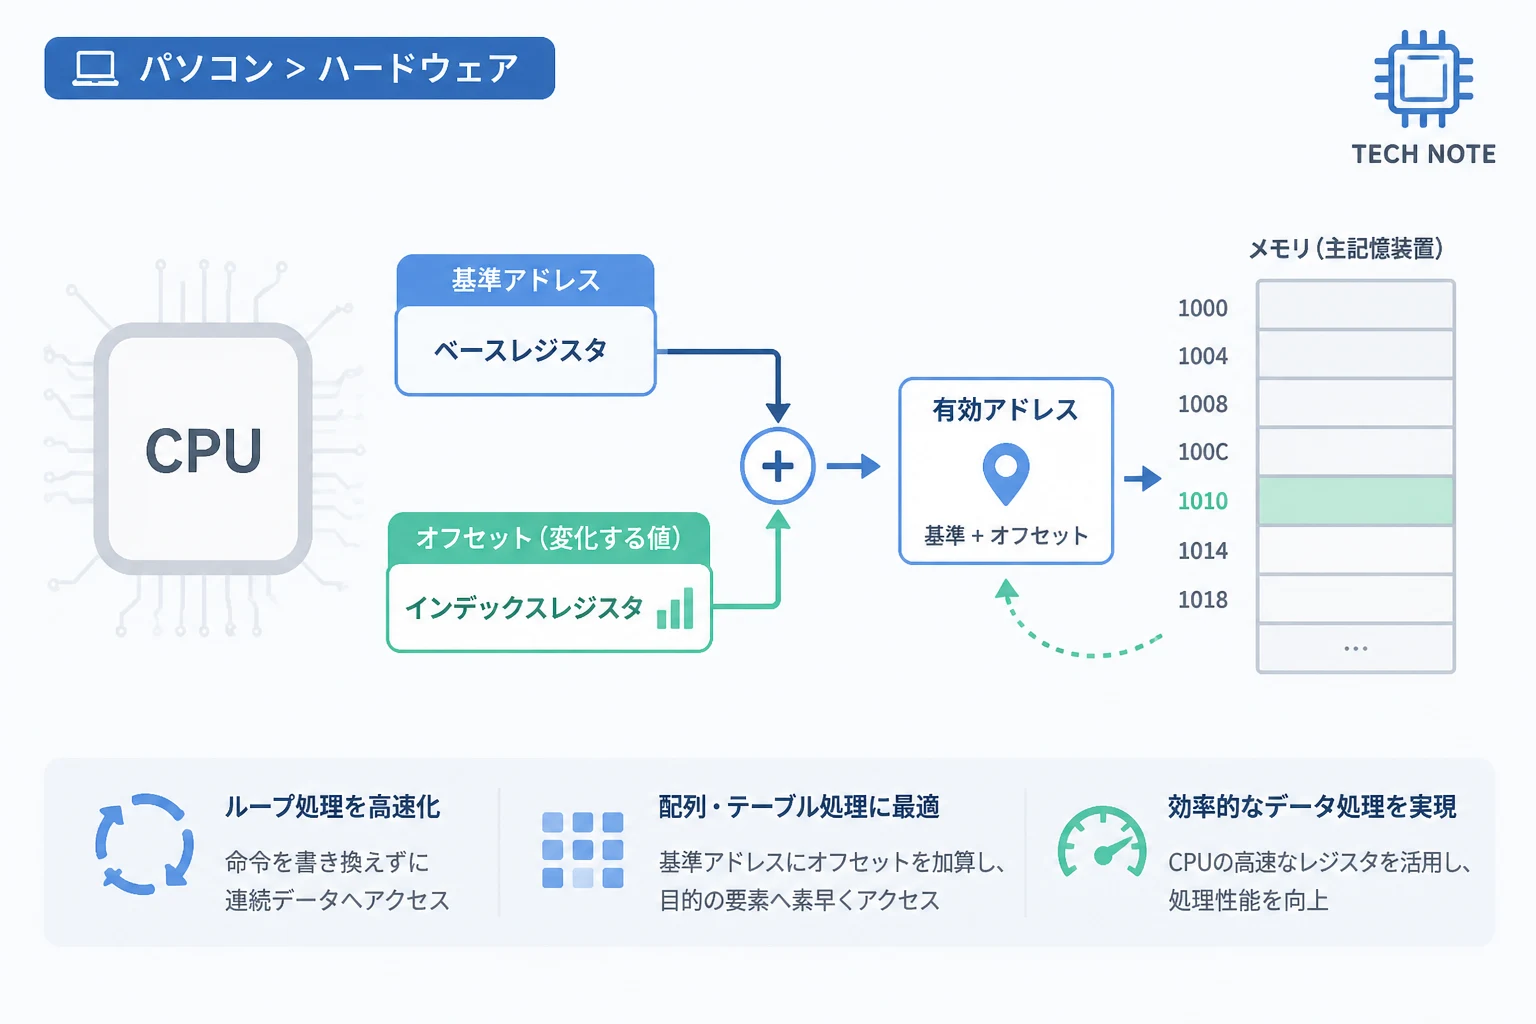
インデックスレジスタとは、CPUがメモリ上のデータを参照する際に、そのアドレス(所在)を動的に補正するために使用される特殊なレジスタのことです。
一般的に、CPUが特定のデータにアクセスするためには、そのデータが格納されているメモリの番地を指定する必要があります。
しかし、プログラム実行中に扱うデータのアドレスは、常に一定であるとは限りません。
例えば、大量の数値が並んでいる「配列」を処理する場合、データの先頭アドレスに加えて、「何番目のデータか」というオフセット情報が必要になります。
この「何番目か」という数値を保持し、基準となるアドレスに加算する役割を担うのが、インデックスレジスタ(指標レジスタ)です。
レジスタの役割とCPU内部での立ち位置
レジスタとは、CPUの内部にある非常に高速な記憶領域の総称です。
メインメモリ(RAM)と比較しても、レジスタへのアクセス速度は桁違いに速いという特徴があります。
インデックスレジスタは、こうした高速な記憶領域の中でも、特にアドレス計算の「指標(インデックス)」となる値を保持するために特化したものです。
プロセッサの種類によっては、汎用レジスタがこの役割を兼ねることもあれば、専用のインデックスレジスタ(例:x86アーキテクチャにおけるSIやDI)を持つこともあります。
指標アドレス指定(インデックスアドレッシング)の仕組み
インデックスレジスタを用いたアドレス計算の方式を、「指標アドレス指定(インデックスアドレッシング)」と呼びます。
この仕組みを理解することで、CPUがいかにして効率的にループ処理や配列演算を行っているかが見えてきます。
有効アドレスの計算方法
CPUが実際にアクセスする最終的なメモリアドレスのことを「有効アドレス(Effective Address)」と呼びます。
インデックスアドレッシングでは、命令コードの中に含まれる「基準アドレス」に、インデックスレジスタの値を足し合わせることで有効アドレスを算出します。
数式で表すと、「有効アドレス = 命令で指定されたアドレス + インデックスレジスタの内容」という単純な加算になります。
この仕組みがあるおかげで、命令自体を書き換えることなく、レジスタの値を更新するだけで異なるメモリアドレスを参照できるようになります。
具体例として、100番地から始まる配列データを順番に読み取るシーンを想像してみてください。
インデックスレジスタの値を0, 1, 2…とカウントアップしていくだけで、100番地、101番地、102番地と順次アクセスすることが可能になります。
オートインクリメントとスケーリング
高度なCPUでは、インデックスレジスタの値を読み取った後に自動で値を増減させる「オートインクリメント/デクリメント機能」を備えているものもあります。
また、データの型(整数なら4バイト、浮動小数点なら8バイトなど)に合わせて、レジスタの値を自動的に定数倍して加算する「スケーリング機能」も存在します。
これにより、プログラマは低レイヤーの計算を意識することなく、高速なメモリ操作を実現できます。
インデックスレジスタとベースレジスタの違い
アドレス計算に使われるレジスタには、インデックスレジスタのほかに「ベースレジスタ」というものが存在します。
両者は非常に似ていますが、コンピュータアーキテクチャ上の設計思想や用途には明確な違いがあります。
| 比較項目 | ベースレジスタ | インデックスレジスタ |
|---|---|---|
| 主な役割 | プログラムやデータの開始地点(基点)を指す | 基点からの移動量(オフセット)を指す |
| 値の変化 | プログラム実行中は固定されることが多い | ループ処理などで頻繁に値が更新される |
| 主な用途 | セグメントの管理、再配置可能プログラムの実現 | 配列アクセス、文字列処理、繰り返し演算 |
ベースレジスタは、プログラムがメモリ上のどこに配置されても正しく動くようにするための「基準点」を保持するのが一般的です。
それに対してインデックスレジスタは、特定のデータ集合の中を動き回るための「指針」として機能します。
現代のx86_64アーキテクチャなどでは、どちらのレジスタも汎用的に使えるようになっていますが、歴史的な背景や特定の命令セットにおいては、この使い分けが厳格に定められていました。
プログラミングにおけるインデックスレジスタの恩恵
私たちがC言語やJavaなどの高級言語でプログラムを書く際、インデックスレジスタを直接意識することはほとんどありません。
しかし、コンパイラがソースコードを機械語に変換する際、インデックスレジスタはフル活用されています。
例えば、以下のような配列処理のループを考えてみましょう。
int array[5] = {10, 20, 30, 40, 50};
int sum = 0;
for (int i = 0; i < 5; i++) {
    sum += array[i]; // ここでインデックスレジスタが活躍する
}
このコードをコンパイラがアセンブリ言語に変換すると、変数 i の値がインデックスレジスタに割り当てられます。
CPUは、array の先頭アドレスにインデックスレジスタの値を加算し、メモリからデータを取り出し続けます。
もしインデックスレジスタがなければ、CPUはループのたびに「次にアクセスすべきメモリアドレス」を複雑な手順で再計算しなければならず、処理速度が大幅に低下してしまいます。
このように、インデックスレジスタは「ソフトウェアの反復処理をハードウェアレベルで高速化する仕組み」と言い換えることもできます。
現代のプロセッサにおけるインデックスレジスタの進化
初期のマイクロプロセッサでは、レジスタの数が非常に限られており、インデックスレジスタは「貴重な専用リソース」でした。
しかし、RISC(精選命令セットコンピュータ)の登場や、x86の64ビット化(x64)を経て、レジスタの性質は大きく変化しました。
汎用レジスタへの統合
現代の多くのCPUでは、特定の用途に縛られない「汎用レジスタ」の数が増加しています。
その結果、どの汎用レジスタであっても、命令の中でインデックスレジスタとして指定できるようになりました。
これにより、コンパイラの最適化の幅が広がり、より効率的なコード生成が可能になっています。
SIMD命令とインデックスアクセス
さらに、ベクトル演算を行うSIMD(Single Instruction, Multiple Data)の領域でも、インデックスの概念は重要です。
「ギャザー(Gather)」と呼ばれる操作では、複数のインデックスレジスタの値を用いて、メモリのあちこちに散らばったデータを一度にレジスタへ集めることができます。
インデックスレジスタの仕組みは、単なる「足し算によるアドレス計算」を超えて、より高度な並列処理を支える基盤へと進化を遂げているのです。
インデックスレジスタを学ぶ重要性
ハードウェアの抽象化が進んだ現代において、なぜインデックスレジスタのような低レイヤーの知識が必要なのでしょうか。
それは、システムのボトルネックを理解し、真に効率的なアルゴリズムを設計するためには、CPUの振る舞いを知ることが不可欠だからです。
例えば、配列の要素を順番にアクセスする「シーケンシャルアクセス」がなぜ速いのかという問いに対し、インデックスレジスタとキャッシュメモリの仕組みから説明できるようになります。
また、組み込みシステムやデバイスドライバの開発など、リソースが制限された環境では、レジスタを直接操作することで極限のパフォーマンスを引き出す技術が求められます。
インデックスレジスタの理解は、コンピュータアーキテクチャの奥深さに触れる第一歩となるでしょう。
まとめ
インデックスレジスタ(指標レジスタ)は、CPUがメモリ上のデータへアクセスする際、基準となるアドレスに「オフセット(ズレ)」を加算するために用いられる重要なレジスタです。
配列や構造体といったデータ構造を効率的に扱うために欠かせない存在であり、プログラムのループ処理を高速化する大きな役割を果たしています。
ベースレジスタがプログラムの「基点」を管理するのに対し、インデックスレジスタはデータ集合の中での「位置」を柔軟に指し示すための道具です。
現代のCPUでは汎用レジスタに統合される傾向にありますが、その基本的な仕組みやアドレッシングの概念は、今なおコンピュータの根幹を支え続けています。
この記事を通じて、インデックスレジスタが持つ「アドレス計算を動的に行う力」とその重要性を再確認していただければ幸いです。
CPUの内部構造を知ることは、より効率的で洗練されたソフトウェアを開発するための強力な武器になるはずです。