コンピュータのCPUがメモリ上のデータにアクセスする際、どの場所(アドレス)のデータを読み書きするかを指定する方法を「アドレス指定方式」と呼びます。
その中でも、プログラミングにおける配列の処理などで非常に重要な役割を果たすのがインデックスアドレス指定(指標アドレス指定)です。
この記事では、インデックスアドレス指定の基本的な仕組みから、計算方法、そして実際のCPU内部での動作原理までを詳しく解説します。
現代のコンピュータアーキテクチャを理解する上で欠かせないこの技術について、初心者の方にもわかりやすく紐解いていきましょう。
インデックスアドレス指定(指標アドレス指定)とは?
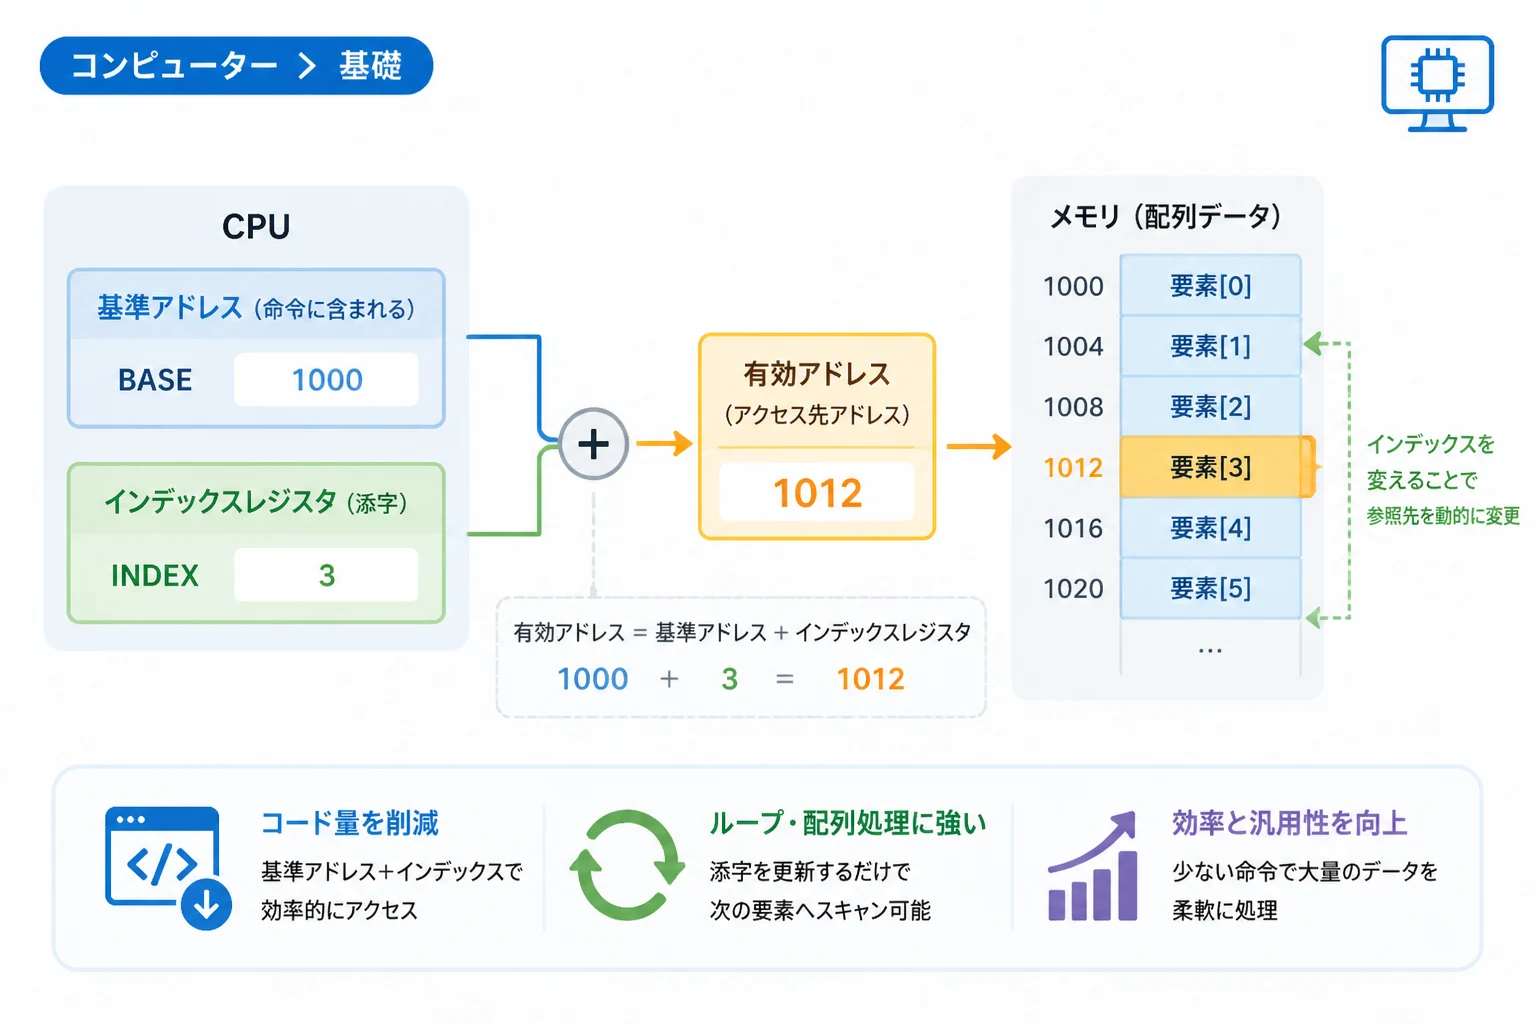
インデックスアドレス指定とは、命令の中に含まれるアドレスの値に、特定のレジスタの内容を加算して最終的なメモリアドレスを決定する方式のことです。
このときに使用される専用のレジスタは、インデックスレジスタ(指標レジスタ)と呼ばれます。
この方式の最大の特徴は、プログラムの実行中にインデックスレジスタの値を書き換えることで、参照先のアドレスを動的に変更できる点にあります。
例えば、大量のデータが並んでいるメモリ領域を順番にスキャンするような処理において、この指定方式は極めて高い効率を発揮します。
指標アドレス指定という名称は、主に日本の情報処理技術者試験などの学術的な文脈で使われることが多く、実務レベルではインデックスアドレス指定と呼ぶのが一般的です。
CPUが命令を実行する際、メモリからデータを取ってくる「データフェッチ」の段階でこの計算が行われます。
アドレス指定方式が必要な理由
なぜ直接アドレスを指定するだけでなく、このような複雑な指定方式が必要なのでしょうか。
それは、プログラムが扱うデータの場所が、常に固定されているわけではないからです。
もし直接アドレス(絶対アドレス)しか指定できなければ、データの場所が変わるたびにプログラム自体を書き換えなければなりません。
アドレス指定方式を柔軟に使い分けることで、ソフトウェアの再利用性や汎用性が飛躍的に高まります。
インデックスアドレス指定の仕組みと計算方法
インデックスアドレス指定において、実際にアクセスされるメモリの場所を有効アドレス(実効アドレス)と呼びます。
有効アドレスの算出式は、非常にシンプルに表現することができます。
有効アドレス = 命令コード内のアドレス部(基準アドレス) + インデックスレジスタの値
例えば、命令の中で「アドレス1000」が指定されており、インデックスレジスタの値が「5」であれば、有効アドレスは「1005」となります。
このように、固定されたベースの値に対して「何番目か」というオフセットを加える動作が、この方式の核心です。
有効アドレス算出のプロセス
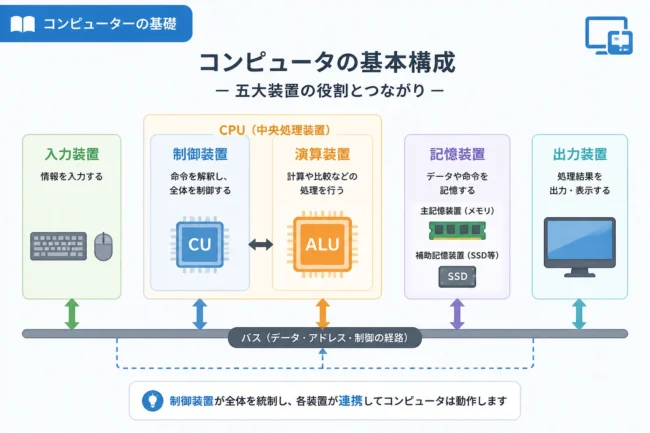
CPUの内部では、制御装置が命令をデコード(解読)した際、それがインデックスアドレス指定であることを認識します。
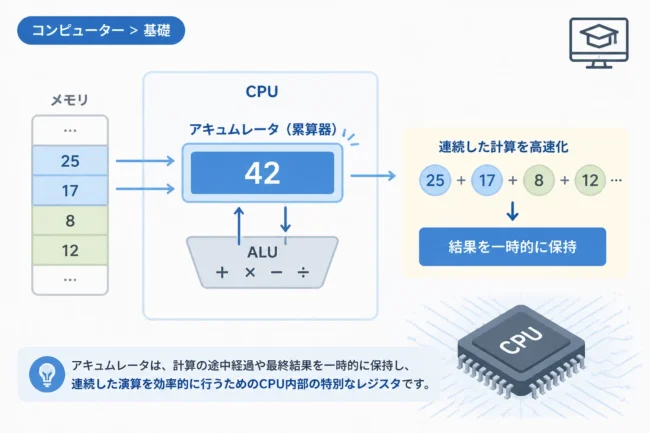
次に、算術論理演算装置(ALU)が、命令レジスタにあるアドレス値とインデックスレジスタの値を足し合わせます。
この計算結果がアドレスバスに出力され、メモリユニットに対して特定の番地へのアクセスを要求します。
この一連の流れはハードウェアレベルで高速に行われるため、プログラム上で複雑な計算式を書くよりも高速に処理されます。
ベースアドレス指定との違い
よく混同される方式に「ベースアドレス指定方式」がありますが、これらは目的が異なります。
以下の表で、その主な違いを確認してみましょう。
| 方式名 | 主な加算対象 | 主な利用目的 |
|---|---|---|
| インデックスアドレス指定 | インデックスレジスタ | 配列要素の参照やループ処理 |
| ベースアドレス指定 | ベースレジスタ | プログラムの再配置(リロケータブル) |
| 相対アドレス指定 | プログラムカウンタ(PC) | 近傍の命令への分岐(ジャンプ) |
ベースアドレス指定はプログラム全体がメモリのどこに配置されても動くようにするために使われるのに対し、インデックスアドレス指定はデータ構造の中身を操作するために使われます。
指標アドレス指定が利用される主なシーン
インデックスアドレス指定が最も威力を発揮するのは、配列(アレイ)構造のデータを扱うときです。
プログラミング言語で array[i] と記述した場合、コンパイル後のマシン語レベルでは多くの場合この方式が採用されます。
配列の先頭アドレスを固定値として命令に含め、添字(index)を変数としてインデックスレジスタに格納する仕組みです。
ループ処理における効率化
例えば、100個のデータが入った配列の合計を求める処理を考えてみましょう。
インデックスレジスタの値を「0」から「99」まで1ずつ増やしながら、同じ命令を繰り返すだけで済みます。
もしこの方式がなければ、100個の異なるアドレスを記述した100行の命令を書く必要が出てきてしまいます。
プログラムのコード量を劇的に削減し、かつ構造をシンプルに保つことができるのです。
文字列処理での活用
文字列も文字データの配列であるため、同様の仕組みが利用されます。
特定の文字を検索したり、大文字を小文字に変換したりする際、ポインタのようにメモリを順次参照していく動作を支えています。
プログラミングやCPU設計におけるメリット
インデックスアドレス指定を導入することで、コンピュータシステム全体に複数のメリットがもたらされます。
第一に、命令の短縮化が挙げられます。
巨大なメモリアドレスをすべて命令の中に含めると命令長が長くなりますが、レジスタを活用することでコンパクトな命令セットを維持できます。
第二に、実行時の柔軟性です。
プログラムの実行結果に応じて次にアクセスする場所を決めたい場合、レジスタの値を演算するだけで対応可能です。
コードの簡素化
アセンブリ言語レベルでのプログラミングにおいて、インデックス指定は開発者の負担を大きく軽減します。
定数としてのアドレス管理を減らし、ロジックに集中できる環境を提供します。
メモリ効率の向上
同じ命令を何度も再利用できるため、命令キャッシュのヒット率が向上し、システム全体のパフォーマンスが底上げされます。
実装例(アセンブリ言語の視点)
概念をより具体的に理解するために、仮想的なアセンブリ言語での例を見てみましょう。
以下のコードは、配列の先頭アドレスからインデックスレジスタ分だけ離れたデータを読み込むイメージです。
; 初期化
MOV IX, 0      ; インデックスレジスタ(IX)に0をセット
MOV AL, [1000 + IX] ; アドレス1000番地 + IXの内容のデータをALレジスタにロード

; 更新
INC IX         ; IXを1増やす
MOV AL, [1000 + IX] ; これで自動的に1001番地のデータを参照できる
このように、命令文(MOV AL, [1000 + IX])自体は全く書き換わっていない点に注目してください。
レジスタの値を変えるだけで、参照するメモリ領域を自由自在に操ることができます。
現代のプロセッサにおける扱い
現代のx86-64アーキテクチャやARMプロセッサでは、さらに高度なアドレッシングモードが実装されています。
例えば、「スケーリング付きインデックスアドレス指定」というものがあります。
これは、インデックスレジスタの値に2倍、4倍、8倍といった倍率を自動的に掛けてから加算する方式です。
これは、データの型(整数型なら4バイト、浮動小数点型なら8バイトなど)に合わせて、アドレスの飛び越し幅を自動調整するために使われます。
ハードウェアが型サイズを意識したアドレス計算を代行してくれるため、コンパイラの最適化がより効きやすくなっています。
RISCとCISCでの違い
x86のようなCISC(複雑命令セットコンピュータ)では、一つの命令で複雑なインデックス計算を行える傾向があります。
一方で、ARMのようなRISC(縮小命令セットコンピュータ)では、基本的な計算を組み合わせることで同様の動作を実現しますが、専用のインデックス付きロード・ストア命令を持つことも多いです。
まとめ
インデックスアドレス指定(指標アドレス指定)は、命令内の基準アドレスとレジスタの値を足し合わせることで、柔軟なメモリ探索を可能にする技術です。
配列や構造体といったデータ集合を効率よく扱うために、現代のコンピュータにおいても中核的な役割を担っています。
この仕組みを理解することで、プログラミング言語の「変数」や「ポインタ」、「配列」が、物理的なハードウェア上でどのように処理されているかの解像度が高まります。
効率的なアルゴリズムや、CPUのボトルネックを意識した開発を行う際、こうした低レイヤの知識は必ず大きな武器となるでしょう。
普段何気なく使っているコードの裏側で、インデックスレジスタが休むことなくアドレスを計算し続けていることを意識してみると、コンピュータへの理解がより一層深まるはずです。