現代のコンピュータにおいて、CPUの性能を最大限に引き出すための技術は多岐にわたります。
私たちが普段意識することなく、スマートフォンやパソコンをスムーズに操作できている背景には、命令処理を効率化する高度な仕組みが備わっています。
その中でも、プロセッサの処理速度を飛躍的に向上させた画期的な手法が「アウトオブオーダー実行(Out-of-Order Execution)」です。
この技術は、プログラムに書かれた命令の順番をあえて入れ替えて実行するという、一見すると大胆なアプローチをとっています。
本記事では、アウトオブオーダー実行の基礎知識から、その具体的な仕組み、メリット、さらには現代の半導体設計における重要性までを詳しく解説します。
アウトオブオーダー実行とは何か?
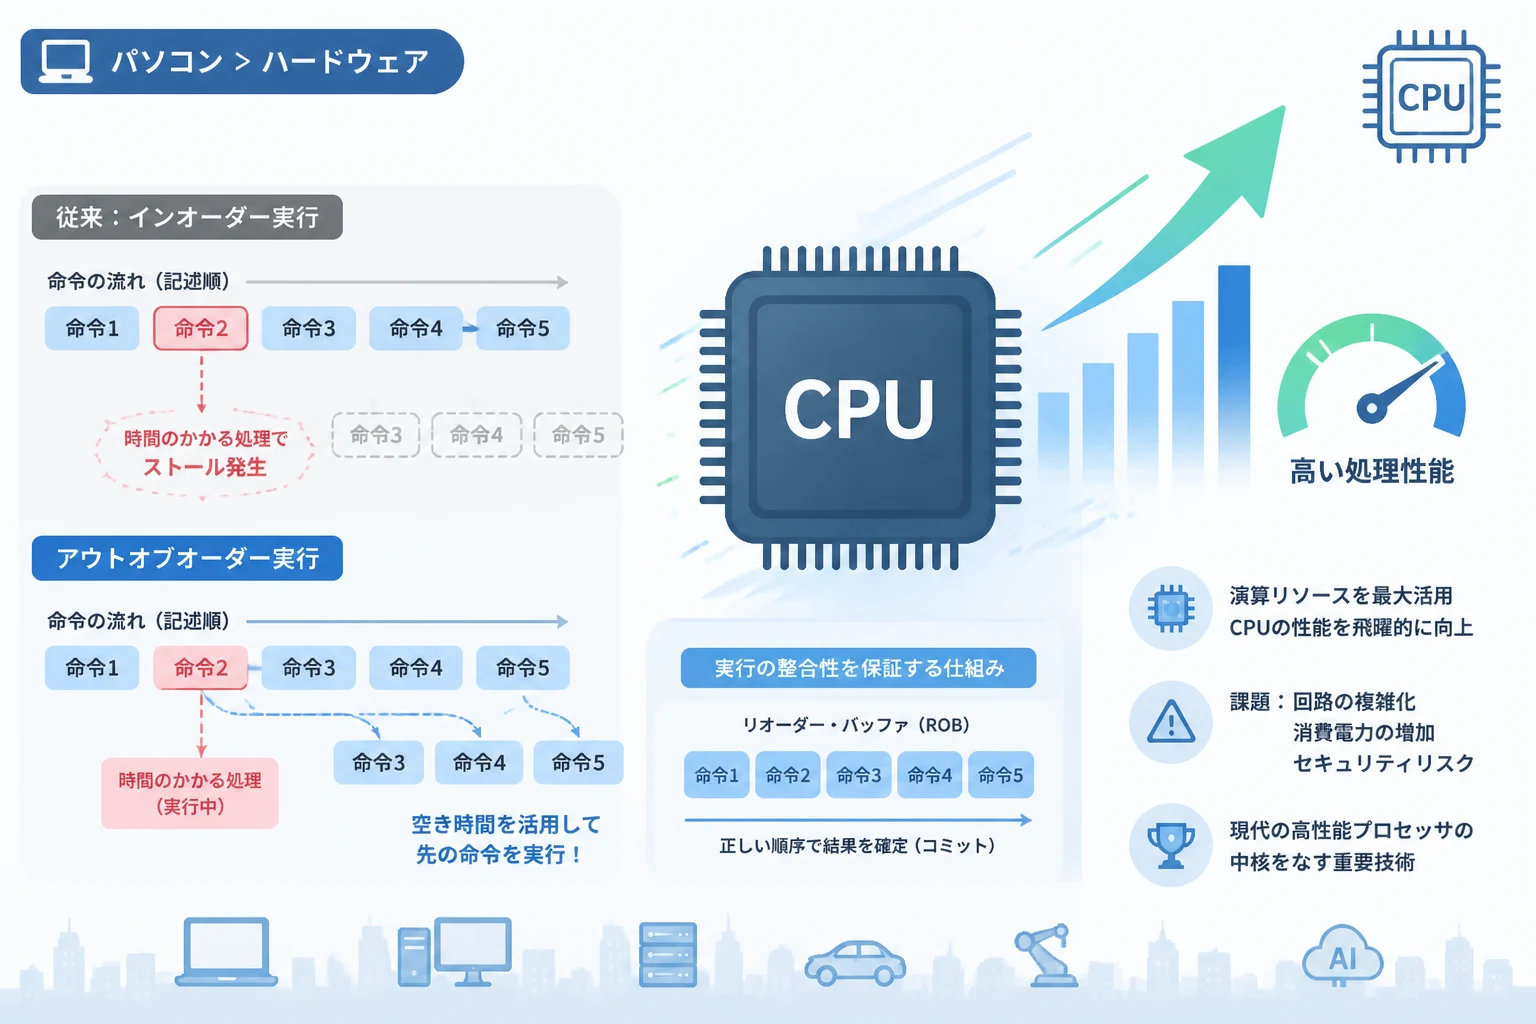
アウトオブオーダー実行とは、CPUがプログラム上の命令を記述された順序通りではなく、「実行準備が整った命令から順に処理していく」方式のことです。
従来の初期のプロセッサでは、プログラムの1行目から順番に処理を進める「インオーダー実行」が一般的でした。
しかし、インオーダー方式では、ある命令の処理に時間がかかると、その後ろに控えている命令がすべて足止めを食らってしまうという問題がありました。
アウトオブオーダー実行は、この「待ち時間」を有効活用するために考案された仕組みです。
例えるなら、料理のレシピで「お湯を沸かす」という工程の次に「野菜を切る」という工程があった場合、お湯が沸くのをじっと待つのではなく、その間に野菜を切ってしまうようなイメージです。
このように、論理的な整合性を保ちつつ処理順序を最適化することで、CPU内部の演算ユニットを常に稼働させることが可能になります。
現在、IntelやAMDの高性能CPU、あるいはAppleのApple Siliconなど、主要な高性能プロセッサのほとんどがこのアウトオブオーダー実行を採用しています。
インオーダー実行との決定的な違い
アウトオブオーダー実行の利点を理解するためには、対比となる「インオーダー実行」の動作を知る必要があります。
以下の表は、それぞれの実行方式の主な特徴を比較したものです。
| 特徴 | インオーダー実行 | アウトオブオーダー実行 |
|---|---|---|
| 処理の順番 | プログラムに書かれた順番通り | 準備ができた命令から順に実行 |
| リソースの活用 | 依存関係や遅延に弱く、空きが生じやすい | 空いている演算器を最大限に活用する |
| 回路の複雑さ | 単純で設計が容易 | 非常に複雑で制御回路が大きくなる |
| 消費電力 | 比較的低い | 制御コストがかかるため高い傾向にある |
| 主な用途 | 組み込み機器、省電力向けプロセッサ | PC、サーバ、スマートフォンなどの高性能SoC |
インオーダー実行の場合、例えば「メモリからデータを読み込む」という命令が実行されたとき、データの到着に数百サイクルかかることがあります。
この間、後続の命令がそのデータを使わないものであったとしても、CPUは次の命令に進むことができず、処理がストップしてしまいます。
これを「ストール」と呼びます。
一方、アウトオブオーダー実行では、メモリ待ちが発生している間に、その先の命令の中で実行可能なものを見つけ出し、先に終わらせてしまいます。
このアプローチにより、ストールによる損失を最小限に抑え、CPUの「スループット(単位時間あたりの処理量)」を大幅に向上させているのです。
アウトオブオーダー実行が動作する仕組み
アウトオブオーダー実行は、単に順番をバラバラにするだけではありません。
プログラムの結果が変わってしまわないよう、非常に緻密なステップを経て制御されています。
一般的なスーパースケーラ・プロセッサにおける実行の流れを順に見ていきましょう。
1. 命令のフェッチとデコード(Fetch & Decode)
まず、CPUはメモリからプログラムの命令を読み込みます。
この段階では、まだ命令は順番通り(インオーダー)に並んでいます。
デコード段階では、複雑な命令がプロセッサ内部で扱いやすい小さな単位である「マイクロ操作(uOPs)」に分解されます。
2. レジスタ・リネーミング(Register Renaming)
アウトオブオーダー実行における最も重要な技術の一つが、この「レジスタ・リネーミング」です。
プログラムが使用するレジスタ(一時的な記憶場所)の数は限られており、複数の命令が同じレジスタ名を使い回すことがあります。
これによって「前の命令が書き込むまで次の命令が待たなければならない」という偽の依存関係が生じます。
CPUは内部に持っている大量の物理レジスタを論理レジスタに割り当て直すことで、見かけ上の依存関係を解消し、並列実行できる命令を増やします。
3. 命令の発行(Dispatch / Issue)
デコードされ、リネーミングが終わった命令は、「インストラクション・ウィンドウ」または「リザベーション・ステーション」と呼ばれる待機所に送られます。
ここで命令は、必要なデータ(オペランド)がすべて揃うのを監視します。
データの準備が整った命令から順に、空いている実行ユニット(整数演算器や浮動小数点演算器など)へと送り出されます。
このタイミングが、まさに「アウトオブオーダー(順不同)」になる瞬間です。
4. 実行(Execute)
各実行ユニットが実際に計算処理やメモリへのアクセスを行います。
複数の実行ユニットが並列して動くため、短い処理は先に終わり、重い処理は時間がかかるといった状況が発生します。
5. 並べ替えと確定(Commit / Retire)
バラバラの順番で終わった計算結果を、そのままメモリやレジスタに書き戻すと、プログラムの論理が崩れてしまいます。
そこで、「リオーダー・バッファ(ROB)」という仕組みを使い、計算結果を一時的にストックしておきます。
最後に、プログラムの元の順番通りに結果を確定(コミット)させていきます。
「実行はバラバラでも、終わらせ方は順番通り」にすることで、ソフトウェアから見た整合性を完全に保っています。
アウトオブオーダー実行を支える主要コンポーネント
この複雑な仕組みを実現するために、CPU内部には専用のハードウェア資源が数多く用意されています。
リザベーション・ステーション(Reservation Station)
命令が実行待ちをするための「待合室」のような役割を果たします。
各命令はここで、自分が必要とする数値が他の命令によって算出されるのを待ち構えています。
数値が届いた瞬間に、即座に実行ユニットへ飛び出すための高度なスケジューリング機能を持っています。
リオーダー・バッファ(Reorder Buffer: ROB)
アウトオブオーダーで実行された命令の「本来の順序」を管理するバッファです。
命令が完了しても、前の命令が終わるまでは結果を正式に反映させずに保持し続けます。
また、分岐予測が外れた場合に、間違った順序で実行してしまった処理を破棄して元に戻す役割も担っています。
分岐予測(Branch Prediction)
アウトオブオーダー実行をさらに加速させるのが「分岐予測」です。
プログラムに「if文」などの分岐がある場合、どちらに進むかを予測して、結果が決まる前に先の命令を投機的に実行(Speculative Execution)してしまいます。
この予測とアウトオブオーダー実行が組み合わさることで、CPUのパイプラインは途切れることなく動き続けることが可能になります。
アウトオブオーダー実行のメリット
なぜ多大な回路コストを払ってまで、アウトオブオーダー実行を導入するのでしょうか。
そこには、現代のコンピューティングに不可欠な大きなメリットがあるからです。
1. CPUリソースの最大活用
現代のCPUは、一つのコアの中に複数の演算器を持っています。
インオーダー実行では一部の演算器が遊んでしまうことが多いですが、アウトオブオーダー実行なら空いている演算器に次々と仕事を割り振ることができます。
2. メモリレイテンシの隠蔽
CPUの演算速度に比べ、メインメモリ(RAM)へのアクセス速度は極めて低速です。
メモリからデータが届くまでの「長い空白時間」の間に、無関係な他の計算を進めておくことで、システム全体の処理遅延を劇的に改善できます。
3. 並列性の自動抽出
プログラマーが明示的に並列処理(マルチスレッドなど)を書かなくても、ハードウェア側が自動的に命令レベルの並列性(ILP)を見つけ出してくれます。
これにより、古いソフトウェアであっても、アウトオブオーダー実行に対応した新しいCPUで動かすだけで高速化の恩恵を受けることができます。
アウトオブオーダー実行の課題とデメリット
非常に強力なアウトオブオーダー実行ですが、万能というわけではありません。
いくつかのトレードオフが存在します。
1. 消費電力と発熱の増加
命令の依存関係をチェックし、実行順序を管理するためのロジック回路は非常に複雑です。
この制御回路自体が電力を消費し、熱を発するため、電力効率が重視される超低電力デバイスでは採用が難しい場合があります。
2. 回路面積の増大
リオーダー・バッファやリザベーション・ステーション、大量の物理レジスタなどは、半導体上の大きな面積を占有します。
これは製造コストの増加に直結するため、チップの価格に影響を与えます。
3. セキュリティ上のリスク
近年話題となった「Spectre(スペクター)」や「Meltdown(メルトダウン)」といったCPUの脆弱性は、このアウトオブオーダー実行や投機的実行の仕組みを突いたものでした。
「本来アクセスしてはいけないデータ」を先読み実行した際、その痕跡がキャッシュメモリに残ってしまう特性が悪用されたのです。
現在のCPUではハードウェアおよびOSレベルでの対策が進んでいますが、高速化とセキュリティの両立は依然として重要なテーマとなっています。
現代のプロセッサにおける重要性
かつてアウトオブオーダー実行は、スーパーコンピュータやハイエンドワークステーション専用の技術でした。
しかし、半導体の微細化が進んだことで、今では手のひらサイズのスマートフォンに搭載されるArmアーキテクチャのプロセッサでも当たり前のように使われています。
例えば、Appleの「Aシリーズ」や「Mシリーズ」のチップは、非常に巨大なアウトオブオーダー・ウィンドウを持つことで知られており、それが圧倒的なシングルコア性能の源泉となっています。
一方で、電力効率を極限まで追求する小型のセンサー向けマイコンなどでは、あえてインオーダー実行を採用することで消費電力を抑えるという使い分けも行われています。
このように、アウトオブオーダー実行は「性能」と「効率」のバランスを決定づける、プロセッサアーキテクチャの核心部分と言えるでしょう。
まとめ
アウトオブオーダー実行は、プログラムの命令を準備が整ったものから順に処理することで、CPUの待ち時間を排除し高速化を図る技術です。
インオーダー実行のような「順番待ち」の非効率を解消し、CPU内部の演算リソースを余すことなく活用することを可能にしました。
レジスタ・リネーミングやリオーダー・バッファといった高度な周辺技術に支えられ、今日のデジタル社会の高速なコンピューティングが実現されています。
消費電力やセキュリティといった課題は存在するものの、現代の高性能半導体設計において、この仕組みなしにさらなる性能向上を望むことはできません。
私たちが毎日使っているデバイスの裏側で、この驚異的な「順番の入れ替え」がミリ秒以下の単位で行われているのです。
CPUの進化を支えるこの基本原理を理解することは、最新のIT技術や半導体ニュースをより深く読み解くための大きな助けとなるでしょう。