現代のビジネス環境において、サイバー攻撃を完全に防ぐことは極めて困難な課題となっています。
多くの企業が強固な防御壁を築いていますが、それでも脆弱性を突いた攻撃や高度な標的型攻撃による侵入をゼロにすることはできません。
このような状況下で重要視されているのが、「インシデントレスポンス(IR)」という考え方です。
インシデントレスポンスとは、万が一セキュリティ事故が発生した際に、その被害を最小限に抑え、迅速な復旧を図るための一連の対応プロセスを指します。
本記事では、インシデントレスポンスの定義から具体的な対応フロー、効果的な体制構築のポイントまでを詳しく解説します。
インシデントレスポンス(IR)の定義と重要性
インシデントレスポンスとは、情報システムやネットワークにおいてセキュリティ上の問題が発生した際に、組織が実施する応急処置や調査、復旧活動の総称です。
ここでの「インシデント」とは、マルウェア感染、不正アクセス、情報漏えい、Webサイトの改ざん、サービス停止(DoS攻撃)などを指します。
従来型のセキュリティ対策は「いかに侵入を防ぐか」という境界線防御に主眼が置かれていました。
しかし、攻撃手法の巧妙化に伴い、侵入されることを前提とした「事後対応」の質が企業の命運を分けるようになっています。
インシデント発生時に対応が遅れると、被害範囲の拡大、顧客情報の流出、社会的信用の失墜、巨額の賠償金支払いといった深刻な事態を招きかねません。
そのため、あらかじめ対応手順を策定し、有事に即座に動ける体制を整えておくことが不可欠です。
インシデントレスポンスの最終的な目的は、単に問題を解決するだけでなく、ビジネスの継続性を確保し、再発を防止することにあります。
インシデントレスポンスとCSIRTの関係
インシデントレスポンスを専門に担う組織やチームのことを、一般的にCSIRT(シーサート:Computer Security Incident Response Team)と呼びます。
CSIRTは、社内で発生したインシデント情報の集約、分析、対応指示を行う司令塔の役割を果たします。
一方、インシデントレスポンスはそのチームが実行する「活動そのもの」を指す言葉です。
効果的なレスポンスを実現するためには、明確な役割分担がなされたCSIRTの存在が欠かせません。
インシデントレスポンスの標準的な対応フロー
インシデントレスポンスを体系化するために、米国立標準技術研究所(NIST)が発行している「SP 800-61」というガイドラインが広く参照されています。
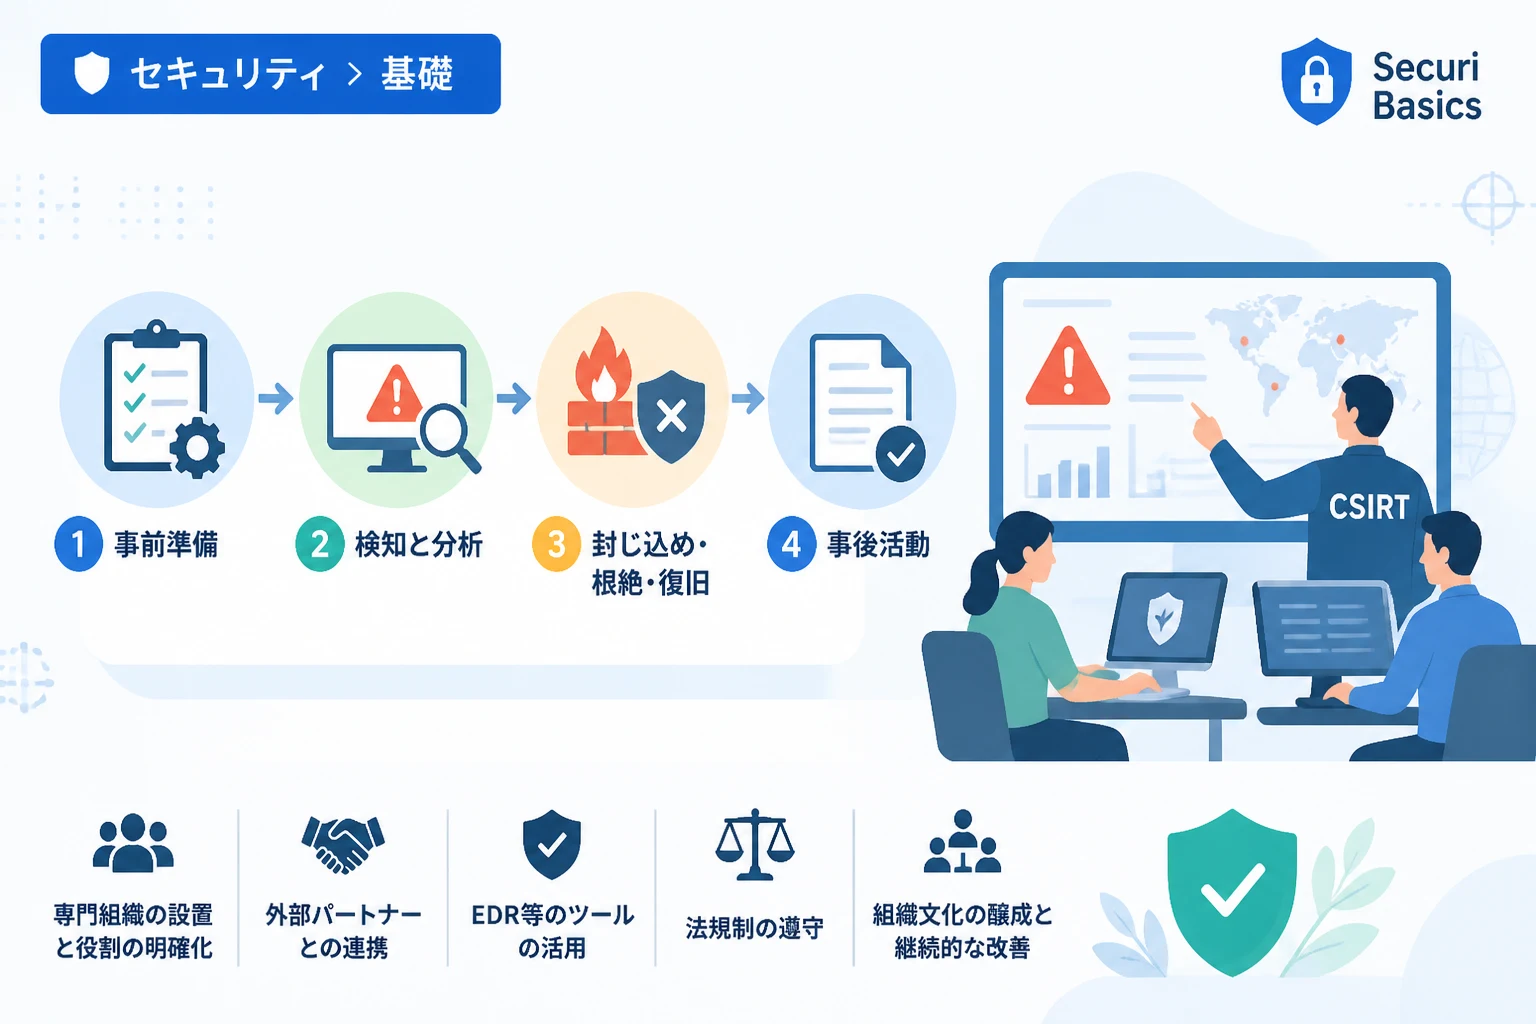
このガイドラインでは、インシデント対応を以下の4つのフェーズに分けて定義しています。
フェーズ1:事前準備(Preparation)
インシデントが発生してから慌てるのではなく、事前に対応能力を高めておくフェーズです。
具体的には、インシデント対応方針(ポリシー)の策定や、対応マニュアルの作成が含まれます。
また、インシデントを検知するためのログ監視システムの構築や、バックアップ体制の整備もこの段階で行います。
さらに、従業員に対するセキュリティ教育や、CSIRTメンバーによる疑似演習も重要な準備活動です。
準備が不十分な状態では、いざ問題が起きた際に「誰が何をすべきか」が分からず、混乱を招くことになります。
フェーズ2:検知と分析(Detection and Analysis)
異常を早期に発見し、その内容が本当にセキュリティインシデントであるかを判断するフェーズです。
IDS/IPS(侵入検知・防止システム)やEDR(Endpoint Detection and Response)などのツールから発せられるアラートを監視します。
検知された事象が誤検知(フォールスポジティブ)ではないかを確認し、影響範囲を特定します。
この際、インシデントの緊急度や優先順位を決定する「トリアージ」が極めて重要になります。
すべての事象に全力で対応することは難しいため、リスクの高いものからリソースを割く必要があります。
フェーズ3:封じ込め・根絶・復旧(Containment, Eradication, and Recovery)
被害の拡大を防ぎ、脅威を取り除いて元の状態に戻す実務的なフェーズです。
まず「封じ込め」として、感染した端末をネットワークから切り離すなどの応急処置を行います。
次に「根絶」として、原因となったマルウェアの削除や、脆弱性のパッチ適用、不正なアカウントの削除を実施します。
最後に「復旧」として、バックアップデータからのシステム復元や、正常な動作の確認を行います。
このフェーズでは、証拠保全(フォレンジック)を意識しながら作業を進めることが求められます。
フェーズ4:事後活動(Post-Incident Activity)
一連の対応が終わった後、今回の対応を振り返り、将来の対策に活かすフェーズです。
「なぜインシデントが発生したのか」「対応手順に不備はなかったか」を分析した報告書を作成します。
このプロセスを通じて得られた教訓をもとに、フェーズ1の「事前準備」をアップデートしていきます。
このサイクルを回し続けることで、組織のセキュリティレジリエンス(回復力)が高まります。
セキュリティインシデントの主な種類と特徴
適切なレスポンスを行うためには、どのような攻撃が存在するのかを把握しておく必要があります。
代表的なインシデントの種類を以下の表にまとめました。
| インシデントの種類 | 概要 | 主な対応策 |
|---|---|---|
| マルウェア感染 | ウイルスやランサムウェアに感染し、データ破壊や暗号化が行われる。 | 端末の隔離、ウイルススキャン、データリストア。 |
| 不正アクセス | 脆弱性や盗まれたIDを使い、権限のない第三者がシステムに侵入する。 | パスワード変更、アカウント凍結、脆弱性パッチ適用。 |
| DoS/DDoS攻撃 | 大量のトラフィックを送りつけ、サービスの継続を妨害する。 | IP制限、WAFの活用、CDNによるトラフィック分散。 |
| 情報漏えい | 機密情報や個人情報が外部へ流出する。 | 流出経路の特定、影響範囲の調査、法的機関への報告。 |
効果的なインシデントレスポンス体制(CSIRT)の構築方法
インシデントレスポンスを成功させるためには、組織的な体制づくりが不可欠です。
単にIT部門の担当者を割り当てるだけではなく、全社的な視点での構築が求められます。
1. 役割と責任の明確化
CSIRT内でのリーダー、アナリスト、技術担当といった役割を明確にします。
また、IT部門だけでなく、広報、法務、人事、経営層との連携ルートを事前に確立しておく必要があります。
例えば、個人情報が漏えいした場合には、法務による法的判断や広報による対外発表が不可欠になるからです。
2. 外部パートナーとの連携
自社リソースだけで高度なサイバー攻撃にすべて対応するのは困難です。
セキュリティベンダーやフォレンジックの専門会社と、事前に保守契約や提携を結んでおくことが推奨されます。
有事の際にすぐに専門家のサポートを受けられる体制は、復旧までの時間を大幅に短縮します。
3. コミュニケーションパスの整備
インシデント発生時は、混乱の中で正確な情報を共有する必要があります。
社内チャット、電話、緊急用メールなど、複数の連絡手段を確保しておきましょう。
また、情報の集約先を一箇所に絞ることで、指示系統の混乱を防ぐことができます。
インシデントレスポンスを支援する技術とツール
迅速かつ正確な対応を行うためには、テクノロジーの活用が欠かせません。
現代のセキュリティ現場で活用されている主なツールを紹介します。
SIEM(Security Information and Event Management)
SIEMは、サーバー、ネットワーク機器、セキュリティソフトなどから出力されるログを一元的に収集・分析するシステムです。
複数のログを相関分析することで、単体では気づけない微かな攻撃の予兆を検知できます。
EDR(Endpoint Detection and Response)
PCやサーバーなどの「エンドポイント」での挙動を詳細に監視するツールです。
万が一侵入を許しても、その後の不審な動きを検知してプロセスの停止やネットワーク隔離をリモートで行えます。
SOAR(Security Orchestration, Automation and Response)
セキュリティ運用の自動化と効率化を支援するプラットフォームです。
定型的なレスポンス作業(IPアドレスのブロックやチケット発行など)を自動化し、人の判断が必要な部分に集中できる環境を作ります。
プレイブックの作成:対応の標準化
インシデントの種類ごとに「何をすべきか」をフローチャート化したものをプレイブックと呼びます。
プレイブックがあることで、担当者のスキルに依存せず、常に一定水準以上の対応が可能になります。
以下に、単純なログイン試行エラーを検知した際の自動化スクリプトの例(概念)を示します。
# 不審なログイン試行を検知した際の自動制限スクリプト例
def handle_login_incident(user_id, attempt_count):
    # 連続失敗回数が5回を超えた場合
    if attempt_count > 5:
        print(f"Alert: Excessive login failures for user {user_id}")
        # アカウントを一時ロックする関数を呼び出し
        lock_account(user_id)
        # 管理者に通知を送る
        notify_admin(user_id, "Potential Brute Force Attack")
    else:
        print("Monitoring in progress...")

def lock_account(user_id):
    # アカウントステータスを'Locked'に変更する処理
    pass

def notify_admin(user_id, reason):
    # 管理用メールまたはSlack等に通知を飛ばす処理
passAlert: Excessive login failures for user user01
Account locked. Notification sent to administrator.インシデントレスポンスにおける法規制とコンプライアンス
インシデントレスポンスは技術的な問題解決だけではありません。
特に個人情報の漏えいが発生した場合、法律に基づいた対応が義務付けられています。
日本では「個人情報の保護に関する法律(個人情報保護法)」により、一定の漏えい事案が発生した際には、個人情報保護委員会への報告と本人への通知が義務化されています。
この報告には期限があるため、レスポンスのフローの中に「法的報告のタイミング」を組み込んでおく必要があります。
また、GDPR(欧州一般データ保護規則)など、海外の法規制が適用されるケースもあるため注意が必要です。
コンプライアンスを遵守しない対応は、後に巨額の制裁金や法的制裁を招くリスクがあります。
よくある失敗例と改善のポイント
多くの組織がインシデントレスポンス体制を構築していますが、実戦で機能しないケースも少なくありません。
よくある失敗の一つは、「マニュアルの形骸化」です。
数年前に作成したきり更新されていないマニュアルは、現在の攻撃手法や社内インフラに適応できません。
定期的な見直しと、現実的なシナリオを用いた訓練が必要です。
もう一つの失敗例は、「情報の抱え込み」です。
現場担当者が「自分で解決できる」と判断して報告を遅らせた結果、被害が致命的なレベルまで拡大することがあります。
「どんな些細な違和感でもすぐに報告する」という文化(心理的安全性の確保)を醸成することが、迅速なレスポンスの第一歩です。
今後の展望:AIを活用したレスポンスの進化
サイバー攻撃がAIによって高速化・巧妙化する中、守る側のインシデントレスポンスも進化を続けています。
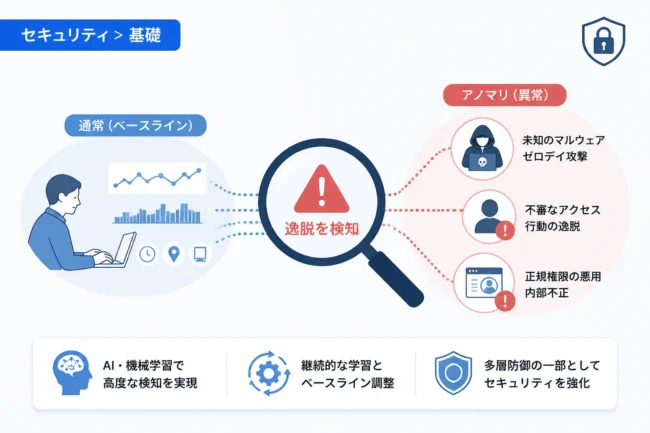
AIや機械学習を活用して、膨大なログから「普段とは異なるパターン」を瞬時に見つけ出す技術が普及しています。
また、生成AIを利用して、インシデントの要約や初動対応のドラフト作成を支援する試みも始まっています。
しかし、最終的な意思決定を行うのは常に人間です。
テクノロジーを使いこなしつつ、人間の判断力を磨き続けることが、これからのインシデントレスポンスには求められます。
まとめ
インシデントレスポンスは、現代のデジタル社会において企業が生き残るための必須機能です。
「攻撃を防ぐ」努力はもちろん重要ですが、それと同時に「攻撃された後にどう動くか」を真剣に検討しなければなりません。
NISTのサイクルに基づいた準備、検知、封じ込め、事後活動のプロセスを組織に定着させましょう。
また、CSIRTの構築やツールの導入、さらには法規制への理解など、多角的なアプローチが必要です。
インシデント対応能力を高めることは、顧客や取引先からの信頼を勝ち取ることにも直結します。
まずは自社の現在の対応体制をチェックし、小さな一歩から改善を始めてみてはいかがでしょうか。
万が一の事態に備え、揺るぎないレスポンス体制を築くことが、ビジネスの持続的な成長を支える基盤となります。